
结论先说
codebase-memory-mcp不是记聊天习惯的笔记工具,而是本地「代码结构图谱」MCP 服务器(代表性官方开源仓库为DeusData/codebase-memory-mcp)。- 它的底层原理是 AST 语法树解析 + 本地 SQLite 图存储:用内置 Tree-sitter 解析器配合轻量类型推导,把函数、类、接口路由抽成节点,把调用(
CALLS)、导入(IMPORTS)、继承(INHERITS)抽成有向边。 - 最大价值是减少大仓库里的无效全文读取:评估「改这个函数会影响哪几处」时,模型直接按跳数查调用图,不用把十几个几百行的源文件整份塞进上下文。
- 全程在本地离线建索引,不需要外部云账号或向量数据库 API;但它属于第三方社区开源二进制程序,安装前应按 MCP 安全审查习惯核对发布来源。
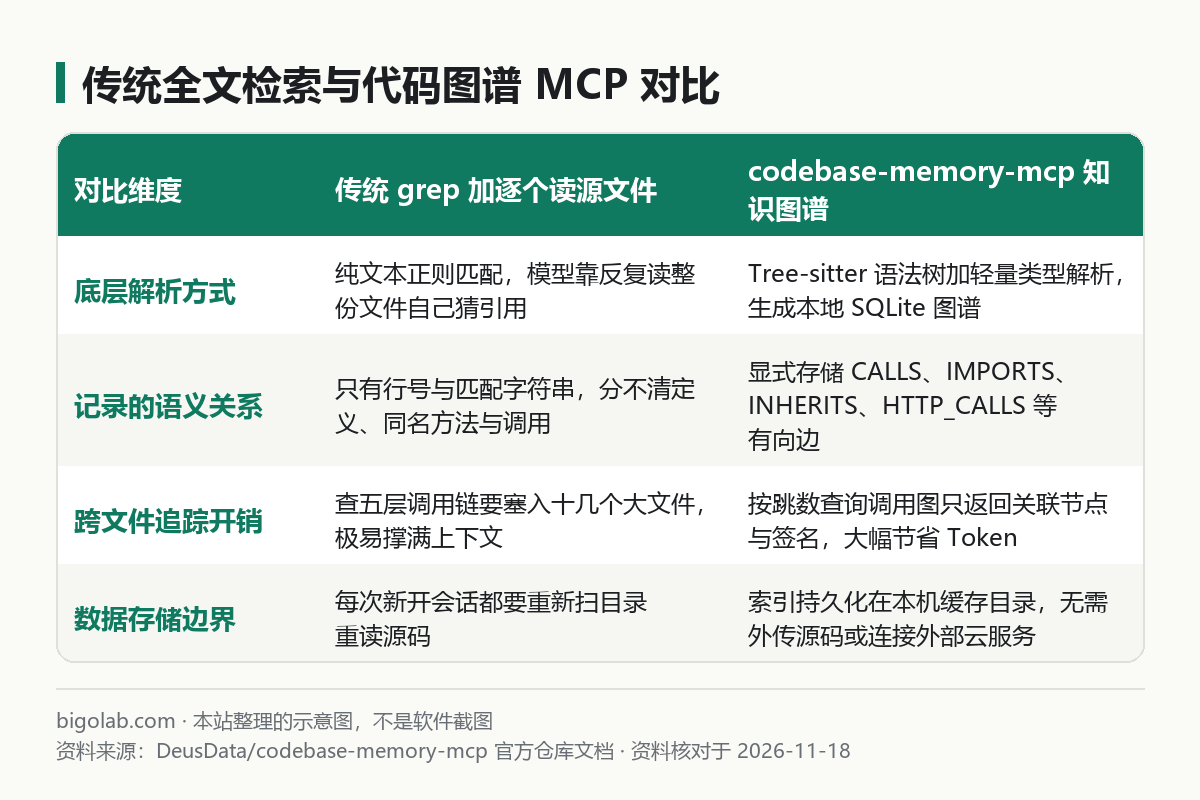
图:本站根据 DeusData/codebase-memory-mcp 官方仓库文档 整理的示意图
本文根据公开开源仓库DeusData/codebase-memory-mcp官方文档与 Claude Code MCP 接入规范整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是相关项目或 Anthropic 官方网站。
适用于谁
- 搜「codebase-memory mcp 是什么」「codebase-memory-mcp 怎么用」的人;
- 维护几十万行以上大仓库或微服务项目,发现 Claude Code、Codex 光是靠
grep找调用链就塞满大半个上下文窗口的开发者; - 分不清「
CLAUDE.md对话记忆」「Context7外部文档检索」和「代码结构知识图谱 MCP」各自管什么的同学。
一、先理清三个容易混淆的概念
名字里都带「记忆」或「检索」,但三类常见工具解决的完全不是一回事:
CLAUDE.md与auto memory:存的是「自然语言规则与踩坑笔记」(比如必须用哪个测试命令、不要动哪个目录),用法见 /guides/claude-md-auto-update-how-to-update;- Context7 等文档类 MCP:查的是「外部第三方开源库和框架的最新官方 API 用法」,见 /guides/claude-code-context7-mcp-latest-docs;
codebase-memory-mcp代码图谱类 MCP:索引的是你当前本地仓库自身的符号调用关系,回答「谁调了这个函数」「这个路由最终落到哪张表」。
在小型项目(几十个文件以内)里,Claude Code 自带的 Grep、Glob 和 Read 已经足够快,没必要额外装图谱服务;只有当项目规模大到频繁跨目录追五六层调用链时,图谱索引省下的上下文额度和等待时间才明显。
二、它是怎么把代码变成知识图谱的
根据 DeusData/codebase-memory-mcp 官方仓库架构说明,该工具用 C 语言编译成无外部运行时依赖的单文件可执行程序,分三层处理你的仓库:
- Tree-sitter 语法树扫描:内置上百种常见编程语言的语法规则,把源码解析成精确的抽象语法树,而不是靠纯文本正则硬匹配(避免把注释或同名局部变量误判成函数调用);
- 轻量类型与跨文件关系解析:针对 TypeScript、Python、Go、Rust、Java 等主流语言做符号与导入绑定,建立
DEFINES(定义)、CALLS(调用)、IMPORTS(导入)、IMPLEMENTS/INHERITS(实现与继承)以及HTTP_CALLS(跨服务接口调用)等关系边; - 本机 SQLite 持久化:解析后的图结构落盘在本机用户缓存目录中。下次新开 Claude Code 会话时直接查询现成索引,不需要每次重扫整个仓库。
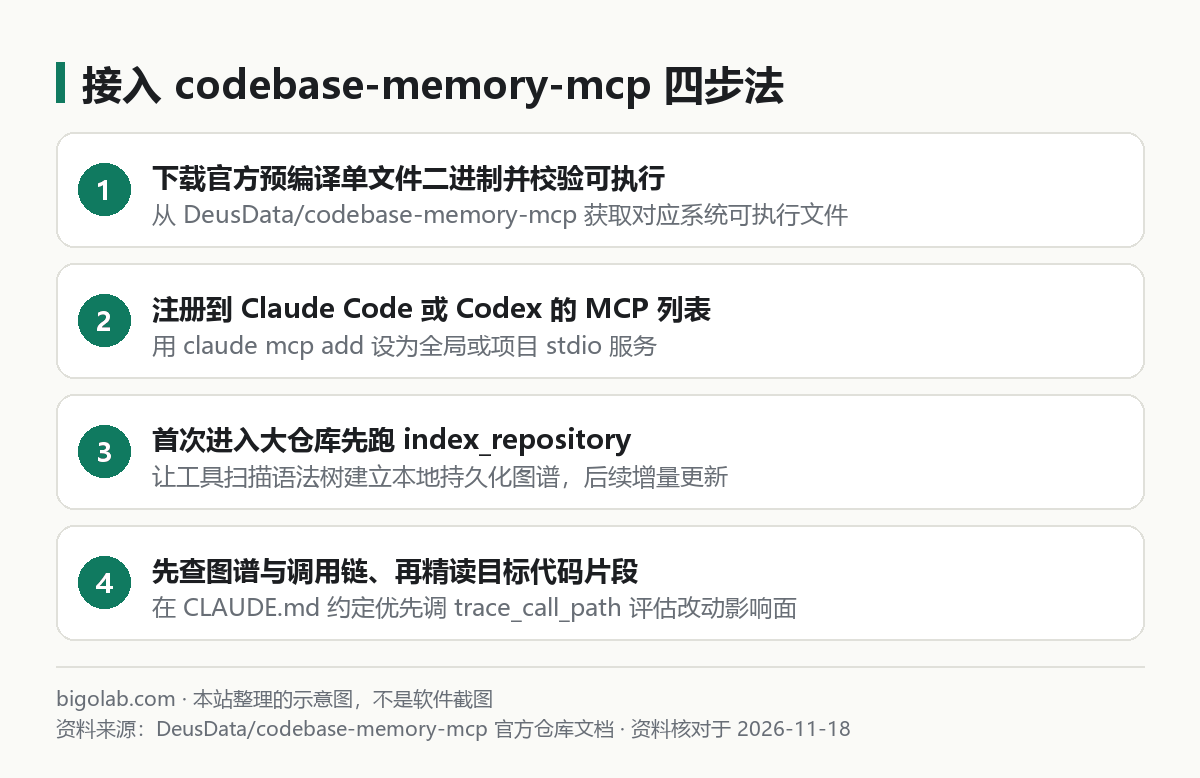
图:本站根据 DeusData/codebase-memory-mcp 官方仓库文档 整理的示意图
三、怎么安装并接到 Claude Code 或 Codex
第一步:审阅来源并获取可执行文件
在安装任何社区 MCP 服务器前,先按 /guides/mcp-servers-how-to-choose-audit 的清单看清仓库维护状态、开源协议与 Release 构建产物。确认无误后,从 DeusData/codebase-memory-mcp 的 GitHub Releases 下载对应操作系统(macOS、Linux 或 Windows)的可执行文件放到本机固定目录,并在类 Unix 系统上赋予可执行权限(chmod +x)。
第二步:用 stdio 方式注册 MCP 服务
在 Claude Code 里把它注册为用户级本地服务(配置细节见 /guides/claude-code-mcp-setup):
bash
claude mcp add codebase-memory -s user -- /你的本地路径/codebase-memory-mcp
如果你同时用 Codex CLI,也可以按相同路径写进 ~/.codex/config.toml 的 mcp_servers 段。
第三步:首次建库与日常调用习惯
进入目标大型仓库启动会话后,按两步配合效果最好:
- 首次初始化索引:直接让编码助手对当前项目调用一次
index_repository(也可以在命令行运行codebase-memory-mcp cli index_repository '{"repo_path":"/项目绝对路径"}'预先建好索引); - 在
CLAUDE.md里写一条简短提示:告诉模型「评估跨模块改动影响面或排查调用链时,优先调用codebase-memory的trace_call_path(指定 1 到 5 跳深度)定位关联函数,确认目标行号后再用Read精读对应片段」。
如果不写这条引导,大模型有时出于惯性还是会先连跑十几次全文 grep。把「先查图谱定位、再按需读源码」固化下来后,复杂重构对单次会话上下文和周限额的压力都会小很多;需要核对 Claude Code 各档订阅本身额度规则的读者,也可参考 /chongzhi/claude-code 页面整理。
常见问题
Q:代码本地刚改了几行,图谱索引会不会过期?
本地持久化图谱针对的是已落盘的文件状态。大范围切换 Git 分支或拉取了大量上游提交后,如果发现返回的符号行号与当前文件对不上,让助手重新触发一次 index_repository 刷新增量索引即可。
Q:它会把我的私有业务源码上传到外部服务器吗?
按 DeusData/codebase-memory-mcp 仓库说明,语法树解析和 SQLite 存储都在本机进程内完成,走的是本地 stdio 标准输入输出通道,不依赖外部云端索引接口。企业高敏环境建议直接从公开源码自行编译审计后再投入使用。
Q:用了它之后还需要写 CLAUDE.md 吗?
需要。代码图谱只能告诉模型「代码现在客观上怎么调的」,没法告诉模型「业务上哪条老链路正在废弃不准新代码再调、提交前必须跑哪条脚本」——这些工程规范仍然要写在 CLAUDE.md 里。
相关教程
- /guides/claude-code-mcp-setup:Claude Code MCP 配置与管理指南
- /guides/mcp-servers-how-to-choose-audit:第三方 MCP 服务器选型与安全审查七步法
- /guides/claude-code-context7-mcp-latest-docs:Context7 MCP 查最新第三方库文档教程
- /guides/claude-md-auto-update-how-to-update:
CLAUDE.md与自动记忆的区别与维护
参考资料
DeusData/codebase-memory-mcp官方 GitHub 仓库 — https://github.com/DeusData/codebase-memory-mcp- Claude Code 官方文档:Connect Claude Code to tools via MCP — https://code.claude.com/docs/en/mcp
0 条评论
还没有评论,来抢沙发~