
结论先说
- 官方没有写 1M 开关。 在模型页、配置参考和桌面 App 设置页里,都没有这样一项设置。别人说「在 App 设置里勾选 1M 上下文」,没有官方出处。
- 官方写了的数字是:GPT-6.1 Sol 在 Codex 和 ChatGPT Work 里默认上下文窗口 500,000 个 token。 其他模型的窗口,官方模型页没有逐一列出,以你在应用里看到的为准。
config.toml里有model_context_window,官方说明是「当前模型可用的上下文窗口 token 数」,示例里默认值是「按模型自动」。官方没有写可以把它设得比模型实际支持的更大。- 长对话靠压缩。
/compact手动压缩,model_auto_compact_token_limit控制自动压缩的阈值。 - 窗口大不等于质量一直好。 官方在子代理说明里写道,即使窗口很大,模型也有限度,主对话里堆满探索笔记、测试日志和命令输出,会话会随时间变得不那么可靠。
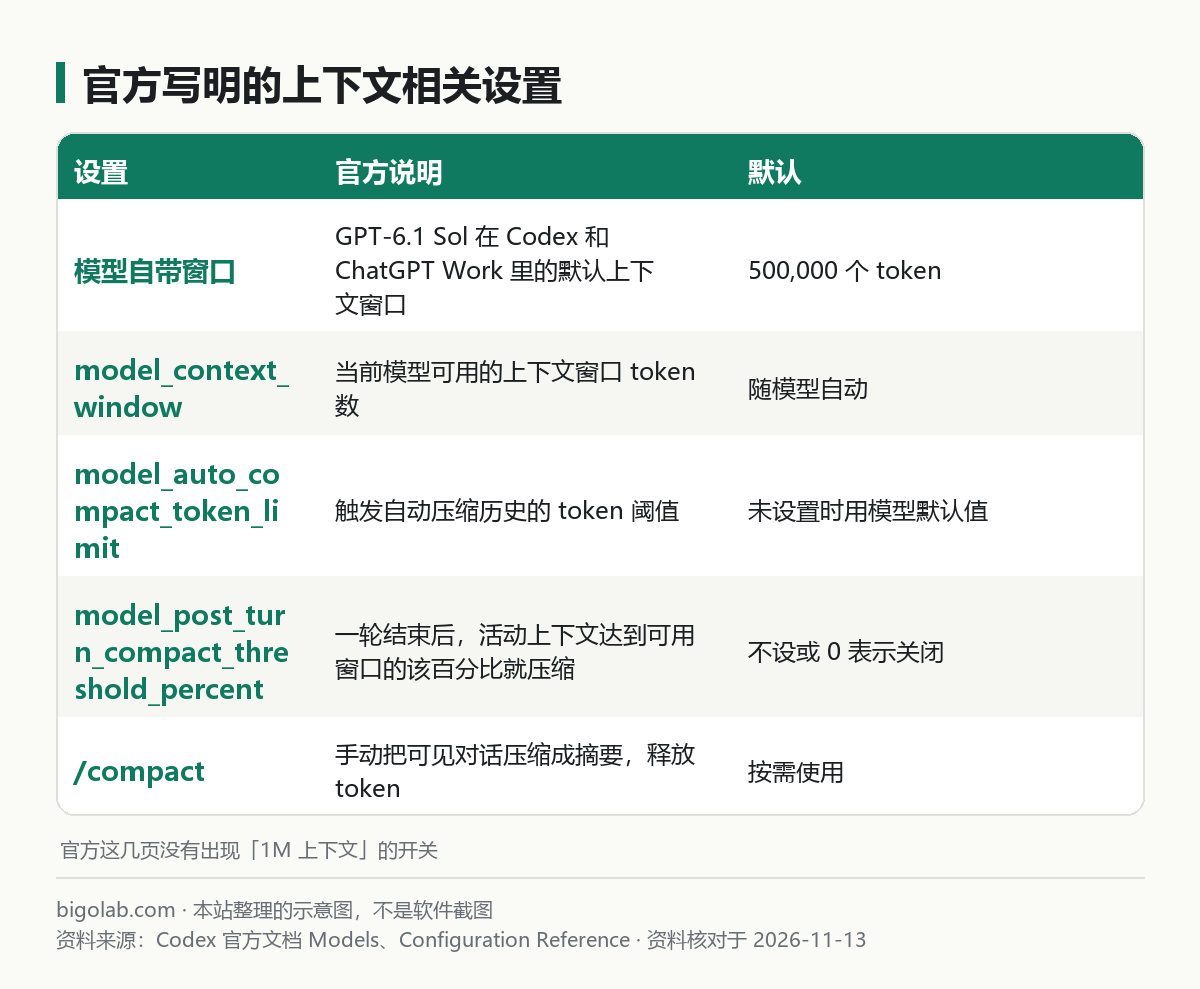
图:本站根据 Codex 官方文档《Models》 和《Configuration Reference》 整理的示意图
本文根据 Codex 官方文档《Models》《Configuration Reference》《Advanced Configuration》和命令页整理,资料核对于 2026-11-13。官方文档里没有「1M 上下文」的设置项,所以本文不提供「改成 1M」的步骤,只写官方能确认的上下文相关设置,以及怎么在不改窗口的情况下让长任务更稳。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 在桌面 App 里做大项目,担心上下文不够,想找「1M 上下文」开关的人;
- 看到网上教程让你改
config.toml,不确定能不能改的人; - 对话越聊越长,想知道怎么让 Codex 保持稳定的人。
一、先查你现在有多少上下文可用
不要先去改,先看现状。官方命令页里:
- 输入
/status,查看当前使用的模型、审批策略、可写目录等; - 输入
/statusline,在底部状态栏里加入需要的项目。官方说明可选项包括模型、模型加推理强度、上下文统计、速率限制、git 分支、token 计数器、会话 ID、当前目录和 Codex 版本。官方示例配置里,上下文相关的项目标识是context-remaining,默认的状态栏就包含它。
这些是命令行里的做法。桌面 App 是否有同样的状态栏显示,官方这几页没有写,以你应用的当天界面为准。
二、config.toml 里有哪些上下文相关的键
官方配置参考列出的几项,括号里是本站的解释:
model_context_window:当前模型可用的上下文窗口 token 数。官方示例注释写的是「默认:按模型自动」,另一处示例写成model_context_window = 128000;model_auto_compact_token_limit:触发自动压缩历史的 token 阈值,未设置时使用模型默认值;model_auto_compact_token_limit_scope:自动压缩的阈值按完整的活动上下文计算(total,默认),还是只算压缩窗口前缀之后的增长部分(body_after_prefix);model_post_turn_compact_threshold_percent:一轮的最终回复之后,如果活动上下文达到可用窗口的这个百分比,就压缩历史;不设置或设为 0 表示关闭,且通常的自动压缩限制仍然适用。官方示例是 80;tool_output_token_limit:每次工具输出保存的 token 数,示例值是 12000。
这些键放在 $CODEX_HOME/config.toml(默认 ~/.codex/config.toml)里。重要提醒:
- 官方没有写
model_context_window可以大于模型实际支持的窗口。如果你写了一个模型并不支持的数,结果官方没有说明,可能被忽略,也可能引起报错,所以不建议这样试; - 如果网上某篇教程写「加上这一行就是 1M」,请先到官方模型页核对你的模型是否真的有这么大的窗口,没有出处就不要照搬;
- 配置文件的位置和读取规则,见官方《Advanced Configuration》;Windows 页写明桌面 App 与原生 Windows 版 Codex 使用同一个家目录
%USERPROFILE%\.codex,由此可以推断 App 同样读取这份配置,但官方没有专门就上下文窗口在 App 里的表现作出说明,这是推断。
三、对话太长了怎么办
1. 手动压缩:/compact
官方命令页:/compact 总结当前可见的对话来释放 token,适合在长时间运行之后使用,让 Codex 保留关键点而不撑爆上下文窗口。执行后,早先的轮次会被一段简明的摘要取代,同时保留关键细节。压缩后细节会变成摘要,所以重要的约束、决定请在压缩前确认已经写进了 AGENTS.md 或计划文件。 写法见 /guides/codex-agents-md-how-it-reads。
2. 自动压缩
不动配置时,Codex 按模型默认值自动处理。想更早触发,可以设置 model_auto_compact_token_limit 或 model_post_turn_compact_threshold_percent。这两项属于进阶调整,官方没有给推荐数值,示例里的数字只是示例。
3. 开新对话
换任务就开新对话。官方在多代理说明里把「上下文污染」和「上下文腐烂」当作问题来讲:有用的信息被噪声埋住,随着对话被不相关的细节填满,表现会下降。新对话是最直接的清理办法。
4. 让子代理读大文件
官方在子代理说明里写道,Codex 可以把分析一份数百万 token 的大文档拆成较小的问题,并把提炼出的要点交回主线程。做法的要点是:主代理专注需求、决定和最终产出;让专门的子代理并行处理探索、测试或日志分析;让子代理返回摘要,而不是原始的中间输出。官方建议先把并行代理用在读多写少的任务上,例如探索、测试、分流和总结。
提示词可以这样写,括号里自己填:
text
请把 [某个目录] 里的日志分给子代理并行分析,每个子代理只返回:出现次数最多的 3 类错误、各一条代表性日志和可能原因。主线程只保留这些摘要,不要贴原始日志。
四、窗口、速度和额度的关系
官方写明,更高的推理强度会增加响应时间和 token 用量;上下文越长,每一轮需要处理的内容也越多。所以窗口大不是免费的:既可能更慢,也会更快消耗额度。慢的排查见 /guides/codex-slow-reconnecting-why,额度怎么看见 /guides/codex-usage-limits。如果你确实经常跑很长的任务、额度不够用,可以看看本站的 ChatGPT Plus 充值说明 或 ChatGPT Pro 充值说明,价格和额度以官方页面当前显示为准。
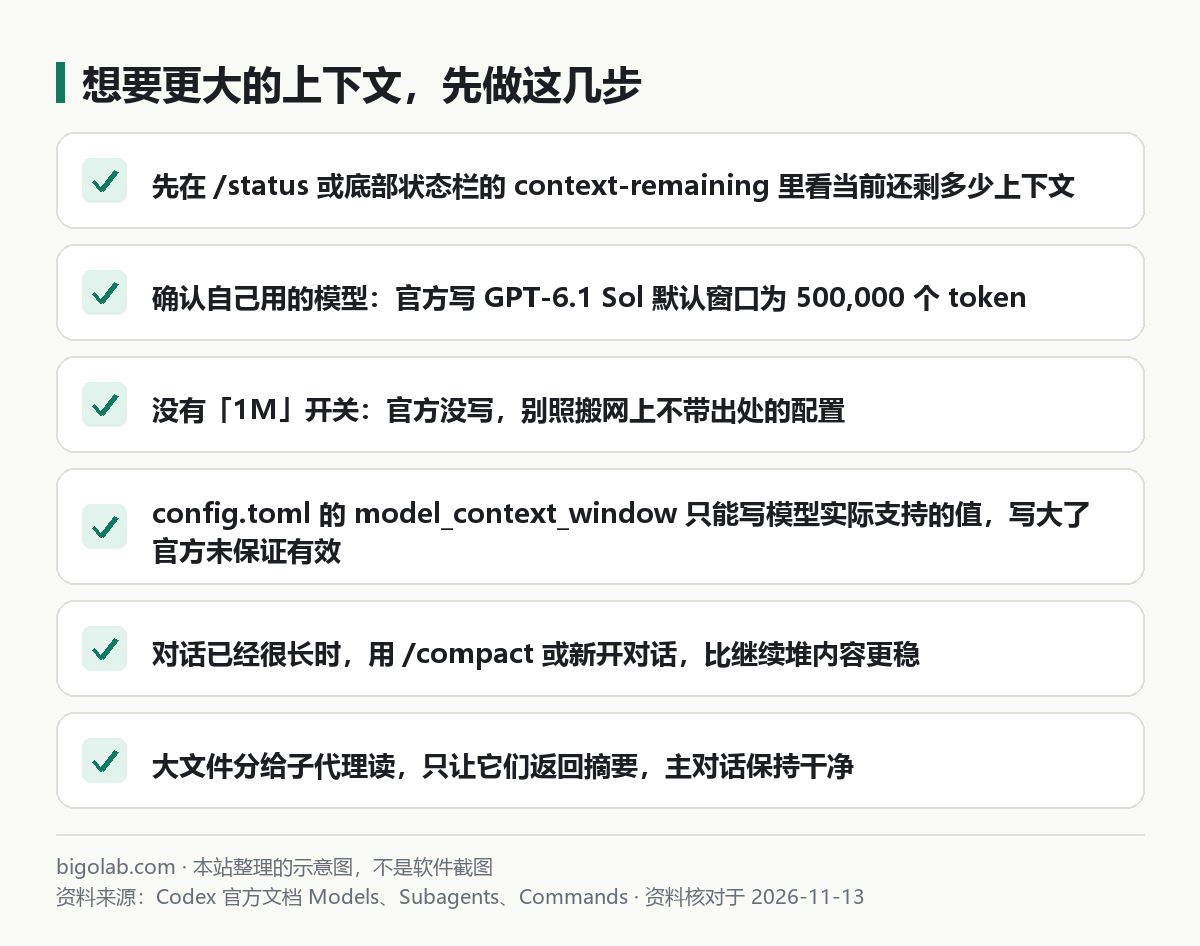
图:本站根据 Codex 官方文档 整理的示意图
五、如果你想用的是本地模型
通过 Ollama 等本地提供方运行时,上下文长度往往要在提供方那边设置,不是 Codex 的开关。这部分见 /guides/ollama-launch-claude-code-codex;自定义模型提供方的配置见 /guides/codex-third-party-models-deepseek-gemini-grok。
常见问题
Q:网上说 Codex 可以开 1M,是真的吗?
官方这几页没有写。官方明确写了的是 GPT-6.1 Sol 在 Codex 里默认 500,000 token。别的数字请以官方模型页当天写法为准,没有出处的不要当真。
Q:把 model_context_window 改大,能让它记住更多吗?
官方没有保证。它描述的是「当前模型可用的窗口」,模型本身不支持的容量,改配置不会凭空增加。
Q:压缩之后它忘了前面的要求怎么办?
重要要求写进 AGENTS.md 或计划文件,并在压缩后让它重新读一遍。
Q:ChatGPT 网页版的上下文限制是一回事吗?
不是,网页版见 /guides/chatgpt-context-length-limits。
相关教程
- /guides/codex-switch-model-reasoning-effort:切换模型和思考强度
- /guides/codex-cli-commands-cheatsheet:命令行常用命令一页看
- /guides/codex-app-vs-cli-which-better:App 和 CLI 怎么选
参考资料
- Codex 官方文档:Models — https://learn.chatgpt.com/docs/models
- Codex 官方文档:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- Codex 官方文档:Advanced Configuration — https://learn.chatgpt.com/docs/config-file/config-advanced
- Codex 官方文档:Commands(CLI) — https://learn.chatgpt.com/docs/developer-commands?surface=cli
- Codex 官方文档:Subagents — https://learn.chatgpt.com/docs/agent-configuration/subagents
0 条评论
还没有评论,来抢沙发~