
结论先说
- 「先重连 5 次」没有官方的单独解释。 能对上的只有配置参考里一条:自定义模型提供方的流式重试次数
stream_max_retries,默认值是 5。这只是数字对应,不能直接当成原因。 - 连接问题和算得慢是两类问题。 前者看网络、状态页和连接方式;后者看模型、推理强度、对话长度和速度档位。
- 推理强度越高,越慢,也越费 token。 官方原话要点:更高的推理强度会增加响应时间和 token 用量,可能提高复杂任务的质量。
- Fast 模式能提速,但要多耗额度。 官方说明对支持的模型,Fast 模式使用的订阅额度是标准速率的 2.5 倍。
- 对话越长越要整理。 用
/compact把前面的内容压缩成摘要,释放上下文。
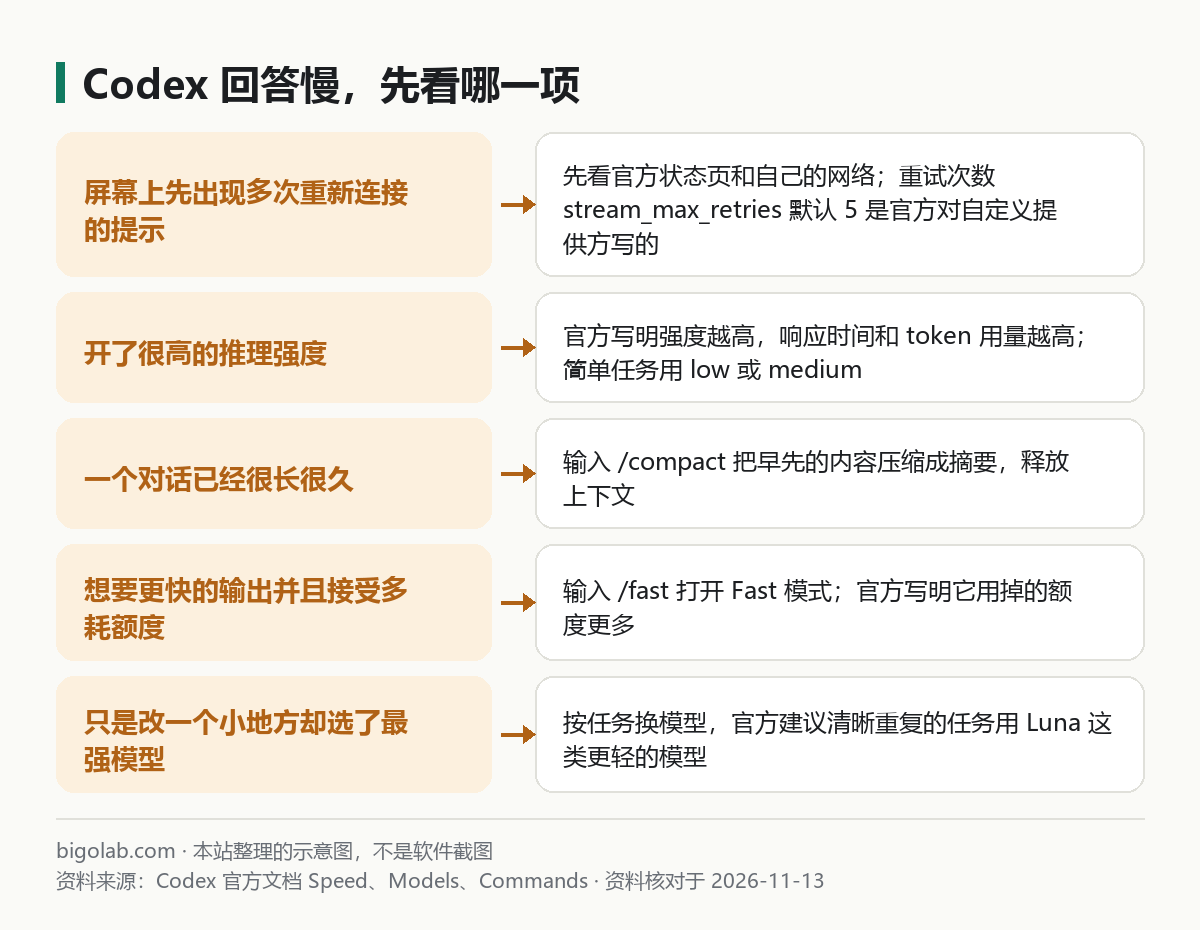
图:本站根据 Codex 官方文档《Speed》 整理的示意图
本文根据 Codex 官方文档《Configuration Reference》《Speed》《Models》和命令页整理,资料核对于 2026-11-13。官方没有单独解释「为什么总是先重连 5 次才回答」,也没有给「为什么慢」一个单一答案,所以本文把官方文档里和速度、重试有关的内容拆开列出,帮你按顺序排查。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 每次发问题,Codex 先显示几次重新连接,才开始输出的人;
- 感觉 Codex 整体很慢,想知道哪些设置能让它快一些的人;
- 担心「调快」会多花额度,想先弄清代价的人。
一、先重连几次:官方能确认的只有这些
先说官方有的:配置参考里,自定义模型提供方 [model_providers.<id>] 下有这几项和重试有关的设置:
request_max_retries:对提供方发起 HTTP 请求的重试次数,默认 4;stream_max_retries:流式输出(SSE)被打断后的重试次数,默认 5;stream_idle_timeout_ms:流式输出的空闲超时,默认 300000 毫秒,也就是 5 分钟。
所以如果你看到的是「重试 5 次后才出结果」,数字上和 stream_max_retries 的默认值一致。但是:官方把这些字段写在「自定义提供方」的配置里,没有写明用 ChatGPT 账号直接登录时的连接是否使用同样的次数,更没有说每次重连的原因是什么。所以这里只能说「可能相关」,不能说「就是它」。
连接中途断开的整套排查(流式连接、代理证书、状态页),已经有专门的教程:/guides/codex-stream-disconnected-before-completion,里面按官方帮助中心的网络建议排了顺序。本文不重复,只给出分流的思路:
- 先看官方状态页 status.openai.com 有没有 Codex 或 ChatGPT 的故障;
- 如果只有你这边慢,检查网络是否稳定、是否经过公司代理或需要自定义证书的网络;
- 如果你配置了自定义模型提供方,检查
base_url、密钥和上面的重试、超时设置是否合理。
二、算得慢:先看推理强度
推理强度决定模型想多久再回答。官方在多代理相关的说明里给了各档的使用场景:
low:任务很直接、速度最重要时用;medium:速度和深度比较均衡;high:需要梳理复杂逻辑、检查假设、处理边界情况时用,例如审查类任务;xhigh、max、ultra:用在特别吃推理的场景,且要所选模型支持这些档位。
官方同时写明:更高的推理强度会增加响应时间和 token 用量,但可能提高复杂任务的质量。所以改一个按钮文案、写一行注释这种小事,没必要开到高档。
在命令行里可以用命令直接改当前会话:
text
/model --reasoning=high
官方说明这条命令会保持当前模型,只把推理强度设为高(前提是该模型支持)。换成 --reasoning=low 就是降下来。完整的切换方法见 /guides/codex-switch-model-reasoning-effort。
三、再看模型:按任务选
官方模型页给出的选择思路是:先拿一个你熟悉的任务试,比较结果、等待时间和用量,再决定。各模型的定位,按官方写法:
- Astra:最难的端到端工作;
- GPT-6.1 Sol:重复的、长时间运行的工作,成本也要考虑时;
- GPT-6.1 Terra:日常写作和视觉类工作;
- Luna:清晰、可重复的任务,例如提取、分类、转换和结构化摘要。
另外官方在 Codex 文档里还写明,GPT-6.1 Sol 在 Codex 和 ChatGPT Work 里默认的上下文窗口是 500,000 个 token。对话里塞进去的内容越多,每一轮要处理的内容就越多,这是下一节要说的。
四、对话太长:用 /compact
官方命令页对 /compact 的描述是:总结当前可见的对话以释放 token,建议在长时间运行之后使用,让 Codex 保留关键点而不撑爆上下文窗口。执行后,早先的轮次会被一段简明的摘要取代,同时保留关键细节。
另外,配置参考里有自动压缩的阈值设置 model_auto_compact_token_limit,说明是「触发自动压缩历史的 token 阈值,未设置时使用模型默认值」。一般情况下不需要动它。
经验上,换了新任务就开新的对话,比在一个对话里无限延长更利于保持速度和质量,这条是本站建议,不是官方原话。对话怎么归档和删除见 /guides/codex-delete-archive-chats。
五、Fast 模式:快一点,但额度也快一点
官方速度页说明:可以用更高的额度消耗换更快的模型速度。
- 开关:命令行里输入
/fast切换,再输入一次关闭;也可以用/statusline把它显示在底部状态栏; - 持久设置:在
config.toml里写service_tier = "fast",并把[features]下的fast_mode设为true; - 适用范围:官方说明在你用 ChatGPT 账号登录的桌面 App、命令行和 IDE 扩展里可用,并且要当前模型支持。当前模型不提供 Fast 档位时,Codex 不会显示
/fast; - 代价:对支持的模型,Fast 模式使用的订阅额度是标准速率的 2.5 倍;购买的额度(credits)和企业按量计费是标准的 2 倍。官方写明对 GPT-5.6 的提速是 1.5 倍。
官方还有更快的 Ultrafast 档,但官方写明它目前只对 Pro $500 和符合条件的企业、教育版开放,其他自助订阅在发布时即使购买了额度也不能用。具体名单会变,以官方速度页为准。
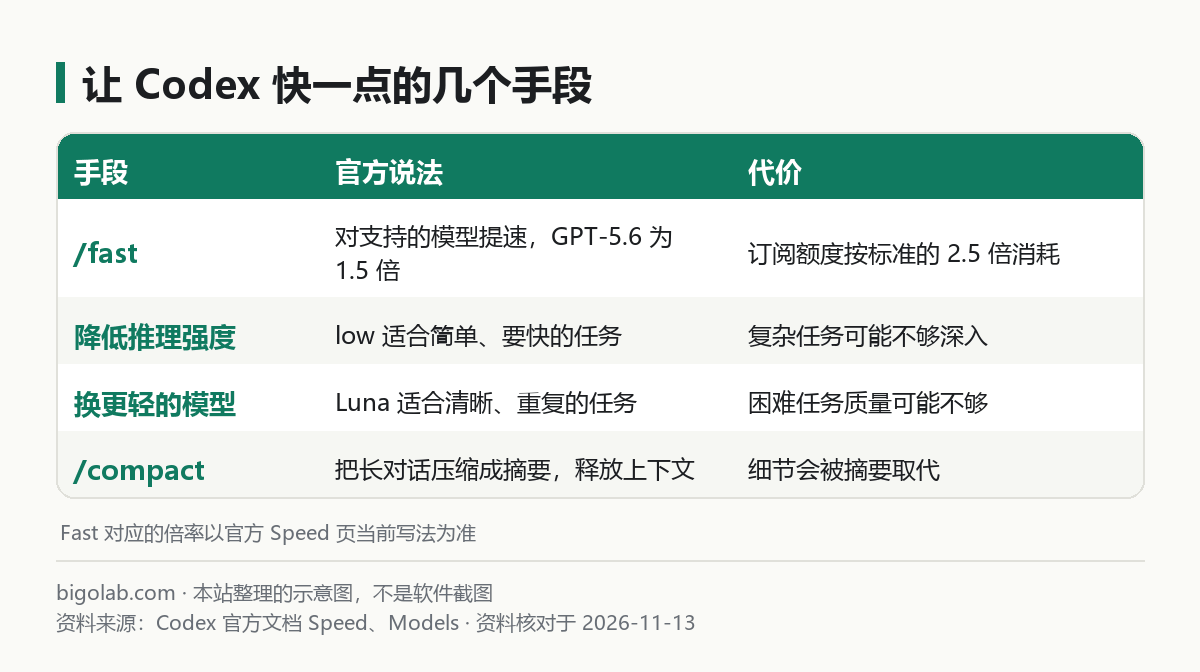
图:本站根据 Codex 官方文档《Speed》 整理的示意图
六、一个排查顺序
- 看状态页和网络:重连频繁、断线,先查这一步;
- 看是不是长对话:很长就
/compact或开新对话; - 看推理强度:小任务降到 low 或 medium;
- 看模型:任务清晰且重复,换更轻的模型;
- 最后才考虑 Fast 模式,并清楚它会多耗额度;
- 额度不够用时,先弄清楚自己的套餐,见 /guides/codex-usage-limits。
常见问题
Q:开了 Fast 还是慢?
Fast 只是提高生成速度,如果慢在连接或排队,它帮不上忙。先看第一节。
Q:想用更多额度跑重任务怎么办?
Codex 随 ChatGPT 套餐提供,高强度或 Fast 模式用得多,额度会消耗得更快。需要更多额度时,可以看看本站的 ChatGPT Plus 充值说明 或 ChatGPT Pro 充值说明,价格和额度以官方页面当前显示为准。
Q:为什么同一个问题时快时慢?
官方没有给出统一解释。负载、网络、对话长度和模型选择都会影响,没有哪一条是官方保证的。
Q:ChatGPT 网页版转圈很久,是同一个问题吗?
不是,网页版的排查见 /guides/chatgpt-slow-spinner-single-answer。
相关教程
- /guides/codex-stream-disconnected-before-completion:连接中途断开怎么办
- /guides/codex-switch-model-reasoning-effort:怎么切换模型和思考强度
- /guides/codex-usage-limits:额度与使用限制
参考资料
- Codex 官方文档:Configuration Reference — https://learn.chatgpt.com/docs/config-file/config-reference
- Codex 官方文档:Speed — https://learn.chatgpt.com/docs/agent-configuration/speed
- Codex 官方文档:Models — https://learn.chatgpt.com/docs/models
- Codex 官方文档:Commands(CLI) — https://learn.chatgpt.com/docs/developer-commands?surface=cli
0 条评论
还没有评论,来抢沙发~