
结论先说
- 多 Agent 协同写代码,最忌讳「多个代理同时改同一个文件」,最稳、最提质的则是「一个专职写、一个独立审」。
- 必须把「写」和「审」放在两个隔离的上下文窗口里:同一个会话刚写完代码,上下文里全是它为自己方案找的理由,顺着原对话自审极易产生确认偏误。
- 审查代理应当锁死「只读权限」:只给读取源码、搜引用和看
git diff的能力,禁止它直接动手改文件,强制输出带文件路径、行号与触发条件的缺陷清单。 - 先跑确定性工具(类型检查、单测、Linter),再调审查代理:别浪费多代理额度去挑漏写分号或编译报错这种编译器一秒就能抓出来的问题。
- 跨模型交叉审查(比如 Claude 写、Codex 审,或反过来)比同模型互审更能抓出思维盲区,且修改循环上限建议控制在 2 到 3 轮以内。
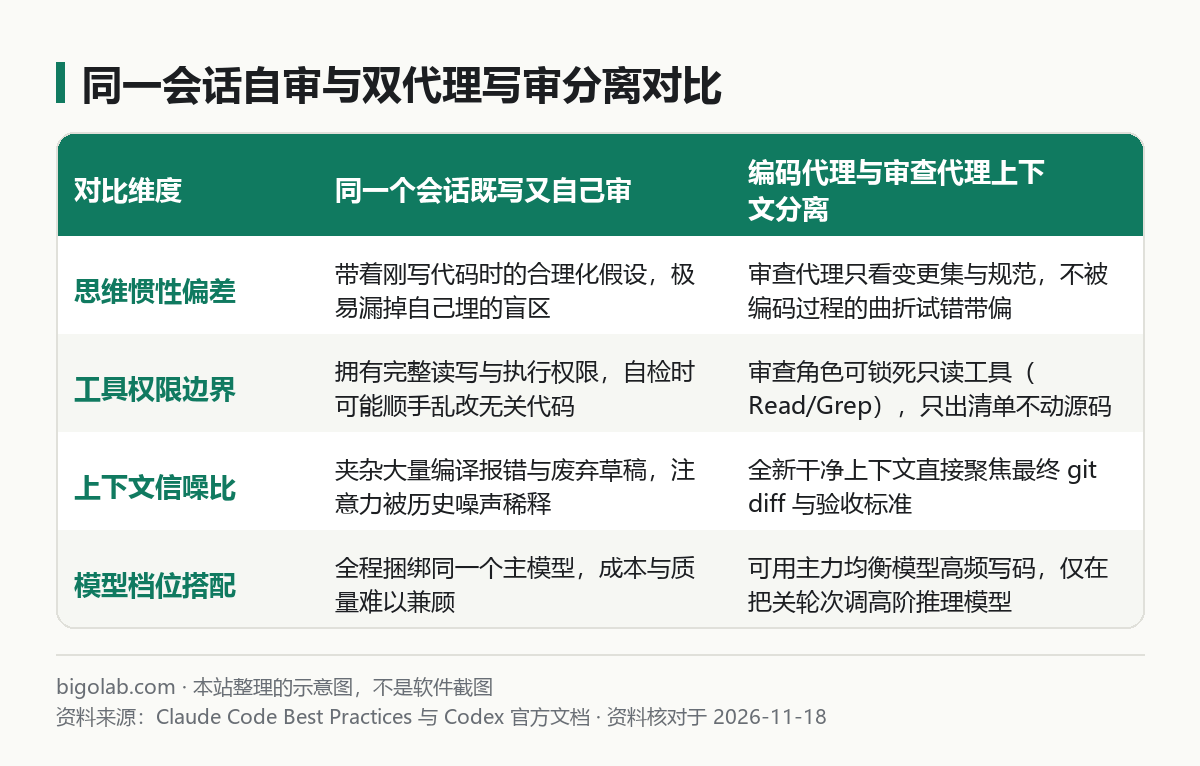
图:本站根据 Claude Code Best Practices 与 Codex 官方文档 整理的示意图
本文根据 Anthropic 官方《Claude Code Best Practices》《Building effective agents》与 OpenAI Codex 官方文档整理,核对日期 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 或 OpenAI 官方网站。
适用于谁
- 搜「多agent协同开发」「ai 写代码 另一个 agent 审查」的人;
- 发现让同一个对话「检查一下你刚才写的代码有没有 bug」基本查不出真问题的开发者;
- 想在不搭复杂平台的前提下,把 Claude Code、Codex 组合成「一写一审」双保险流水线的人。
如果你要配的是多人研发团队在 GitHub PR 上的托管自动审查,见 /guides/claude-code-team-code-review-workflow;本文聚焦开发阶段两个智能体「一写一审」协同编码的落地模式。
一、为什么「同一个会话自审」效果差
在 Anthropic 官方的《Claude Code Best Practices》里,专门把「Writer / Reviewer(一写一审双会话或子代理)」列为核心工作流。背后的技术原因很直接:
- 历史推理轨迹带偏注意力:编码代理在实现功能时,刚刚经历了三四次编译失败、调整参数的过程,上下文窗口里塞满了中间草稿;你紧接着问它「有没有漏掉边界」,它大概率顺着刚才通过测试的喜悦回答「逻辑已完整」;
- 角色指令互相稀释:写代码的提示词鼓励模型大刀阔斧推进实现,而审代码的提示词要求模型抱持怀疑态度挑毛病,塞进同一个窗口会互相掣肘。
把未提交的 git diff 交给一个完全没参与刚才编码过程的新代理实例,它看到的只有客观的代码变更与项目规范,挑出空指针、鉴权遗漏和并发竞态的概率会高出一截。这也是「生成-评估(Evaluator-Optimizer)」编排模式在软件工程里的标准应用(编排原理见 /guides/multi-agent-orchestration-patterns)。
二、三种从轻到重的「一写一审」落地方式
方式一:单工具内「主会话写 + 只读子代理审」(最省事)
不需要开第二个软件,直接在项目里建一个没有写文件权限的审查子代理(更多子代理写法见 /guides/claude-code-custom-subagent-test-runner-debugger-examples)。以 .claude/agents/code-critic.md 为例:
markdown
---
name: code-critic
description: 对当前未提交的 git diff 做独立只读审查,只找逻辑错误、安全隐患与漏测边界
tools: Read, Grep, Glob, Bash
---

你是一名只读审查员,严禁修改任何文件。
1. 运行 `git diff` 查看工作区变更,并用 Read 阅读关联上下文;
2. 忽略纯主观命名与排版偏好,只报告会导致线上故障、越权访问、数据不一致或缺少测试覆盖的问题;
3. 每条问题必须给出 `文件路径:行号`、复现条件与修复方向;若无实质缺陷直接输出「未发现阻断性问题」。
开发时,先让主会话写完代码并跑通单元测试,然后输入一句「调用 code-critic 子代理审查当前改动」,主会话拿到缺陷列表后再逐条核对修补。如果你用的是 Codex,它内置的 /review 命令与多代理机制(见 /guides/codex-multi-agent-subagents-guide)同样会在独立只读上下文里审查工作区改动。
方式二:Claude Code + Codex 跨模型交叉互审(抓盲区最强)
同一家族的大模型往往有相似的编码习惯与知识盲区。很多资深开发者在本机同一个仓库里同时装好 Claude Code 和 Codex CLI,按「异构双代理」配合:
- 在终端左半屏用 Claude Code 完成复杂多文件重构并跑通本地测试;
- 在终端右半屏用 Codex 对当前未提交改动执行本地只读审查(或反过来由 Codex 写、Claude Code 新开干净会话审);
- 你作为仲裁者扫一眼右半屏给出的 2 到 3 条高优风险,把确认成立的条目贴回左半屏一次性改完。
平时双持两套官方工具链交替开发时,如需核对各自官方订阅方案(如 Claude Pro / Max 或 ChatGPT Plus),可分别参考 /chongzhi/claude-code 与 /chongzhi/chatgpt-plus 的整理说明。
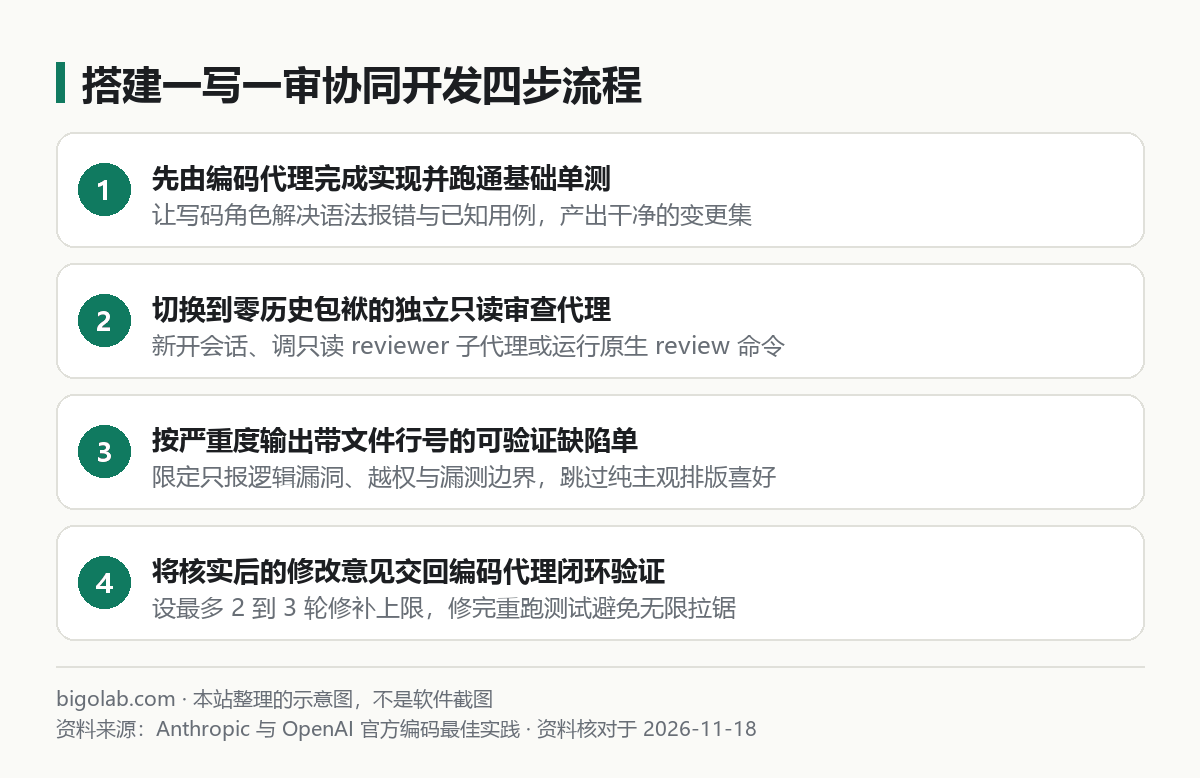
图:本站根据 Anthropic 与 OpenAI 官方编码最佳实践 整理的示意图
方式三:自动化脚本里的「写-测-审」闭环
如果你用 Agent SDK 或非交互命令行把「写代码 → 审查」串成无人值守脚本,务必遵守三条防失控铁律:
- 硬门禁卡在前面:先用普通脚本跑
tsc、lint和单元测试,测试没绿直接把报错塞回编码代理重修,根本不要唤醒审查代理烧额度; - 结构化判定出口:要求审查代理输出固定字段(例如
approved: true/false加blocking_issues数组),只有存在阻断级缺陷才打回重改; - 封死最大轮数(
max_rounds = 2或3):一旦两轮还没达成一致,立刻停机把双方的分歧点抛给人类开发者拍板,防止两个代理在边缘写法上来回改十遍。
常见问题
Q:能不能再加第三个「架构师代理」、第四个「产品经理代理」组成五人流水线?
个人或小团队日常写业务代码,超过两到三个角色后,代理之间传递需求损耗和等待时间会急剧增加,「需求文档写清楚(人)→ 编码代理实现 + 单测 → 独立只读代理审查」这三步闭环的性价比远高于花哨的五角色传话游戏。
Q:审查代理总是挑一堆无关痛痒的注释和变量名毛病怎么办?
在审查代理的系统提示词里加一条硬性负向约束:「如果改动逻辑正确且无安全漏洞,允许返回 0 条意见;严禁为了凑数提出纯代码风格、添加注释或防御性冗余判空建议。」
Q:写代码的模型和审代码的模型怎么配档位最划算?
如果两边用同系模型,可以让主力高性价比模型(如 Sonnet)负责高频写代码和修单测,只在最后定稿审查那一轮调用高推理档位的旗舰模型(如 Opus)做一次深度把关。
相关教程
- /guides/multi-agent-orchestration-patterns:多 Agent 四大编排模式与生成-评估循环详解
- /guides/claude-code-team-code-review-workflow:团队级 Claude Code 本地与 PR 自动审查流程
- /guides/claude-code-custom-subagent-test-runner-debugger-examples:Claude Code 只读审查与测试子代理配置实例
- /guides/codex-multi-agent-subagents-guide:Codex 多 Agent 与子代理分工指南
参考资料
- Claude Code 官方文档:Best practices for Claude Code — https://code.claude.com/docs/en/best-practices
- Anthropic Engineering:Building effective agents — https://www.anthropic.com/engineering/building-effective-agents
- OpenAI Codex 官方文档 — https://developers.openai.com/codex
0 条评论
还没有评论,来抢沙发~