
结论先说
- 官方没有「暗中降智」的说法,最常见的原因是推理强度落在低档。 官方文档写明:在支持的个人套餐上,新建会话默认以
GPT-6.2 Sol的 Light(轻度)档起步,复杂任务不手动调高就会想得浅。 - 命令行里先跑
/status看底牌。 它会直接列出当前生效的模型、审批策略、可写目录和剩余上下文容量,不用猜。 - 长对话会被自动压缩,工具超长输出也会被截断。 同一个会话拖得太长,早期细节会被摘要替代;做完一件事用
/new开新会话最稳。 - 项目规则没生效,先查
AGENTS.md有没有超过 32 KiB 或项目未被信任。 超出上限的文件和未信任仓库的.codex/配置都会被跳过。 - 模型换代后档位不完全等价。 官方明确提醒不同代模型之间的推理档位不能机械对号,升级模型后要重新调档。普通网页版 ChatGPT 的同类排查见 ChatGPT 为什么感觉变笨了。
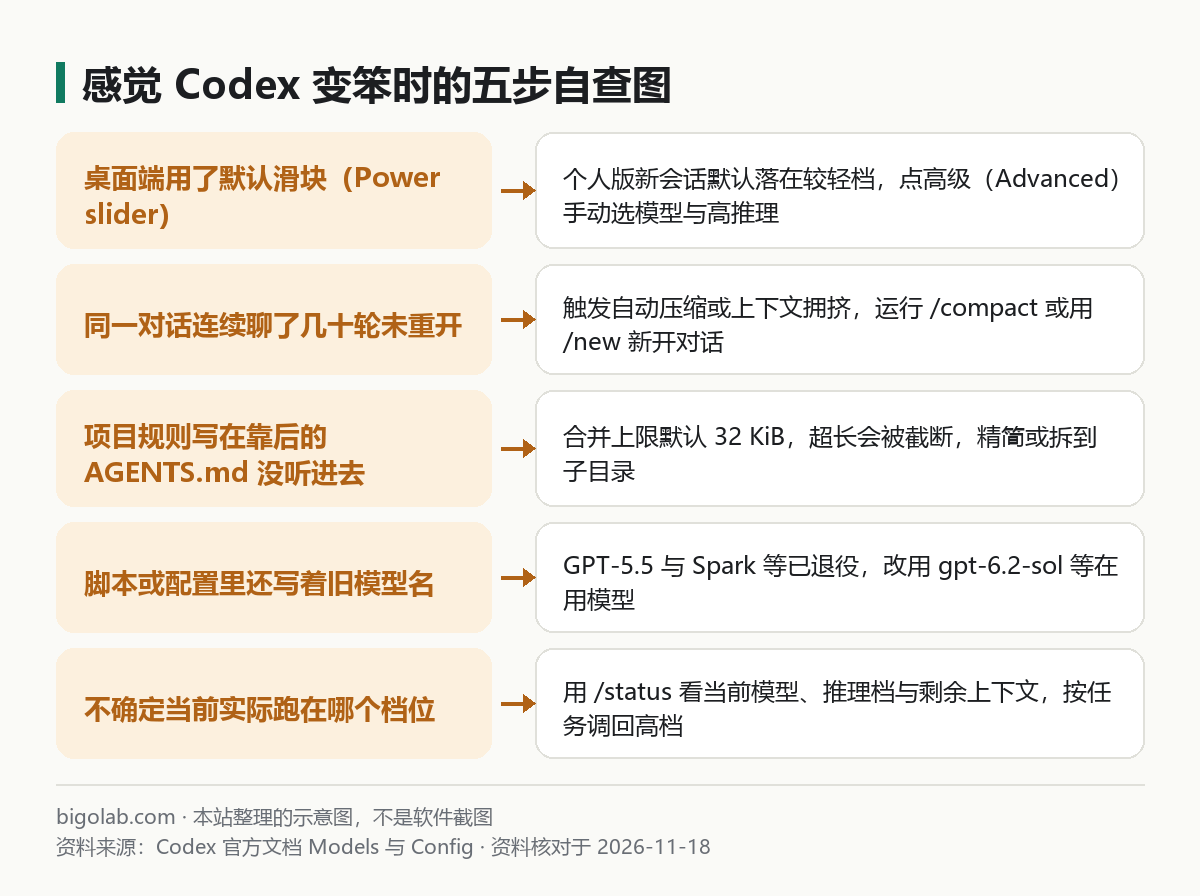
图:本站根据 Codex 官方文档:Models 与示例配置整理的示意图
本文根据 Codex 官方文档《Models》《Sample Configuration》《Slash commands in Codex CLI》和《Custom instructions with AGENTS.md》整理,资料核对于 2026-11-18。OpenAI 官方文档没有「降智」这一说法,本文把官方文档中会直接改变推理深度和可见上下文的设置逐项列出,供你对照自查。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 搜「codex模型降智」,感觉最近 Codex 写代码爱漏边界条件、不按指令改文件的人;
- 同一个项目刚开始挺聪明,聊了几十轮之后突然开始胡改或忘掉前文约束的人;
- 想搞清楚哪些配置项在限制 Codex 思考深度和上下文容量的人。
一、先查当前模型与推理强度:是不是跑在 Light / Low 档
很多用户感觉「变笨」,是因为用了默认档位去啃跨文件重构。官方文档在《Models》里写得很明确:
- 桌面端与网页版功率滑块(Power slider):在支持的个人套餐上,新开会话默认使用
GPT-6.2 Sol的 Light 档(企业工作区默认 Medium)。滑块往 Faster 推是求快省额度,往 Smarter 推才是加深推理;点开 高级(Advanced) 才能精确指定GPT-6.2 Astra以及 High、Extra High、Max 或 Ultra。 - 命令行 CLI:输入
/model查看或切换;想在底部状态栏随时盯住当前模型与推理档位,输入/statusline,把model+reasoning和context stats勾上,避免跑在低档还不自知。 - 计划模式单独设高档:官方示例配置提供了
plan_mode_reasoning_effort = "high",可以让日常编码保持medium,切到/plan规划方案时自动用high深想一层。
官方同时说明,不同代模型之间推理档位并不一一对应,换代后要拿熟悉的任务重新对比。具体切换步骤见 Codex 怎么切换模型和思考强度。
二、再查上下文:长对话自动压缩与工具输出上限
即使模型和推理档位拉满,塞进对话的材料变残缺了,回答质量一样会掉下来。官方配置参考揭示了三处截断与压缩机制:
- 长对话自动压缩:当上下文接近
model_auto_compact_token_limit(未设置时按模型默认值)或触发回合末压缩阈值model_post_turn_compact_threshold_percent时,Codex 会把较早的轮次替换成简短摘要以腾出空间。摘要能留主干,但早先提过的细枝末节可能丢失。 - 单次工具输出上限:
tool_output_token_limit限制每次命令返回结果保留多少 token(官方示例里为12000)。一次打印几万行日志时,超出部分不会完整保留。 - 手动整理比硬撑好:剩余上下文不多时,主动执行
/compact做一次干净总结;换了另一个子需求就直接输/new开新对话。觉得慢或频繁重连时的排查见 Codex 为什么总是先重连几次才回答、为什么这么慢。
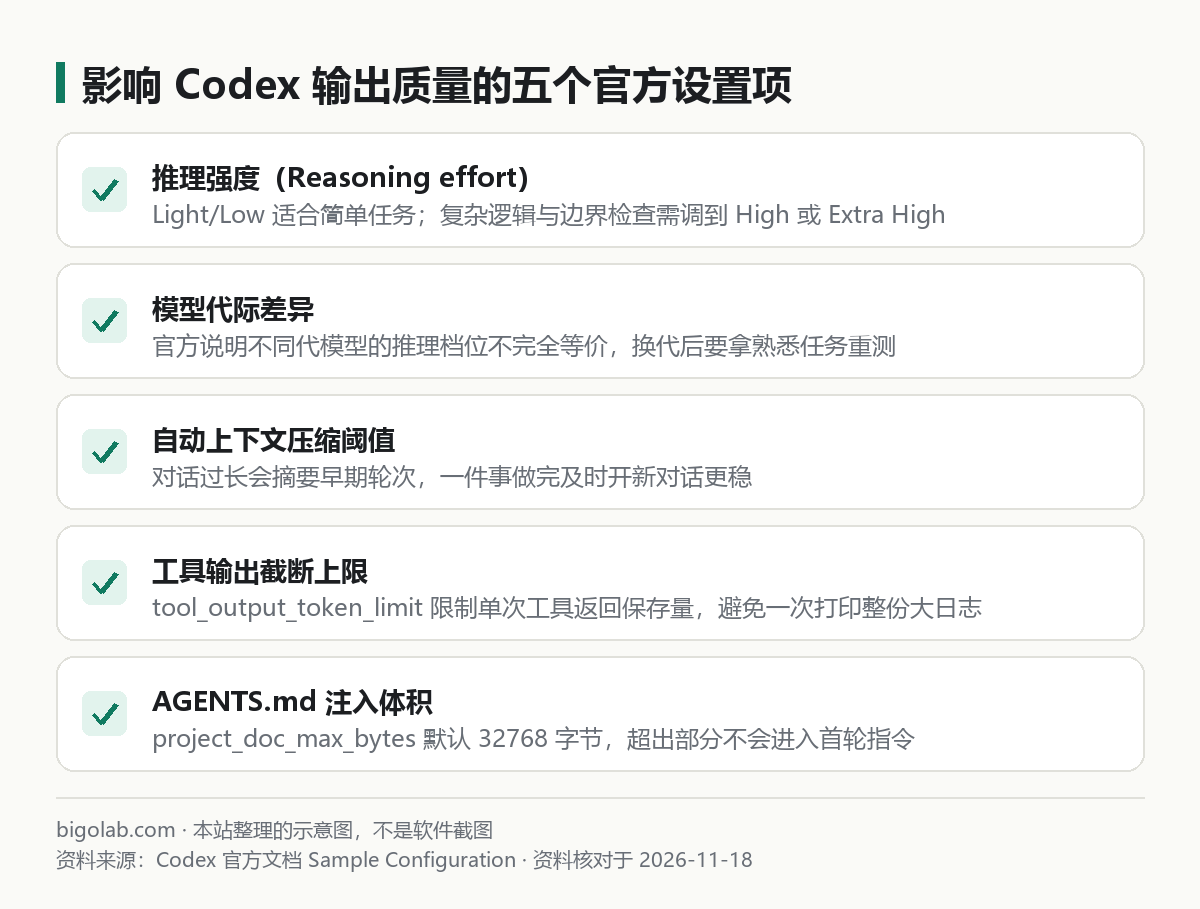
图:本站根据 Codex 官方文档:Sample Configuration 整理的示意图
三、查 AGENTS.md 字节上限、信任状态与额度提醒
如果你觉得 Codex「老写出不符合仓库规范的代码」,再查四件事:
project_doc_max_bytes默认 32768 字节(32 KiB):Codex 从~/.codex/AGENTS.md到仓库根目录再到当前子目录逐层拼接指令,达到 32 KiB 就停止往后添加,靠后的规则根本没进提示词(详见 Codex 怎么读 AGENTS.md)。- 仓库未标记为受信任(trusted):未信任目录会跳过项目内的
.codex/config.toml;在 CLI 里输入/debug-config可查看配置覆盖层,跑codex debug prompt-input可直接打印模型实际收到的完整提示词 JSON。 - 接近额度上限或锁了轻量模型:高档推理和 Astra 消耗套餐额度更快。如果你因为怕 5 小时窗口见底而长期不敢开高档,可看本站 ChatGPT Plus 充值说明 或无 5 小时窗口限制的 ChatGPT Pro 充值说明。
- 旧模型残留:
gpt-5.5、gpt-5.3-codex-spark等已退役,请换用在用模型,选型对比见 Codex 用哪个模型好。
常见问题
问:开了 /fast(Fast 模式)会让 Codex 变笨吗?
答:官方说明 Fast 模式是用更高倍率的额度消耗换取更快的生成速度,并不是靠调低推理档位凑速度;但若你顺手把推理强度改成了 Low,复杂任务质量就会下降。
问:怎么在不污染主对话上下文的前提下临时问个旁支问题?
答:在 CLI 里输入 /side(或 /btw)开启旁支对话,它的记录与主对话隔离。
问:改完 AGENTS.md 后为什么当前对话没变化?
答:指令链在会话启动时构建,改完后请重启 Codex 或用 /new 新开会话再试。
相关教程
- Codex 用哪个模型好:按任务推荐
- Codex 怎么切换模型和思考强度
- Codex 怎么读 AGENTS.md
- Codex 为什么总是先重连几次才回答、为什么这么慢
- ChatGPT 为什么感觉变笨了(降智)
参考资料
- Codex 官方文档:Models — https://learn.chatgpt.com/docs/models
- Codex 官方文档:Sample Configuration — https://learn.chatgpt.com/docs/config-file/config-sample
- Codex 官方文档:Slash commands in Codex CLI — https://learn.chatgpt.com/docs/reference/slash-commands
- Codex 官方文档:Custom instructions with AGENTS.md — https://learn.chatgpt.com/docs/agent-configuration/agents-md
0 条评论
还没有评论,来抢沙发~