
結論先說
- Fast 和 Ultrafast 不是縮水小模型,而是「同一個底層模型的高速推理通道」:代碼生成質素與標準檔一致,純粹用更高的算力配額倍率換取更快的吐字速度。
- 官方公佈的速度提升幅度:在 GPT-6.2 Astra 等主力模型上,Fast 生成速度約為標準檔的 1.5 倍;Ultrafast 在 GPT-6.2 Astra 與 GPT-6.2 Sol 上最高可達標準檔的 4.5 倍(在特定前代模型如 GPT-6 Astra 上最高可達 8 倍)。
- 開啟與切回都很順手:桌面與網頁端直接點輸入框底部的閃電圖標;Codex CLI 裏直接敲
/fast或/ultrafast,再重複敲一次相同命令就會退回 Standard 標準檔。 - 注意額度帳單:只要開啟加速檔,每生成相同字數就會按更高倍率消耗你套餐內的包含配額或購買積分——後台無人值守任務切記關回 Standard。
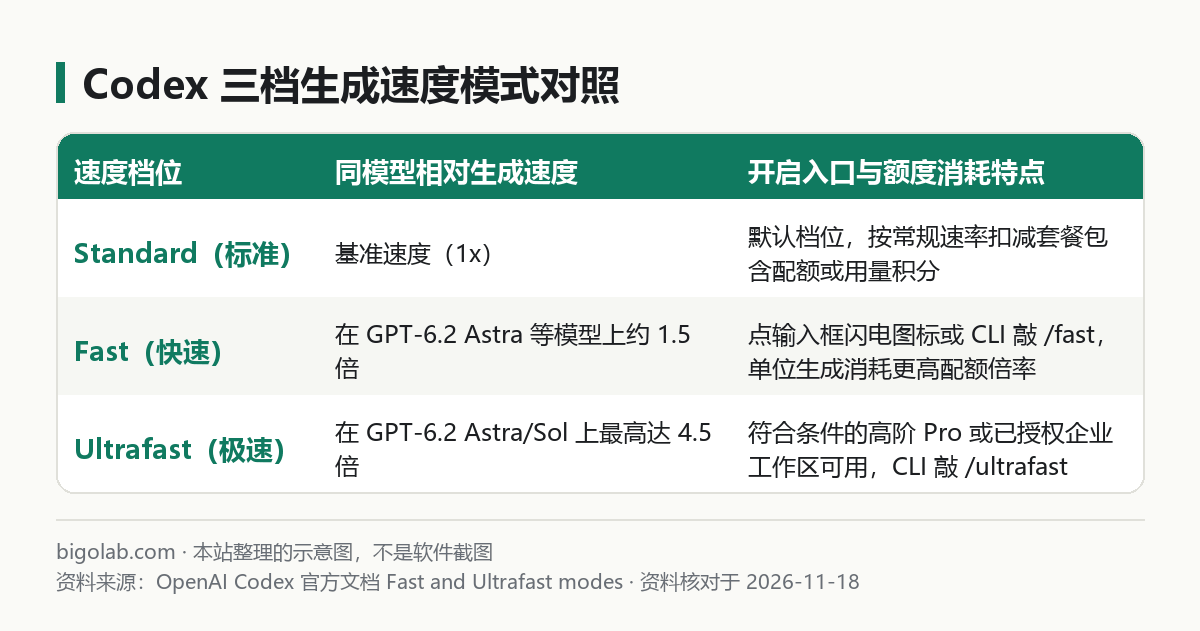
圖:本站根據 OpenAI Codex 官方文檔 Fast and Ultrafast modes 整理的示意圖
本文根據 OpenAI Codex 官方文檔《Fast and Ultrafast modes》《Pricing》整理,核對日期 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 搜「codex fast 模式怎麼開」「codex ultrafast 是什麼」「codex 閃電圖標扣多少額度」的開發者;
- 在緊急線上排錯現場緊盯終端,嫌高推理檔位旗艦模型流式生成太慢、但又不敢降級成輕量模型怕掉質素的人;
- 明明買了團隊或企業工作區席位,卻在輸入框速度選單裏找不到 Ultrafast 選項的人。
如果你想調的是模型「想多深」(推理強度 effort)而不是「吐字多快」,請看 /guides/codex-switch-model-reasoning-effort;各模型家族本身的定位對比見 /guides/codex-which-model-to-choose-by-task。
一、桌面端、IDE 插件與 CLI 分別怎麼開關
1. 桌面 App 與網頁端操作
打開輸入框(Composer)底部的模型選擇器區域,找到旁邊的閃電圖標(Lightning bolt):
- 如果你當前帳號與所選模型只開放了 Standard 和 Fast 兩檔,點擊閃電圖標就會直接在開關之間一鍵切換;
- 如果你的套餐支持 Ultrafast,點擊閃電圖標會彈出三檔速度選單(Standard / Fast / Ultrafast)供你挑選,也可以在高級模型選擇器裏的 Speed 欄修改。
2. Codex CLI 命令行操作
使用 ChatGPT 帳號登入 CLI 後,在會話輸入框敲 / 可以看到當前模型支持的速度命令:
text
/fast
/ultrafast
/statusline- 輸入
/fast或/ultrafast立即切換,並且 CLI 會自動記住你的選擇帶入後續會話; - 很多人開了加速忘了關,導致後面幾天日常閒聊也一直按高倍率扣配額——建議順手運行
/statusline把速度狀態固定顯示在終端底部狀態欄裏,用完再敲一次/fast(或/ultrafast)恢復為 Standard。
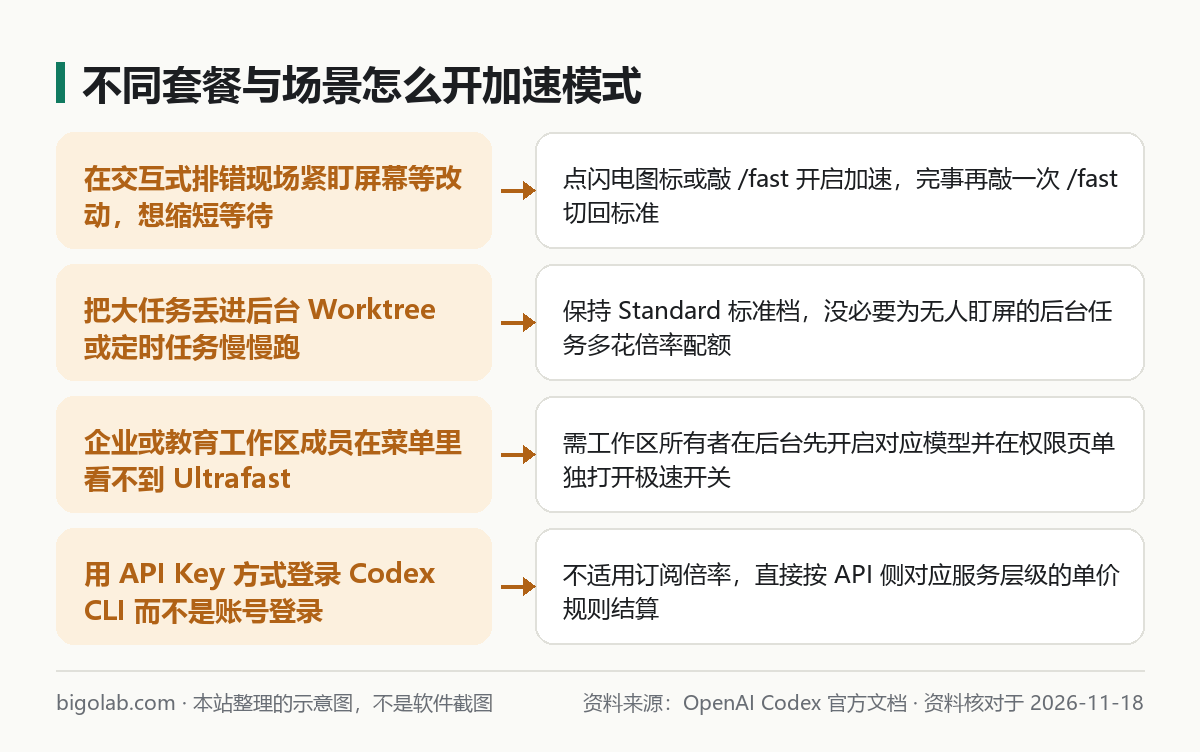
圖:本站根據 OpenAI Codex 官方文檔 整理的示意圖
二、配額扣減規則與套餐開放門檻
加速模式是典型的「拿額度換時間」,搞清計費邏輯才能把好鋼用在刀刃上(訂閱、積分與 API 三套帳本的關係詳見 /guides/codex-pricing-subscription-credits-api-key 與 /guides/codex-usage-limits):
- 用 ChatGPT 帳號登入時:無論是 Fast 還是 Ultrafast,都會優先按對應的速度乘數(Speed multiplier)扣減你當前週期的套餐包含額度,包含額度用盡後再扣可用積分(Credits);
- 用 API Key 登入 CLI 時:不走 ChatGPT 積分乘數規則,而是直接按 OpenAI API 側對應高速服務層級的 Token 費率計費;
- Ultrafast 的高階准入要求:Fast 模式覆蓋面較廣,而極速 Ultrafast 僅面向符合條件的高階 Pro 訂閱檔位,以及簽有積分制或按量協議的 Enterprise / Edu 工作區開放。個人高頻重度開發者如需對比 Plus 與 Pro 各檔位的包含配額和高速模型支持差異,可查閱 /chongzhi/chatgpt-pro 與 /chongzhi/chatgpt-plus 的整理說明。
常見問題
Q:我們公司是 Enterprise 企業工作區,為什麼所有人點開閃電圖標都看不到 Ultrafast?
按官方管理文檔,企業工作區裏的 Ultrafast 是一個預設關閉的獨立權限開關。需要工作區所有者(Owner)做兩步配置:先在模型可用性後台啟用對應的 GPT-6.2 模型,再去「角色與工作區權限(Workspace permissions)」裏為指定成員或全員勾選開啟 Ultrafast 權限(同時留意數據駐留地區要求:部分模型極速推理目前僅支持特定區域如美國的數據駐留)。
Q:把任務放到後台工作樹或雲端異步跑時,有必要開 Fast 嗎?
完全沒必要。當你已經切出去幹別的活、等跑完再收通知時,早兩分鐘跑完和晚兩分鐘跑完體感沒有區別,保持預設的 Standard 能讓同樣的套餐額度多跑不少任務。只有你在結對盯屏實時一問一答調試時,開加速才真正值回票價。
相關教學
- /guides/codex-switch-model-reasoning-effort:Codex 切換模型與調整推理強度(effort)指南
- /guides/codex-which-model-to-choose-by-task:Codex 各模型家族按任務選型建議
- /guides/codex-pricing-subscription-credits-api-key:Codex 訂閱額度、積分與 API Key 計費詳解
- /guides/codex-usage-limits:Codex 用量限制與恢復時間說明
參考資料
- OpenAI Codex 官方文檔:Fast and Ultrafast modes — https://learn.chatgpt.com/docs/fast-and-ultrafast-modes
- OpenAI Codex 官方文檔:Pricing & Speed multipliers — https://learn.chatgpt.com/docs/pricing
0 條評論
還沒有評論,來搶沙發~