
结论先说
- Prompt Caching 和 Message Batches 完全可以合法叠加,是官方离线降本的王炸组合:异步批处理本身享半价折扣,再加上共享长前缀命中缓存的高额折扣,大批量固定规则任务的综合输入成本能压到常规同步调用的零头。
- 在异步批处理里强烈建议把缓存设为
"ttl": "1h"(1 小时):因为 Batches 是后台队列异步分波调度的,跨度一旦超过 5 分钟,默认的"5m"缓存就会在半途过期导致重复写入扣费。 - 批内缓存属于「尽力而为(Best-effort)」并发匹配:如果第一波几十个请求在同一毫秒并发落地而缓存尚未写完,前几个请求可能会同时触发写入,建议可先发单条同步请求「预热建好缓存」再投递大批量任务。
- 验证提示词模板或领取会员附赠 API 额度:上线大规模批处理前建议先在网页端调准规则,或利用高阶订阅附赠的月度开发额度试跑,可查看本站 Claude Max 充值说明 与 Claude Pro 充值页。
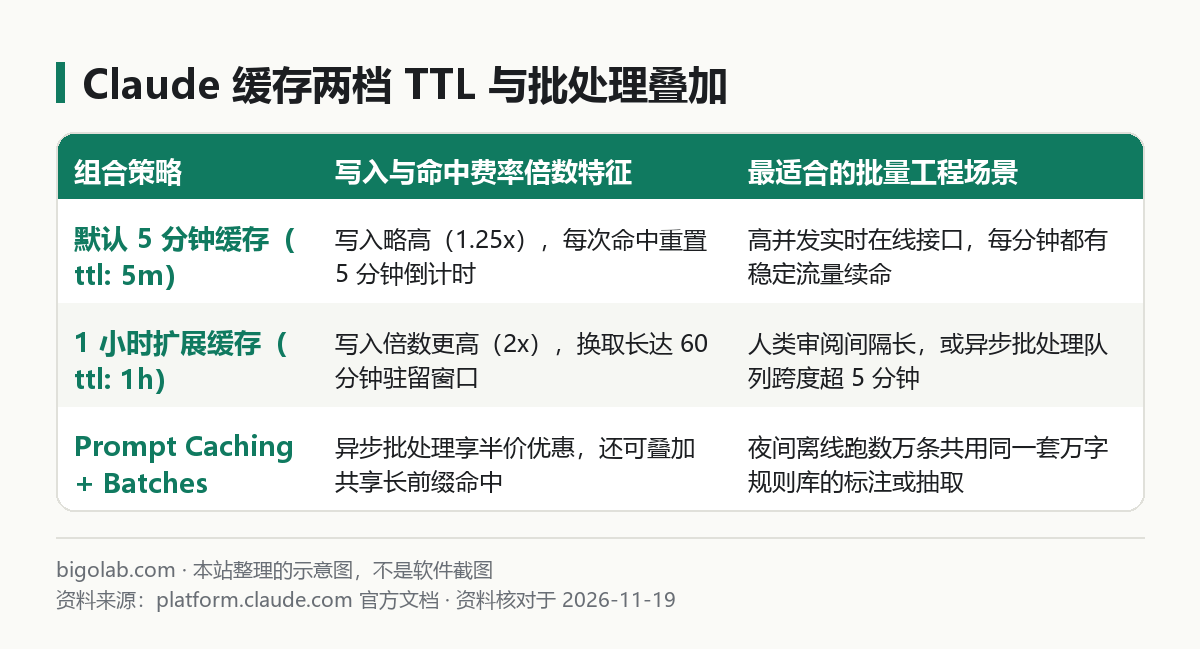
图:本站根据 Anthropic 官方缓存与批处理文档 整理的费率倍数与场景对比图
本文根据 Anthropic 官方开发者文档《Prompt caching》《Message Batches》(platform.claude.com/docs)整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 要在夜间离线跑几千甚至几万条工单分类、简历初筛或文档结构化提取,每条请求都挂着同一套两万字规则手册的后端工程师;
- 已经分别看过提示词缓存(本站 222 号文)和异步批处理(本站 1844 号文),想知道把两者叠在一起到底怎么写代码、为什么默认 5 分钟缓存在大批次里容易半路断掉的人;
- 纠结
cache_control里的"ttl": "5m"和"ttl": "1h"写入差价怎么算回本的架构师。
一、5m 与 1h 两档 TTL 怎么算回本,为什么批处理偏爱 1h
如果你还不熟悉两个单项基础概念,可以先回顾本站 Claude 提示词缓存基础教程 与 Claude API Message Batches 批处理入门。把两者合体时,核心算术题就在 ttl 参数上:
- 默认 5 分钟档(
"ttl": "5m",省略不填即为此档):首次写入缓存按基础输入价的 1.25 倍 计费,只要 5 分钟内有下一次请求命中,倒计时就自动重置回 5 分钟。非常适合白天每秒都有用户访问的在线客服机器人——只付一次 1.25 倍写入费,能靠源源不断的流量续命一整天。 - 扩展 1 小时档(
"ttl": "1h"):首次写入按基础输入价的 2 倍 计费,换来整整 60 分钟免刷新的稳固驻留期。非常适合两种情况:一是人类每隔二十分钟才回来审一次方案的慢节奏代码助手;二是后台排队执行耗时十几到几十分钟的 Message Batches 异步任务。只要同一批次里有三四条以上的请求成功读到缓存,多付的那一点首次写入费瞬间就赚回来了。
长文档精读与高频生产力订阅入口:无论是往 Projects 挂载几十份背景资料、审阅几十页英文商业合同,还是连续绘制复杂架构图,免费版短窗口配额极易受限。国内用户可通过本站支付宝、微信支付或 AlipayHK 免上号自助开通 Claude Pro 会员(直达单品 Pro iOS 自助充值)或大额度 Claude Max 充值。
二、Python 完整实战代码(预热缓存 + 投递 1h 批处理 + 核验命中)
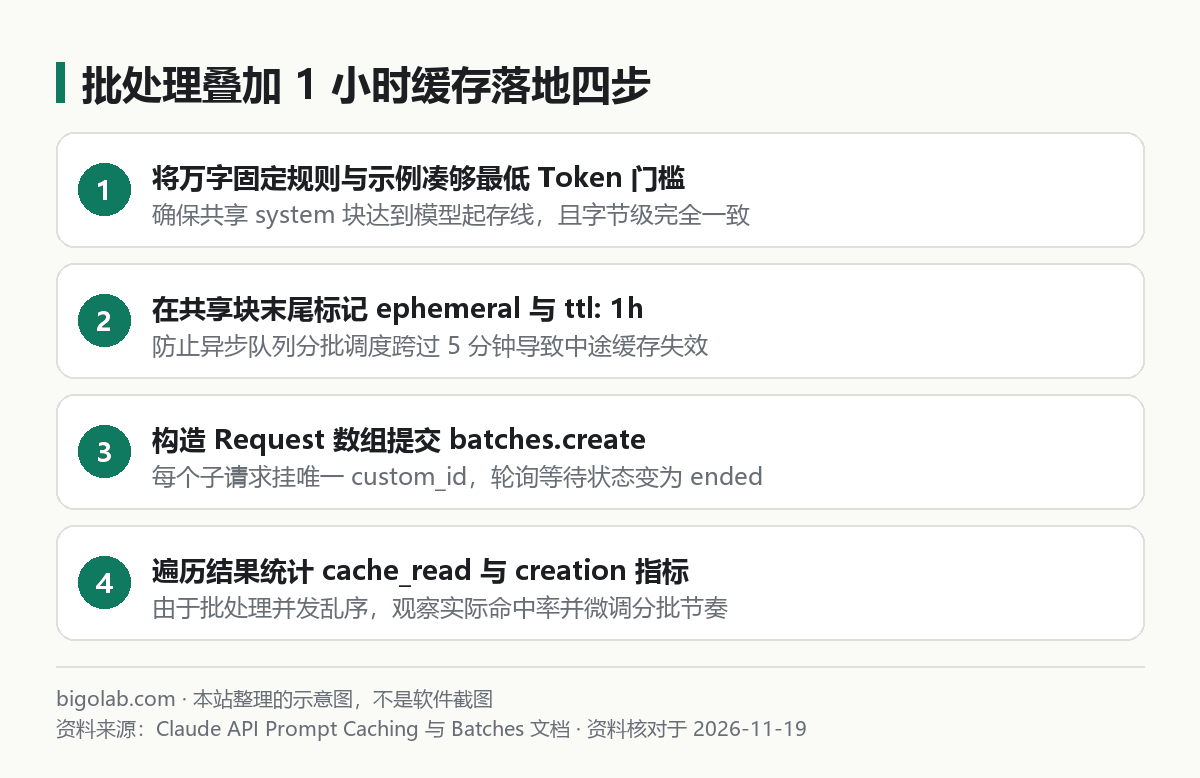
图:本站根据 Claude API 官方文档 整理的四步架构落地示意图
为了让整批几千条请求几乎百分之百命中读取折扣、避开首波并发重复写入,工程上最稳的做法是先用一条轻量请求把 1 小时缓存热好,紧接着立刻把整包 Batch 推进去(API 密钥准备见 Claude Console 获取 API Key 指南,计算前缀有没有达标可用 Count Tokens 接口教程):
python
import time
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()
MODEL_ID = "claude-sonnet-5-5"

# 注意:共享长前缀必须达到对应模型的最低起存 Token 门槛,且所有请求中字节级一字不差
shared_system_blocks = [
    {
        "type": "text",
        "text": open("enterprise_classification_manual.md", encoding="utf-8").read(),
        "cache_control": {"type": "ephemeral", "ttl": "1h"},
    }
]

# 第一步(推荐技巧):先发 1 条极短同步请求完成缓存首次写入预热
client.messages.create(
    model=MODEL_ID,
    max_tokens=16,
    system=shared_system_blocks,
    messages=[{"role": "user", "content": "回复就绪即可"}],
)

# 第二步:组装共享完全相同 system 前缀的大批量异步请求
tickets = [("ticket-001", "退款一直没到账"), ("ticket-002", "发票抬头填错了怎么重开")]
requests_payload = [
    Request(
        custom_id=cid,
        params=MessageCreateParamsNonStreaming(
            model=MODEL_ID,
            max_tokens=512,
            system=shared_system_blocks,
            messages=[{"role": "user", "content": body}],
        ),
    )
    for cid, body in tickets
]

batch = client.messages.batches.create(requests=requests_payload)

# 第三步:轮询等待异步批处理变为 ended 并核查缓存读取指标
while True:
    status = client.messages.batches.retrieve(batch.id)
    if status.processing_status == "ended":
        break
    time.sleep(20)

for item in client.messages.batches.results(batch.id):
    if item.result.type == "succeeded":
        u = item.result.message.usage
        print(item.custom_id, "缓存写入:", u.cache_creation_input_tokens, "缓存读取命中:", u.cache_read_input_tokens)
常见问题
问:我已经照抄加上了 cache_control,为什么跑完看 cache_read_input_tokens 全是 0?
答:排查两件事:第一,你的 enterprise_classification_manual.md 总字数太短,没跨过所选模型的最低缓存起存门槛(未达标时服务端不会报错,而是静默当普通无缓存请求处理);第二,你在拼装每条子请求的 system 字符串时混入了当前时间戳或变动编号,破坏了从头开始逐字节完全一致的前缀匹配铁律。
问:如果一个超大批次排了整整 4 个小时才跑完,1h 缓存中途还是过期了会报错吗?
答:完全不会报错失败。缓存过期后,下一波被调度到的子请求只是自动重新触发一次缓存写入并开启新的 1 小时窗口,后续子请求接着继续命中。你也可以把几万条超大任务按每两三千条一包分批投递,命中率更可控。
问:订阅了 Claude Max 会员送的月度 API 额度能用来跑这个批处理接口吗?
答:只要在 Anthropic Console 正常绑定领取了计划附赠的 API 额度(绑定方法见 Claude Max 与 Team 月度赠送 API 额度领取教程),该额度在 Console 组织账户里同样可用于常规 Messages 与 Batches 接口调用。
问:新注册 Claude 收不到手机验证码,或者没有外币卡怎么开通 Pro / Max 会员?
答:注册受阻可先看本站 Claude 注册与普号说明页;已有账号升级会员可直接前往 Claude Pro 充值页 或 Claude Max 充值页 获取自助卡密兑换,支持开具增值税发票,实时价格与售后边界(封号不在质保范围)见各商品页。
0 条评论
还没有评论,来抢沙发~