
本文根据 Claude 官方《Batch processing》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 Anthropic 官方网站。API 是按用量计费的独立服务,与 Claude 订阅分开计算,Key 的获取见 /guides/claude-api-key-console。
适用于谁
- 要一次处理几百、几万条文本的人:评测、分类、摘要、批量生成商品描述;
- 对时效不敏感,但很在意成本的人;
- 同步调用经常撞上限流(见 /guides/claude-api-error-429-rate-limit),想换个不占用实时额度思路的人。
结论先说
- 批量请求用
messages.batches:每个请求带唯一的custom_id和一份params,params就是普通 Messages 请求的参数。 - 官方写明费用为标准价格的 50%(2026-11-05 核对),多数批次在 1 小时内完成。
- 结果不保证按提交顺序返回,一定要用
custom_id对应。 - 一个批次最多 100,000 个请求或 256 MB,先到为准;24 小时未处理完的请求会过期,结果保留 29 天。
- 失败、取消、过期的请求不收费。
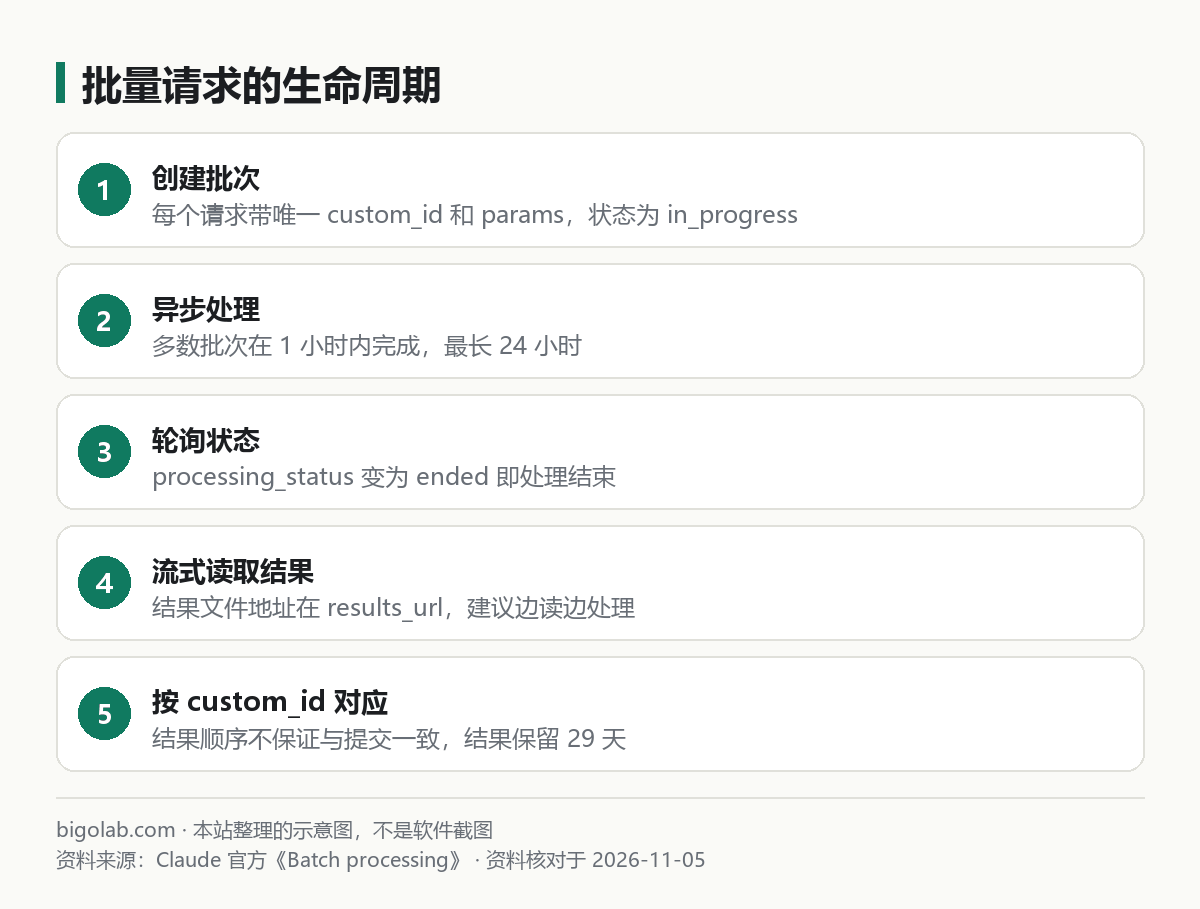
图:本站根据 Claude 官方《Batch processing》 整理的示意图
一、创建批次
Python:
python
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()

batch = client.messages.batches.create(
    requests=[
        Request(
            custom_id="my-first-request",
            params=MessageCreateParamsNonStreaming(
                model="claude-opus-5-5",  # 以官方模型页当天为准
                max_tokens=1024,
                messages=[{"role": "user", "content": "你好,世界"}],
            ),
        ),
        Request(
            custom_id="my-second-request",
            params=MessageCreateParamsNonStreaming(
                model="claude-opus-5-5",
                max_tokens=1024,
                messages=[{"role": "user", "content": "再问一个问题"}],
            ),
        ),
    ]
)
print(batch.id, batch.processing_status)
TypeScript(先安装 @anthropic-ai/sdk):
typescript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

const batch = await client.messages.batches.create({
  requests: [
    {
      custom_id: "my-first-request",
      params: {
        model: "claude-opus-5-5",
        max_tokens: 1024,
        messages: [{ role: "user", content: "你好,世界" }],
      },
    },
    {
      custom_id: "my-second-request",
      params: {
        model: "claude-opus-5-5",
        max_tokens: 1024,
        messages: [{ role: "user", content: "再问一个问题" }],
      },
    },
  ],
});
console.log(batch.id, batch.processing_status);
规则:
custom_id必须在批次内唯一,1 到 64 个字符,只能含字母、数字、连字符和下划线;- 批次里的请求可以混合不同类型:视觉、工具调用、系统提示、多轮对话、思考,官方说几乎都可以;
- 每个请求的
max_tokens至少为 1; - 官方列出批次不支持的参数:
stream: true(批次结果是一个文件,不是流)、speed、fallbacks,以及max_tokens: 0。
一个很容易忽略的点:params 的校验是异步的,写错了不会在创建时报错,而是整批结束后才在结果里以 errored 返回。所以官方建议先用普通的 Messages 请求把请求形状验证一遍,再批量提交。
二、查看进度:轮询 processing_status
刚创建时 processing_status 是 in_progress,全部请求处理完才变成 ended。request_counts 里会记录 processing、succeeded、errored、canceled、expired 各有多少。官方的轮询示例就是循环查询,直到状态变成 ended:
python
import time

while True:
    batch = client.messages.batches.retrieve(batch.id)
    if batch.processing_status == "ended":
        break
    print("仍在处理中……")
    time.sleep(60)
间隔多久查一次自己定,示例里是 60 秒。批次的列表、详情也能在 Claude Console 里看。
三、取结果
批次结束后,每个请求都有结果,四种类型:
| 类型 | 含义 | 是否计费 |
|---|---|---|
succeeded | 成功,带完整的消息 | 计费 |
errored | 出错,没有生成消息,可能是请求不合法或服务端错误 | 不计费 |
canceled | 批次被取消,该请求还没发给模型 | 不计费 |
expired | 批次 24 小时到期时该请求还没处理 | 不计费 |
结果文件可能很大,官方建议流式读取,不要一次全下载:
python
for result in client.messages.batches.results(batch.id):
    outcome = result.result
    if outcome.type == "succeeded":
        print(result.custom_id, outcome.message.content[0].text)
    elif outcome.type == "errored":
        if outcome.error.error.type == "invalid_request_error":
            print("请求本身有问题,要修正后重发:", result.custom_id)
        else:
            print("服务端错误,可直接重试:", result.custom_id)
    elif outcome.type == "expired":
        print("已过期:", result.custom_id)
TypeScript 里用 for await (const result of await client.messages.batches.results(id)),判断 result.result.type 的方式相同。结果文件的网址在批次的 results_url 字段里。
最重要的提醒:结果的顺序不保证与提交一致,官方的示例里第二个请求的结果就排在第一个前面。永远用 custom_id 去对应你的原始数据。
四、取消批次
批次正在处理时可以取消:调用 client.messages.batches.cancel(batch_id)。取消后状态先变成 canceling,用同样的轮询等它变成 ended。终态仍是 ended,里面可能有取消前已经处理好的部分结果,未处理的就是 canceled,不收费。
五、限制与费用
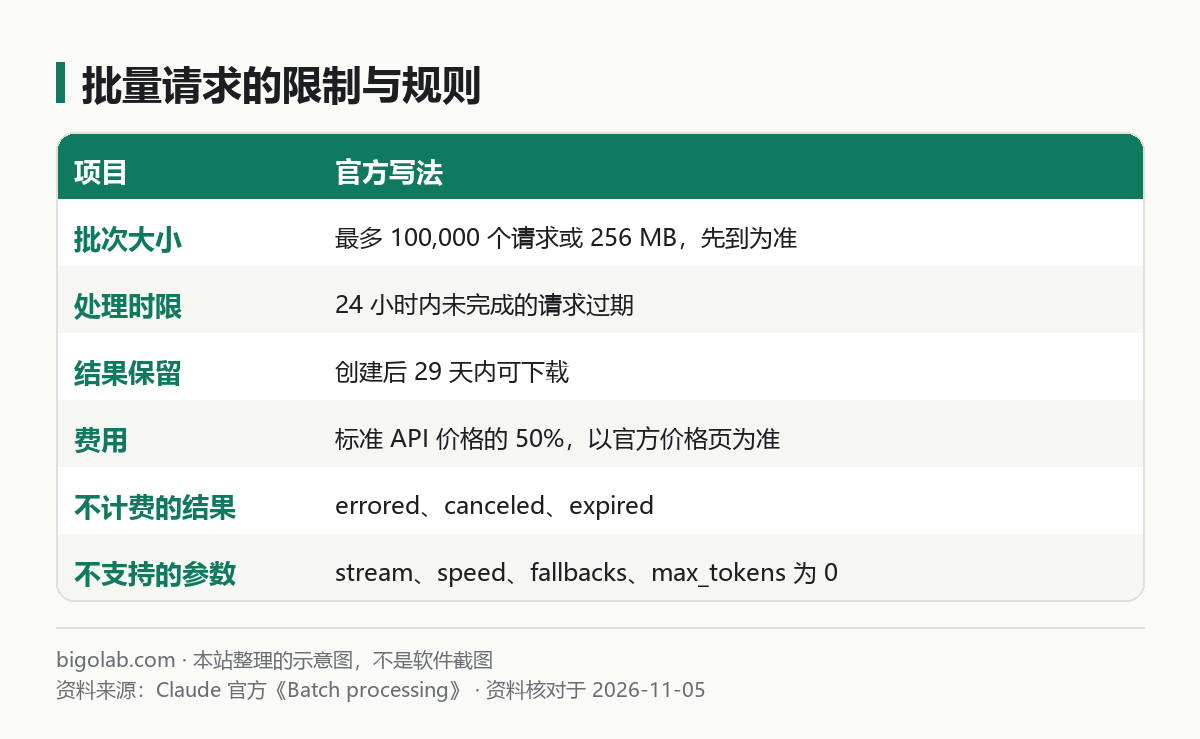
图:本站根据 Claude 官方《Batch processing》 整理的示意图
- 数量与体积:一个批次最多 100,000 个请求或 256 MB,先到者为准;
- 时间:多数批次在 1 小时内完成,但要等整批结束或满 24 小时才能取结果,24 小时未完成的请求过期;
- 保留:结果在创建后 29 天内可下载,之后批次还能查看,结果不能再下载;
- 费用:官方写明所有用量按标准 API 价格的 50% 计费。各模型的具体单价以官方价格页当天为准;
- 花费上限:由于并发处理,批次的花费可能略微超过你在控制台给工作区设置的上限;
- 限流:批次接口本身以及排队等待处理的请求数量都有速率限制;需求高峰时处理会变慢,更多请求可能在 24 小时后过期;
- 数据保留:官方标明批处理不符合零数据保留资格,因为结果要保留 29 天。
六、和提示词缓存一起用
批次里的请求常常共享同一段很长的前缀,比如同一份文档或同一套指令,这时适合用提示词缓存。官方提醒:批次可能超过 5 分钟才处理完,默认的缓存时间可能已经过期,所以共享上下文的批次建议用 1 小时缓存时长以提高命中率。缓存的写法见 /guides/claude-prompt-caching。
常见问题
Q:能和流式一起用吗?
不能,批次里 stream: true 是不支持的。
Q:想批量处理一批 PDF 或图片?
可以,批次支持视觉等类型的请求,写法见 /guides/claude-api-pdf-support 与 /guides/claude-api-image-input。
Q:结果缺了一些请求?
先看 request_counts 里 errored、expired、canceled 各有多少,再逐个看结果类型。expired 通常是批次到期,可以拆小后重新提交。
Q:怎么知道一批请求大概多少 token?
先用 token 计数接口估算,见 /guides/claude-api-count-tokens。
参考资料
- Claude 官方:Batch processing — https://platform.claude.com/docs/en/build-with-claude/batch-processing
- Claude 官方:TypeScript SDK — https://platform.claude.com/docs/en/cli-sdks-libraries/sdks/typescript
- Claude 官方:Claude API errors — https://platform.claude.com/docs/en/api/errors
0 条评论
还没有评论,来抢沙发~