
本文根据 Claude Code 官方《Set up Claude Code in a monorepo or large codebase》和《How Claude remembers your project》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 仓库有几十万行代码,或是 monorepo(一个仓库里很多个包)的开发者;
- 发现 Claude Code 老是读和当前任务无关的文件,上下文很快被占满的人;
- 想让团队成员共用一套「只看相关部分」的配置的人。
结论先说
- 官方的判断是:Claude Code 能处理任意规模的仓库,但为小项目调好的默认设置,在大仓库里会让无关的指令和文件读取塞满上下文窗口,费 token 也拖累效果。
- 第一步最简单:在哪个目录启动。从子目录启动,只加载该目录及各级上层的 CLAUDE.md;从根目录启动,只加载根目录的,子目录的按需加载。
- 需要时再叠加:子目录 CLAUDE.md、
claudeMdExcludes、Read 的 deny 规则、代码智能插件、worktree.sparsePaths、additionalDirectories。官方说这些设置彼此独立、可以叠加。 - 每一项都要分清是个人的还是提交到仓库的:官方在每个小节都写明了该放哪个文件。
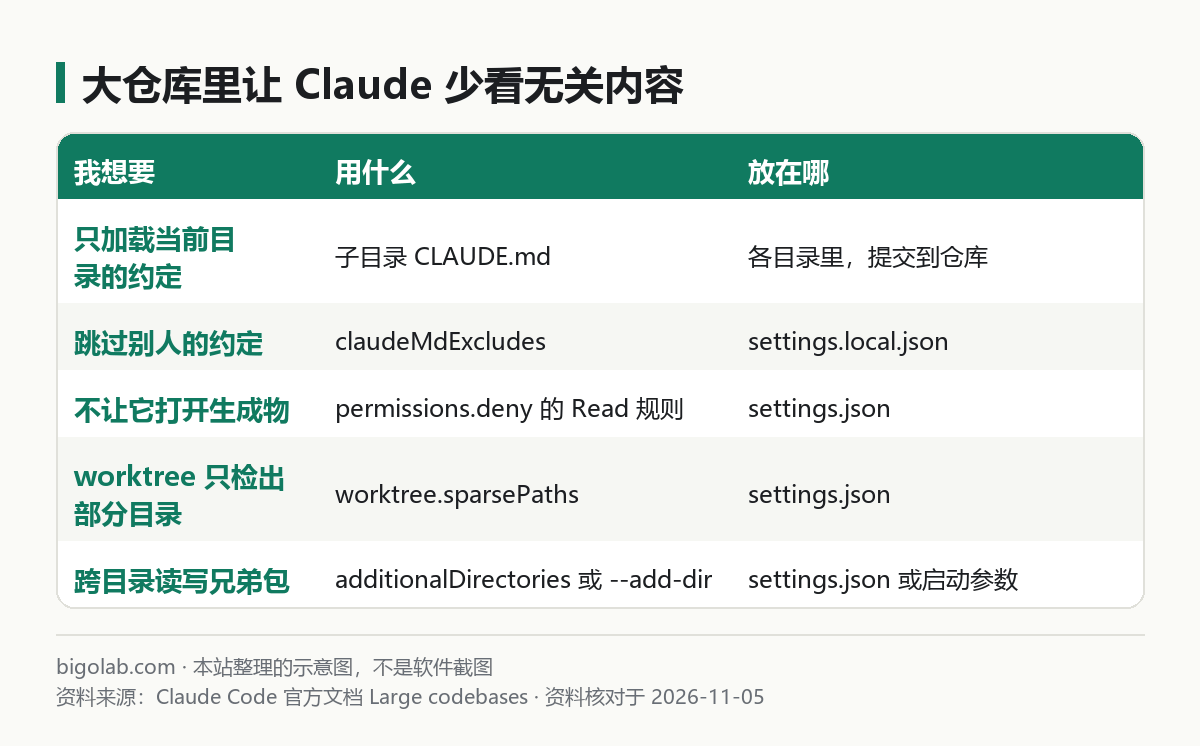
图:本站根据 Claude Code 官方《Set up Claude Code in a monorepo or large codebase》 整理的示意图
一、先决定在哪个目录启动
启动位置决定了三件事:不额外授权就能读写哪些文件、启动时加载哪些 CLAUDE.md、适用哪份项目设置。官方给的对照是:
- 仓库根目录:能访问所有文件;启动时只加载根目录的 CLAUDE.md,子目录的按需加载。适合任务横跨多个包。
- 某个子目录:只能访问该子树,需要更多访问权限要另行授予;加载该目录和各级上层目录的 CLAUDE.md。适合工作集中在一个包。
一个容易踩的点:.claude/settings.json 不会像 CLAUDE.md 那样从父目录继承。你在 packages/api/ 启动,就读 packages/api/.claude/settings.json;每个子目录的设置文件要写得自成一体。具体哪个目录的设置被读取,官方指向《settings》页的「where Claude Code looks for each file」一节。
二、给不同目录各放一份 CLAUDE.md
根目录一个文件写全仓库通用规则,每个包再放自己的。官方的示例很短:
根目录 CLAUDE.md:
markdown
Run package scripts from the package directory, not the monorepo root.
Prefix commit subjects with the package name, for example `api: add rate limiting`.
Never edit files under packages/*/generated/. Run `npm run codegen` in the package instead.packages/api/CLAUDE.md:
markdown
Copy `.env.example` to `.env` before running anything. Tests and the dev server fail without it.
Write database queries with the Knex query builder. Never put raw SQL strings in route handlers.
Never edit a migration after it has merged. Add a new migration instead.
在 packages/api/ 启动,会同时加载这两份,而 packages/web/ 里的规则不会进入上下文。想确认加载了哪些,运行 /context all,看 Memory files 下的列表。每份写什么内容,参见 /guides/claude-code-claude-md-templates-frontend-backend-data。
官方还建议:把 CLAUDE.md 的改动当作普通文档改动在 PR 里评审;新一代模型发布后回头删掉那些只为绕开旧模型缺陷而写的规则;也可以加一个 Stop hook,在会话结束时读取对话记录并提出更新建议。
和 .claude/rules/ 里带 paths 的规则怎么选:想让各目录的负责人自己维护、规则随代码走,用子目录 CLAUDE.md;想所有规则集中在仓库根的 .claude/ 里,或同一条规则要用在很多分散的路径,用 paths 规则。
三、用 claudeMdExcludes 跳过别人的 CLAUDE.md
从根目录启动时,其他团队的包里的 CLAUDE.md 也可能在会话中被按需加载。claudeMdExcludes 可以让指定文件永远不加载。官方建议个人使用时写进 .claude/settings.local.json:
json
{
  "claudeMdExcludes": [
    "**/packages/web/**"
  ]
}
规则是 glob,匹配的是绝对路径,所以相对风格的模式要以 / 开头。官方列的其他写法:"/packages//CLAUDE.md" 排除所有包的 CLAUDE.md 但保留根目录的;"*/packages/legacy-/*" 排除名字以 legacy- 开头的包(连带规则文件);也可以写绝对路径排除某一个文件。
两点限制:它是静态清单,不是按任务切换的开关,今天做 api、明天做 web,官方建议直接换目录启动而不是改排除项;另外,组织统一部署的托管 CLAUDE.md 不能被排除。
四、挡住生成物和第三方代码
官方说明:Claude 的内容搜索默认遵守 .gitignore,所以 node_modules/、dist/、build/ 这类已被忽略的路径本来就不会出现在搜索结果里。需要额外处理的是已提交进仓库的生成代码或第三方 SDK,可以在 permissions.deny 里加 Read 规则:
json
{
  "permissions": {
    "deny": [
      "Read(./**/dist/**/*)",
      "Read(./**/build/**/*)",
      "Read(./**/*.generated.*)",
      "Read(./**/vendor/**/*)"
    ]
  }
}
官方特意把目录写成 /**/ 结尾而不是 /*,这样规则只管目录里的内容,Claude 仍可以 ls dist 或 cd build。放在 .claude/settings.json 提交到仓库,全团队生效;放在 .claude/settings.local.json 只管你自己。
要注意边界:官方说明 deny 规则覆盖内置文件工具,以及 Bash 中 cat、head、grep、find 这类被识别的文件命令;对内置 Grep 和 Glob 工具是尽力排除。但 Bash 里对包含被拒文件的目录做 grep -r,输出里仍可能出现它们;自己打开文件的子进程也不在覆盖范围内。所以它是减少干扰的手段,不是安全边界。想硬性防护可参考 /guides/claude-code-permission-modes。
五、少读文件:代码智能插件
在大仓库里查「这个函数定义在哪、谁在调用」,可能要读很多文件、跑很多次 grep。官方的代码智能插件让 Claude 连接语言服务器,直接跳转定义、查引用。官方示例是在 claude 提示符里安装 TypeScript 插件:
text
/plugin install typescript-lsp@claude-plugins-official
官方列出两种常见安装失败:提示 Marketplace "claude-plugins-official" not found,先用 /plugin marketplace add anthropics/claude-plugins-official 添加市场再重试;提示 Plugin "<name>" not found in marketplace "claude-plugins-official",用 /plugin marketplace update claude-plugins-official 刷新目录再重试。插件还要求你的机器上装有该语言对应的语言服务器程序,且从官方市场安装需要能访问 GitHub。插件的一般用法见 /guides/claude-code-plugins-marketplace。
六、worktree 只检出需要的目录
--worktree 会在新的 git worktree 里开会话,默认检出整个仓库。大仓库里可以用 worktree.sparsePaths,借助 git sparse-checkout 只写入列出的目录和根目录下的文件:
json
{
  "worktree": {
    "sparsePaths": [
      ".claude",
      "packages/api",
      "packages/shared"
    ],
    "symlinkDirectories": [
      "node_modules"
    ]
  }
}
路径相对仓库根目录;根目录下的文件(如 package.json、锁文件)总会被检出,但根目录下的目录不会,所以想在 worktree 里用到根目录的 .claude/settings.json 或 .claude/rules/,要把 .claude 写进去。symlinkDirectories 让每个 worktree 的 node_modules/ 链接回主仓库那份,避免重复占用磁盘。官方还提醒:这些设置是在 worktree 创建前从你启动的目录读取的,创建后会话的工作目录是 worktree 根,所以 worktree 里需要的权限规则、hook,要放在仓库根目录的 .claude/settings.json。worktree 的基础用法见 /guides/claude-code-worktree。
七、从子目录启动又要改兄弟包
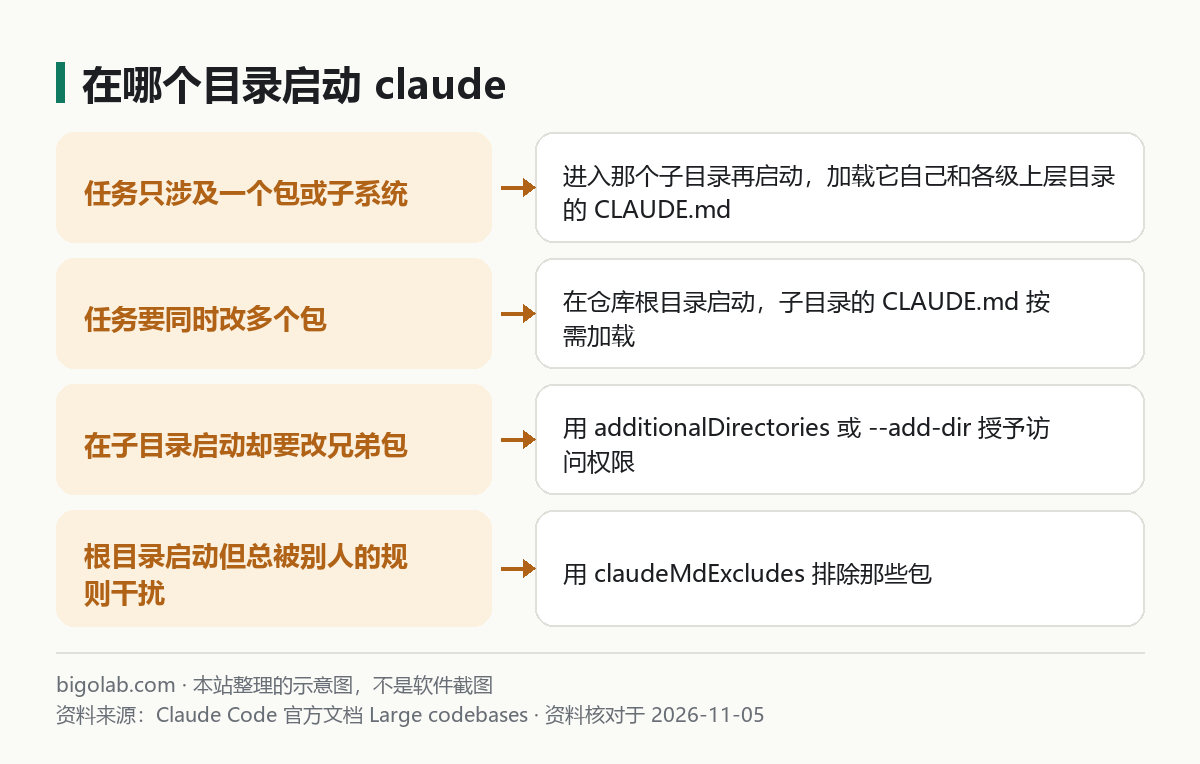
图:本站根据 Claude Code 官方《Set up Claude Code in a monorepo or large codebase》 整理的示意图
在 packages/api/ 启动时,默认只能读写这个目录。要改共享类型这类跨包的任务,有两种授权方式:
json
{
  "permissions": {
    "additionalDirectories": [
      "../shared",
      "../web"
    ]
  }
}或启动时临时加:claude --add-dir ../shared。相对路径从启动目录算起。官方列了一张差别表:用 additionalDirectories 设置添加的目录,永远不加载它的 CLAUDE.md、规则和技能;用 --add-dir 或 /add-dir 添加的目录,技能会加载,CLAUDE.md 和规则需要再设环境变量 CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1 才加载。
八、一次改动跨多个包时
官方的两条建议:把共享类型的修改和它的所有调用点放在同一个会话里让 Claude 一起完成,决策才能前后一致;改之前先进入计划模式(见 /guides/claude-code-plan-mode),Claude 会把计划写进文件,长会话被压缩上下文之后,Claude Code 会重新注入这份计划文件。上下文压缩的机制见 /guides/claude-code-context-compact。
常见问题
Q:Claude 还是老读到我不想让它读的目录?
先看是否已在 .gitignore 中;已提交的目录用 Read deny 规则;注意 deny 对 Bash 里的 grep -r 不是完全有效。
Q:设置写了却没生效?
多半是放错层级。项目的 settings.json 不继承父目录;worktree 里读的是 worktree 根目录的那份。
Q:每次启动都很慢、额度掉得快?
上下文里无关内容越多,消耗越大。先按本文收窄范围,再考虑额度问题,需要更高额度可以看 Claude Code 订阅方案。
参考资料
- Claude Code 官方:Set up Claude Code in a monorepo or large codebase — https://code.claude.com/docs/en/large-codebases
- Claude Code 官方:How Claude remembers your project — https://code.claude.com/docs/en/memory
0 条评论
还没有评论,来抢沙发~