
本文根据 Claude Code 官方《How Claude remembers your project》和《Set up Claude Code in a monorepo or large codebase》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。官方没有给出分技术栈的模板,三份模板是本站自己拟的示例。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 刚装好 Claude Code(见 /guides/claude-code-getting-started),不知道 CLAUDE.md 具体怎么落笔的人;
- 已经看过 /guides/claude-md-agents-md 里的通用骨架,想要更贴近自己技术栈的版本的人;
- 项目里同时有前端、后端、数据脚本,想按目录拆开管理的人。
结论先说
- 官方的核心要求只有几条:每个文件目标少于 200 行;写成能检查的句子;用标题和列表分组;不要互相矛盾。
- 只写 Claude 读代码猜不到的东西:启动、检查、测试的真实命令,目录约定,容易踩的坑。
- 只对一部分文件有用的规则,别塞进根文件:放进
.claude/rules/并用paths限定,官方说它们只在 Claude 处理匹配文件时才加载。 - 模板是起点不是终点:先用
/init出初稿,再对照下面的模板删减,最后用/context all确认真的加载了。 - CLAUDE.md 不是强制规则:官方写明 Claude 把它当上下文,要硬性拦截请用 hook(见 /guides/claude-code-hooks)。
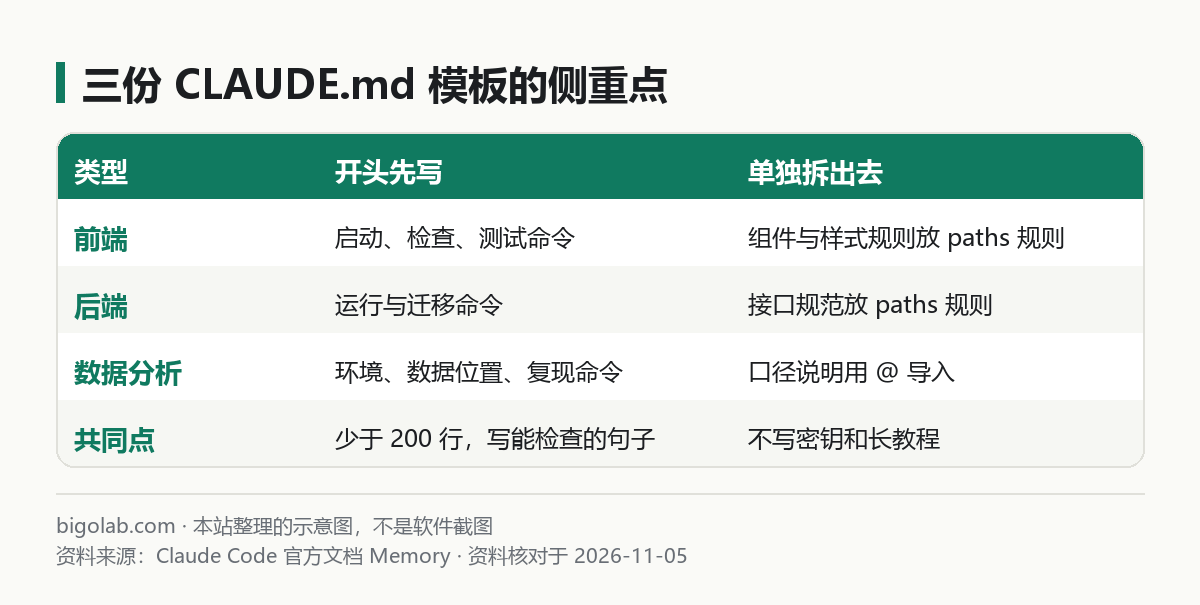
图:本站根据 Claude Code 官方《How Claude remembers your project》 整理的示意图
一、先记住官方的写法原则
官方给的示例是把含糊的话换成可验证的话:「使用 2 个空格缩进」比「代码格式要规范」好,「提交前运行 npm test」比「记得测试」好,「接口处理函数放在 src/api/handlers/」比「文件要组织好」好。
另外官方说明了加载方式:从当前工作目录一直到上层各级目录里的 CLAUDE.md 都会在启动时加载,并且是拼接而不是互相覆盖;子目录里的 CLAUDE.md 则是在 Claude 读写那个子目录里的文件时才按需加载。块级 HTML 注释(<!-- 给维护者的备注 -->)会在注入上下文前被去掉,可以放心写给人看的说明,不占 token。
放在哪个位置,通用教程已经讲过,简单说:团队共享的写在项目根目录的 ./CLAUDE.md 或 ./.claude/CLAUDE.md 并提交到仓库;只给自己看的写在 ./CLAUDE.local.md 并加入 .gitignore。
二、模板一:前端项目
下面以「React + TypeScript + 组件库」为例。命令都是占位,请换成你 package.json 里真实存在的脚本。
markdown
# 项目说明
[公司官网前端],React + TypeScript,包管理器 [pnpm]。

## 常用命令
- 本地启动:`pnpm dev`
- 类型检查:`pnpm typecheck`(改完一组文件后必须通过)
- 单个测试:`pnpm test -- src/components/Button`(优先跑单个,别每次跑全量)
- 代码检查:`pnpm lint`

## 目录约定
- `src/components/`:通用组件,每个组件一个文件夹,含 `index.tsx` 和同名测试
- `src/pages/`:页面,只做组装,不写业务逻辑
- `src/hooks/`:自定义 hook,以 `use` 开头命名
- 接口请求统一走 `src/api/client.ts`,页面里不要直接写 fetch

## 代码规范(只写和默认习惯不同的)
- 组件用函数组件,不写 class 组件
- 样式用 [CSS Modules],不写内联 style
- 用户可见的文案统一放 `src/locales/`,不要写死在组件里

## 工作流程
- 新增或修改组件时,同时补一个最小的测试
- 提交信息用 `feat:` / `fix:` 开头
- 不要直接修改 `src/generated/` 下的文件,运行 `pnpm codegen` 重新生成

## 已知的坑
- 本地需要 `.env.local`,字段见 `.env.example`
这份模板大约 25 行,离 200 行的上限很远。继续往里加之前先问一句:这条规则只对一部分文件有效吗?如果是,见第五节。
三、模板二:后端接口项目
以「Python + FastAPI + 数据库」为例,同样只是占位示例。
markdown
# 项目说明
[订单服务]后端,Python [3.12] + FastAPI + PostgreSQL,依赖管理用 [uv]。

## 常用命令
- 启动开发服务:`uv run fastapi dev app/main.py`
- 运行测试:`uv run pytest tests/ -x`(单个文件:`uv run pytest tests/test_orders.py`)
- 代码检查:`uv run ruff check .`
- 生成迁移:`uv run alembic revision --autogenerate -m "说明"`
- 应用迁移:`uv run alembic upgrade head`

## 目录约定
- `app/routers/`:路由,只做参数校验和调用服务层
- `app/services/`:业务逻辑
- `app/models/`:数据库模型;改模型后必须生成迁移
- `tests/`:与 `app/` 结构一一对应

## 代码规范
- 金额一律用整数「分」存储,不用浮点数
- 所有接口返回统一的错误结构:`{"code": ..., "message": ...}`
- 不要在路由函数里写原始 SQL

## 工作流程
- 改动超过 3 个文件时,先列出计划再动手
- 已合并的迁移文件不能再修改,需要变更就新建迁移
- 不要把任何密钥写进代码,读取环境变量,示例见 `.env.example`

## 已知的坑
- 测试依赖本地数据库,先执行 [docker compose up -d db]
后端的坑多半在「怎么跑起来」和「迁移怎么走」,所以命令和迁移规则要写在最前面。至于「不要把密钥写进代码」,官方的提醒是:CLAUDE.md 本身也会进入上下文,所以密钥、密码、连接串也别写进这个文件里,只写「从哪个环境变量读」。
四、模板三:数据分析项目
数据项目最容易出问题的是「环境」和「口径」,模板就围绕这两点写。
markdown
# 项目说明
[月度销售分析],Python + pandas + Jupyter,结果输出为图表和 Markdown 报告。

## 环境与命令
- 创建环境:`[uv sync]`
- 运行全部分析脚本:`[uv run python run_all.py]`
- 只重跑某个月:`[uv run python run_all.py --month 2026-10]`

## 数据位置
- 原始数据:`data/raw/`(只读,任何情况下都不要修改或删除)
- 清洗后数据:`data/clean/`(可由脚本重新生成)
- 输出:`reports/`

## 口径约定
- 「销售额」= 订单实付金额,不含退款;详细定义见 @docs/metrics.md
- 日期统一用 [UTC+8],列名用小写下划线

## 工作方式
- 先说明准备怎么算,再写代码;结果必须同时给出样本量
- 画图时每张图写明数据时间范围
- 不要在 notebook 里写死文件的绝对路径

## 已知的坑
- `data/raw/` 里有几个月份缺少 [退款] 列,脚本里已特殊处理,改动前先看 `clean.py`
注意最后一节里的 @docs/metrics.md:官方的 @路径 导入语法会把被引用文件和 CLAUDE.md 一起展开加载,相对路径以包含它的文件为准,最多递归四层。官方特别提醒:导入只是帮你组织内容,不会减少上下文占用,因为被导入的文件会一起加载。想省上下文,要靠下一节的规则拆分。
五、把只管一部分文件的规则拆出去
官方的做法是在 .claude/rules/ 下放一个主题一个文件的 Markdown,并用前置字段 paths 限定适用范围。没有 paths 的规则和 .claude/CLAUDE.md 一样在启动时加载;有 paths 的规则只在 Claude 对匹配文件进行读、写、编辑时才加载。paths 是规则文件里唯一会被读取的字段。
比如把前端模板中的组件规范拆出来:
markdown
---
paths:
  - "src/components/**/*.tsx"
---

# 组件规则

- 每个组件一个文件夹,含 `index.tsx` 和同名测试文件
- 组件的 props 类型用 `interface` 声明并导出
- 不要在组件内直接发请求,通过 `src/hooks/` 里的 hook 获取数据
保存为 .claude/rules/components.md 即可。官方还说可以用花括号一次写多个后缀,例如 "src/**/*.{ts,tsx}"。
如果你的仓库把前后端放在一起,官方的大仓库指南给出另一条路:根目录一个 CLAUDE.md 写全仓库通用规则,每个子目录(比如 packages/api/)再放自己的 CLAUDE.md。两者怎么选,官方的区分是:希望由各目录的负责人自己维护、规则跟着代码走,用子目录 CLAUDE.md;希望所有规则集中在一处,或同一条规则要作用于很多分散的路径,用 .claude/rules/ 加 paths。更详细的大仓库设置见 /guides/claude-code-large-repo-focus-directories。
六、写好之后怎么验证
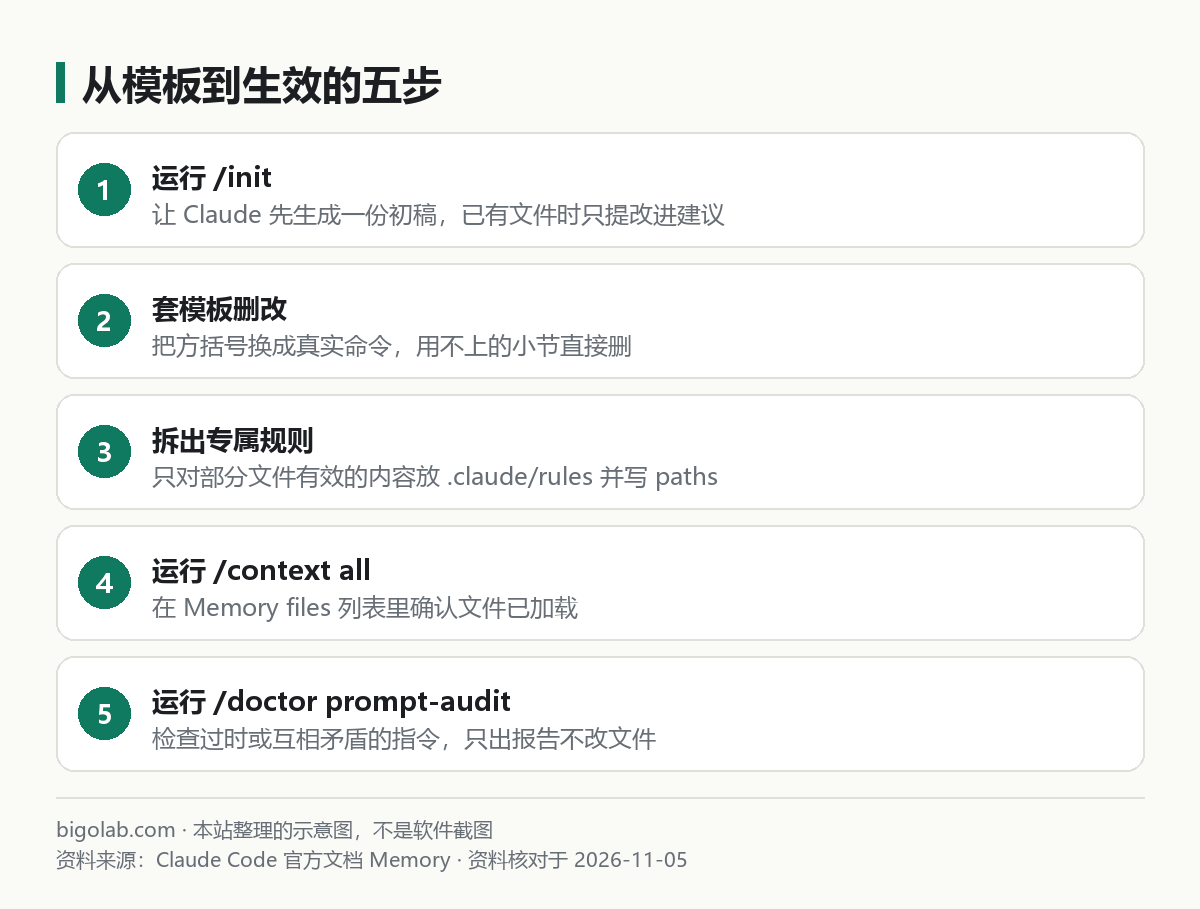
图:本站根据 Claude Code 官方《How Claude remembers your project》 整理的示意图
- 在项目里运行
/init。已有 CLAUDE.md 时它只会提出改进建议而不是覆盖。如果想要多轮问答式的流程,官方说法是先把环境变量CLAUDE_CODE_NEW_INIT设为1再运行。 - 开一个新会话,运行
/context all,在 Memory files 列表里确认你的文件出现了。 - 运行
/doctor prompt-audit,让 Claude 找出过时、互相矛盾或引用了不存在文件的内容。官方说明它只给报告和修改建议,你要求之后才会改文件;这个命令需要 Claude Code v2.1.283 或更高版本。 - 观察真实行为:让 Claude 做一件小事,看它有没有按模板里的命令去跑。没有的话,多半是写得太含糊或和别的规则冲突。
什么时候该往里加内容?官方列了几个信号:Claude 第二次犯同一个错;代码审查发现了它本该知道的约定;你在新会话里又敲了一遍上次的纠正;新同事也需要同样的背景。反过来,没人遇到过的问题不用提前写。
常见问题
Q:写了「不要修改 xxx」,Claude 还是改了?
官方明说 CLAUDE.md 是上下文而非强制配置。要硬性禁止,用 PreToolUse hook,或在权限里写 deny 规则,见 /guides/claude-code-hooks 和 /guides/claude-code-settings-json。
Q:模板可以直接整份复制吗?
可以当起点,但方括号和命令必须换成真实的。写了不存在的命令,比不写更糟。
Q:文件越写越长怎么办?
官方的做法:超过 200 行就把只管一部分代码的内容挪到带 paths 的规则里,多步骤流程挪到技能里(见 /guides/skill-vs-mcp-vs-subagent-vs-hook)。
Q:用得多了额度不够?
CLAUDE.md 越长,每次会话占用的上下文越多。如果日常使用 Claude Code 额度吃紧,可以了解 Claude Code 订阅方案,同时也应当先把文件精简。
相关教程
- /guides/claude-md-agents-md:CLAUDE.md 放置位置与 AGENTS.md 的区别
- /guides/claude-code-best-practices:官方最佳实践
- /guides/claude-code-context-compact:上下文与压缩
参考资料
- Claude Code 官方:How Claude remembers your project — https://code.claude.com/docs/en/memory
- Claude Code 官方:Set up Claude Code in a monorepo or large codebase — https://code.claude.com/docs/en/large-codebases
0 条评论
还没有评论,来抢沙发~