
本文根据 Claude 官方《Token counting》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 Anthropic 官方网站。API 是按用量计费的独立服务,与 Claude 订阅分开计算,Key 的获取见 /guides/claude-api-key-console。
适用于谁
- 想在正式调用前估算一次请求、一批文件会花多少钱的开发者;
- 提示词越写越长,担心塞不进上下文窗口的人;
- 想按长度把请求分给不同模型,做“路由”的人;
- 从旧模型迁移到新模型,发现 token 数变了的人。
结论先说
- 官方提供免费的计数接口
/v1/messages/count_tokens,参数和创建消息几乎一样,返回input_tokens。 - 它只数输入,数的是你发出去会占多少 token,不会真的生成回答。
- 结果是估算,和实际用量可能有小幅差异;系统自动添加的 token 不向你收费。
- 有些输入不能数:服务器工具、MCP 连接器、
url或file来源的图片和 PDF。图片和 PDF 要用 base64。 - 新模型的分词器不同:Claude 4.7 及之后的模型,同样的文字大约多出 30% 的 token,换模型要重新数。
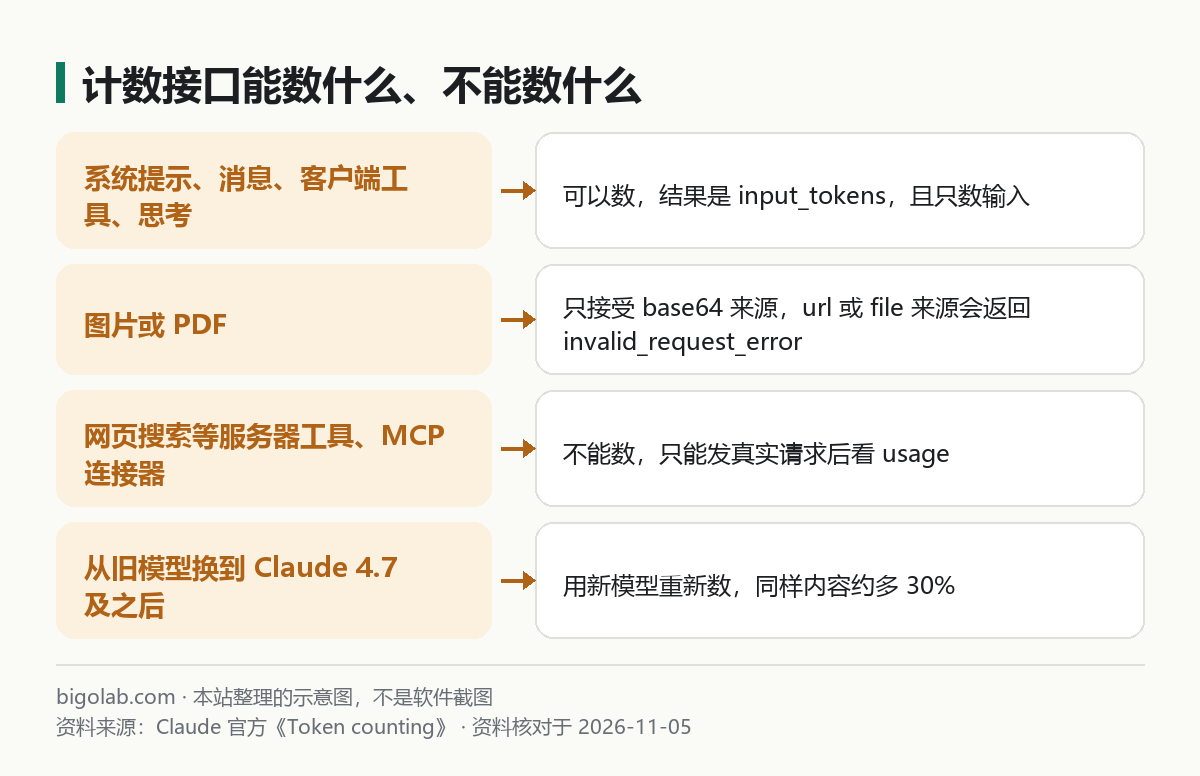
图:本站根据 Claude 官方《Token counting》 整理的示意图
一、最小示例
Python:
python
import anthropic

client = anthropic.Anthropic()

count = client.messages.count_tokens(
    model="claude-opus-5-5",  # 以官方模型页当天为准
    system="你是一位科学家",
    messages=[{"role": "user", "content": "你好,Claude"}],
)

print(count.input_tokens)
TypeScript:
typescript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

const count = await client.messages.countTokens({
  model: "claude-opus-5-5",
  system: "你是一位科学家",
  messages: [{ role: "user", content: "你好,Claude" }],
});

console.log(count.input_tokens);
响应形如 { "input_tokens": 14 }。注意:请求里要写 model,因为不同模型的分词器不一样,数出来的数不同。
二、带工具、图片、PDF 的计数
计数接口接受与创建消息相同的结构,所以可以把你真正要发的请求原样拿来数:
- 带工具:把
tools一起传进去,工具定义也占 token。官方示例里一个get_weather工具加一句提问,计数是几百个 token,远多于单独一句话; - 带图片:用 base64 来源的
image块,规则见 /guides/claude-api-image-input; - 带 PDF:用 base64 来源的
document块,规则见 /guides/claude-api-pdf-support; - 带思考:官方写明当前轮的思考计入输入 token;之前轮次的思考块是否计入,取决于模型是保留全部历史思考,还是只保留最近一轮。
工具的写法见 /guides/claude-tool-use-basics。
三、哪些输入不能数
官方列出,下面这些输入对 Messages API 是合法的,但计数接口会返回 invalid_request_error:
- 服务器工具,比如网页搜索、网页抓取、代码执行、工具搜索(顾问工具除外);
- MCP 连接器;
- 来源为
url或file的image或document块。
做法:图片和 PDF 先下载读成 base64 再数;用了服务器工具或 MCP 服务器的请求,实际用量只能在真实请求返回的 usage 里看。
四、为什么是估算,换模型为什么不一样
官方明确说这是估算值:有时实际输入 token 与计数相差很少。计数可能包含 Anthropic 为系统优化自动添加的 token,但这部分不向你收费,账单只算你自己的内容。
另一个容易踩的地方:Claude 4.7 及之后的模型、以及 Fable 和 Mythos 系列使用新分词器,同样的文字大约多出 30% 的 token,具体看内容类型。官方因此要求,从旧模型迁移时,不要拿旧模型的计数去估新模型的费用或上下文占用,而是用要用的那个 model 重新数一遍。想知道差别有多大,就把同一份请求用旧模型和新模型各数一次,对比两个 input_tokens。
五、限额:免费,但有每分钟请求数
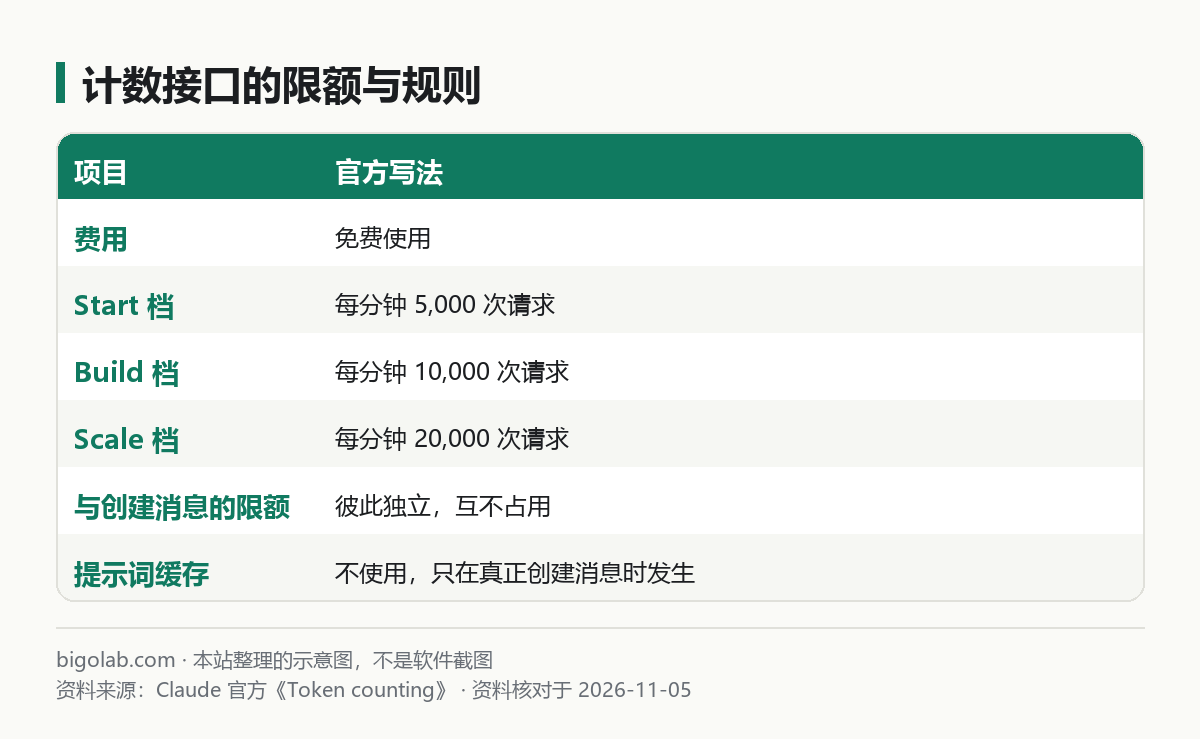
图:本站根据 Claude 官方《Token counting》 整理的示意图
官方写明计数接口免费,但受每分钟请求数限制,按你的用量档位:
| 档位 | 每分钟请求数 |
|---|---|
| Start | 5,000 |
| Build | 10,000 |
| Scale | 20,000 |
计数和创建消息的限额各算各的,互不占用。需要更高限额,官方说可以在 Claude Console 的限额(Rate limits)页面用“Request tier increase”申请提升档位;限流报错 429 的排查见 /guides/claude-api-error-429-rate-limit。还有一点:计数不使用提示词缓存,即使传了 cache_control,缓存也只在真正创建消息时才发生,所以它数出来的是“不命中缓存”的输入量,缓存的省钱原理见 /guides/claude-prompt-caching。
六、发完请求后,用 usage 核对
每次真正的调用,响应里都有 usage,这是账单的依据。TypeScript SDK 页的示例输出是 { input_tokens: 25, output_tokens: 13 }。用了提示词缓存时,还会多出缓存写入和缓存读取的字段。开启思考时,usage.output_tokens_details.thinking_tokens 会告诉你输出里有多少是思考(流式时这个明细只出现在最后一个 message_delta 事件里,事件顺序见 /guides/claude-api-streaming)。
七、一个估算费用的小函数
下面是本站写的示意,把官方价格页当天的单价填进去(单位通常是每百万 token 多少钱,以官方为准):
python
def estimate_cost(input_tokens, expected_output_tokens, in_price_per_mtok, out_price_per_mtok):
    return (input_tokens * in_price_per_mtok + expected_output_tokens * out_price_per_mtok) / 1_000_000

count = client.messages.count_tokens(model="claude-opus-5-5", messages=[...])
# 单价请自行从官方价格页填写,这里不写具体数字
# cost = estimate_cost(count.input_tokens, 800, 单价_输入, 单价_输出)
输出 token 无法事先数出来,只能按你预期的回答长度和 max_tokens 来估一个范围。批量请求可以按官方的批量折扣再估一次,见 /guides/claude-api-message-batches。
常见问题
Q:计数接口会产生费用吗?
官方写明免费,受每分钟请求数限制。
Q:数出来的和账单不一样?
这是估算,加上系统添加的 token 不收费、缓存命中会改变实际计费,所以会有差别;以真实请求返回的 usage 为准。
Q:换了新模型,token 数怎么变多了?
Claude 4.7 及之后的模型分词器不同,同样内容大约多约 30%,需要用新模型重新数。
Q:想数带网页搜索工具的请求?
计数接口不支持服务器工具,只能发真实请求后看 usage。
参考资料
- Claude 官方:Token counting — https://platform.claude.com/docs/en/build-with-claude/token-counting
- Claude 官方:TypeScript SDK — https://platform.claude.com/docs/en/cli-sdks-libraries/sdks/typescript
- Claude 官方:Extended thinking — https://platform.claude.com/docs/en/build-with-claude/extended-thinking
0 条评论
还没有评论,来抢沙发~