
本文根据 Claude 官方《Streaming messages》和《Claude API errors》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 Anthropic 官方网站。API 是按用量计费的独立服务,与 Claude 订阅分开计算,Key 的获取见 /guides/claude-api-key-console。
适用于谁
- 想做聊天界面、让回答逐字出现的开发者;
- 请求经常超时,听说“要用流式”却不知道怎么改的人;
- 已跑通第一个请求(见 /guides/claude-api-python-quickstart),想往下走一步的人。
结论先说
- 最省事的写法是 SDK 的
stream助手:Python 遍历text_stream,TypeScript 注册on("text", ...),不必自己解析事件。 - 底层是 SSE 事件流,顺序固定:
message_start,若干个内容块,若干个message_delta,最后message_stop。 - 工具调用的参数是一段一段的部分 JSON(
input_json_delta),要拼完再解析。 - 流可以在返回 200 之后才出错,所以要处理
error事件,不能只看状态码。 max_tokens很大时必须流式;不想逐个处理事件,就用“流式收集、最后拿完整消息”的写法。
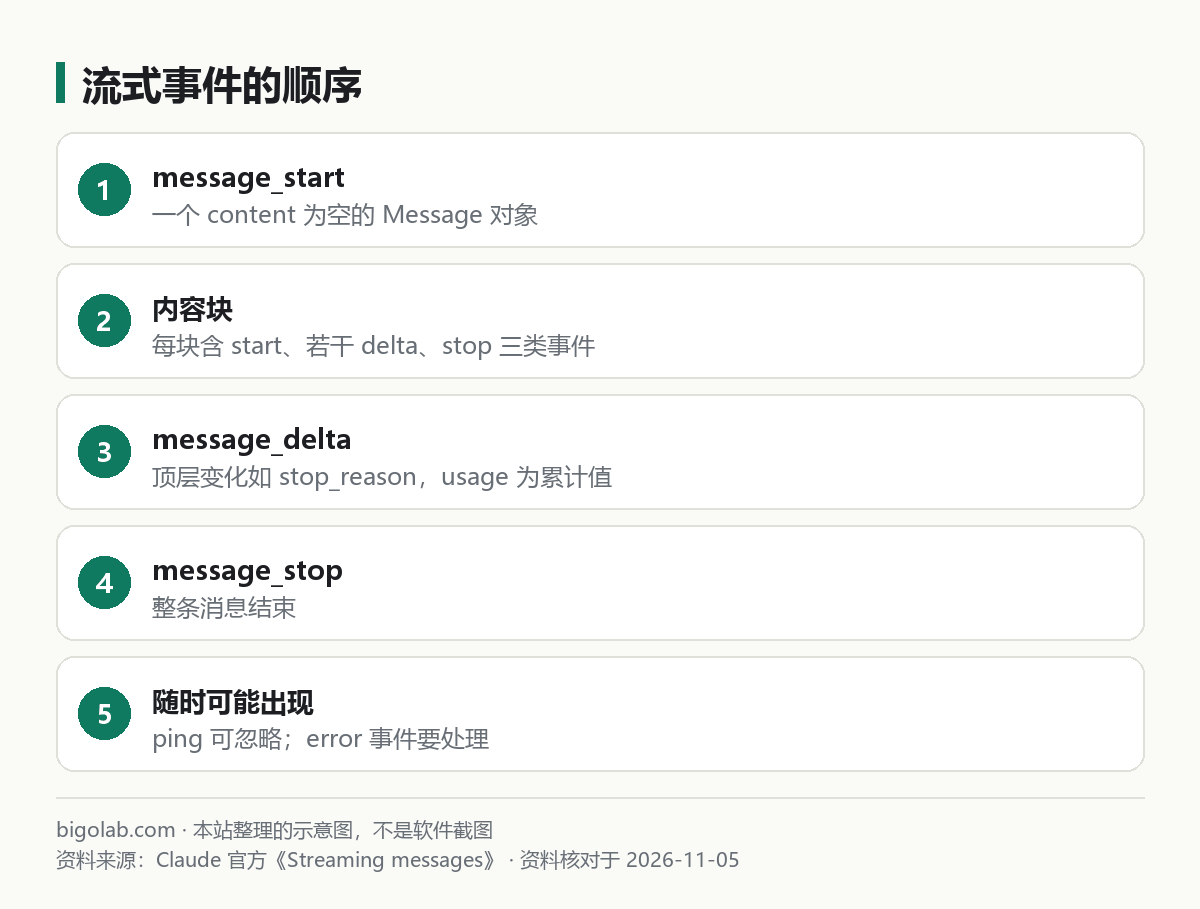
图:本站根据 Claude 官方《Streaming messages》 整理的示意图
一、最简单的写法:SDK 的 stream 助手
Python:
python
import anthropic

client = anthropic.Anthropic()

with client.messages.stream(
    max_tokens=1024,
    messages=[{"role": "user", "content": "用三句话介绍流式输出"}],
    model="claude-opus-5-5",  # 以官方模型页当天为准
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
TypeScript(先安装 @anthropic-ai/sdk,基础用法见 /guides/claude-api-typescript-quickstart):
typescript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

await client.messages
  .stream({
    model: "claude-opus-5-5",
    max_tokens: 1024,
    messages: [{ role: "user", content: "用三句话介绍流式输出" }],
  })
  .on("text", (text) => {
    process.stdout.write(text);
  });
两段代码做的是同一件事:每来一小段文字就打印一小段。API 密钥默认从环境变量 ANTHROPIC_API_KEY 读取。
二、需要完整消息时:流式收集,最后一次取出
有些请求本身就需要很长的输出,你并不想一段段显示,只想要最后的完整结果。官方的做法是让 SDK 在内部用流式,最后返回和普通调用一模一样的 Message 对象:
python
with client.messages.stream(
    max_tokens=128000,
    messages=[{"role": "user", "content": "写一份很长的分析……"}],
    model="claude-opus-5-5",
) as stream:
    message = stream.get_final_message()

for block in message.content:
    if block.type == "text":
        print(block.text)
TypeScript 对应的是 await stream.finalMessage()。官方在这里反复强调的原因是:把 max_tokens 设得很大又不用流式,网络可能在中途掐断空闲连接,请求会失败或超时;SDK 还会在非流式请求预计超过约 10 分钟时直接报错。所以大输出统一走流式,是官方的推荐。
三、事件的顺序
直接发 stream: true 的原始请求,会收到 SSE 事件。每个事件有名字(例如 event: message_stop),数据里的 type 与之对应。完整顺序:
message_start:一个Message对象,content是空的;- 一个或多个内容块,每个块依次是
content_block_start、若干content_block_delta、content_block_stop;index对应最终content数组里的位置; - 一个或多个
message_delta:对最终消息的顶层改动,比如stop_reason; message_stop。
中间可能夹着任意数量的 ping,忽略即可。官方特别提醒一点:message_delta 里 usage 的 token 数是累计值,不要每次相加。
官方还明确说,将来可能新增事件类型,你的代码要能容忍不认识的事件,而不是直接崩溃。
四、各种 delta 长什么样
content_block_delta 里的 delta 有几种:
text_delta:普通文字,text字段是新增的那一小段;input_json_delta:工具调用的参数,partial_json是部分 JSON 字符串。最终的tool_use.input是对象,所以要把各段字符串累加,等content_block_stop到了再解析。官方说 Python 和 TypeScript 的流式助手可以增量地给你解析后的input。注意官方的提示:当前模型一次只会发出input里一个完整的键值对,所以用工具时事件之间可能有停顿;thinking_delta:开启思考后,思考内容的增量,对应thinking块的thinking字段;signature_delta:思考块的签名,在content_block_stop之前发送,用来校验思考块没被改过。
思考相关的参数见 /guides/claude-api-extended-thinking。把思考的 display 设为 "omitted" 时,不会再流式发送思考文字,只会各有一个空的 thinking_delta 和一个 signature_delta,官方说这样第一段正文出现得更早,但思考 token 仍会计费。工具调用的完整流程见 /guides/claude-tool-use-basics。
五、一个手写的原始事件循环
只想看懂原理,或者不用 SDK 助手时,可以直接遍历事件。下面是本站按官方事件名写的示意,不是官方原文:
python
with client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "你好"}],
    stream=True,
) as events:
    for event in events:
        if event.type == "content_block_delta" and event.delta.type == "text_delta":
            print(event.delta.text, end="", flush=True)
TypeScript 的写法是 for await (const event of stream),判断条件相同。需要中途取消时,TypeScript 可以 break 退出循环,或调用 stream.controller.abort()。
六、流里的错误怎么处理
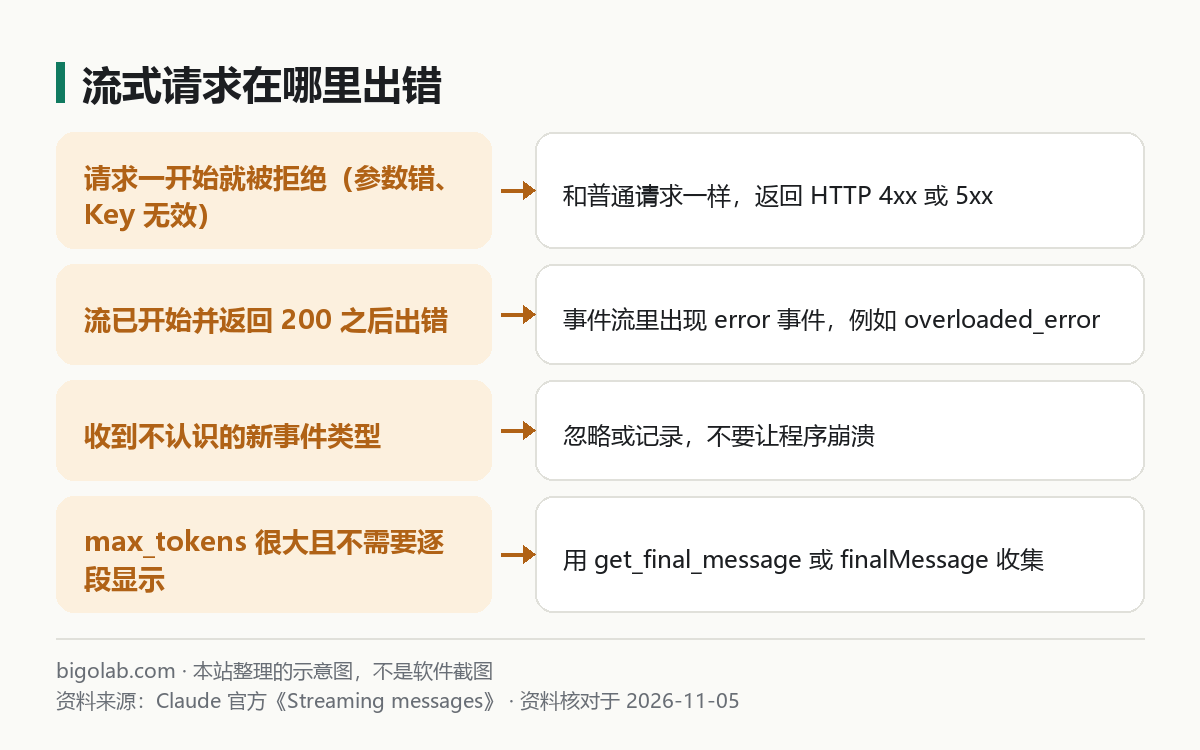
图:本站根据 Claude 官方《Streaming messages》 整理的示意图
普通请求出错,你拿到的是 4xx 或 5xx 状态码。流式请求不一样:
- 请求一开始就被拒绝(比如参数错误、Key 无效),仍是 HTTP 错误码;
- 流已经开始、返回了 200 之后出错,你会在事件流里收到一个
error事件,例如高负载时的overloaded_error,它对应非流式场景的 HTTP 529。
所以循环里要识别 error 事件,并决定是重试还是把已收到的内容先保存下来。官方没有在这一页给出统一的断点续传办法,具体策略要自己设计。排查 429 和 529 请看 /guides/claude-api-error-429-rate-limit 与 /guides/claude-api-error-529-overloaded。
常见问题
Q:流式会更便宜吗?
不会。计费看 token,不看是否流式。流式改善的是首字出现的速度和长请求的稳定性。
Q:流式能和 Batch 一起用吗?
不能。官方的批处理文档列出 stream: true 是批请求不支持的参数,批量请求见 /guides/claude-api-message-batches。
Q:我只想要最终 JSON,怎么办?
用流式收集拿完整消息,或者看 /guides/claude-api-structured-outputs。
参考资料
- Claude 官方:Streaming messages — https://platform.claude.com/docs/en/build-with-claude/streaming
- Claude 官方:Claude API errors — https://platform.claude.com/docs/en/api/errors
0 条评论
还没有评论,来抢沙发~