
本文根据 Claude 开发者平台官方文档《Web search tool》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 已经跑通 Claude API 基础调用,想让回答带上最新信息的开发者;
- 做问答、调研类应用,需要限定来源网站、显示引用的人。
这里讲的是 API 里的工具,不是 claude.ai 网页的联网搜索按钮(后者见 /guides/claude-web-search)。基础调用见 /guides/claude-api-python-quickstart,工具调用的通用机制见 /guides/claude-tool-use-basics。
结论先说
- 官方定义: 联网搜索工具让 Claude 直接访问实时网页内容,回答里带有来自搜索结果的引用。你在请求的
tools里加一项,由 API 一侧执行搜索,不需要你自己写搜索代码。 - 有三个版本:
web_search_20250305是基础搜索;web_search_20260209增加动态过滤;web_search_20260318再增加response_inclusion控制。 - 搜不搜由 Claude 判断,官方说可以通过系统提示词引导它更爱搜或更少搜;要硬性限制,用
max_uses。 - 域名过滤二选一:
allowed_domains和blocked_domains不能同时给,否则 API 返回 400。 - 计费: 搜索用量在 token 费用之外另算,官方页面写的是每 1000 次搜索 10 美元;出错的搜索不计费。具体以官方页面当前显示为准。
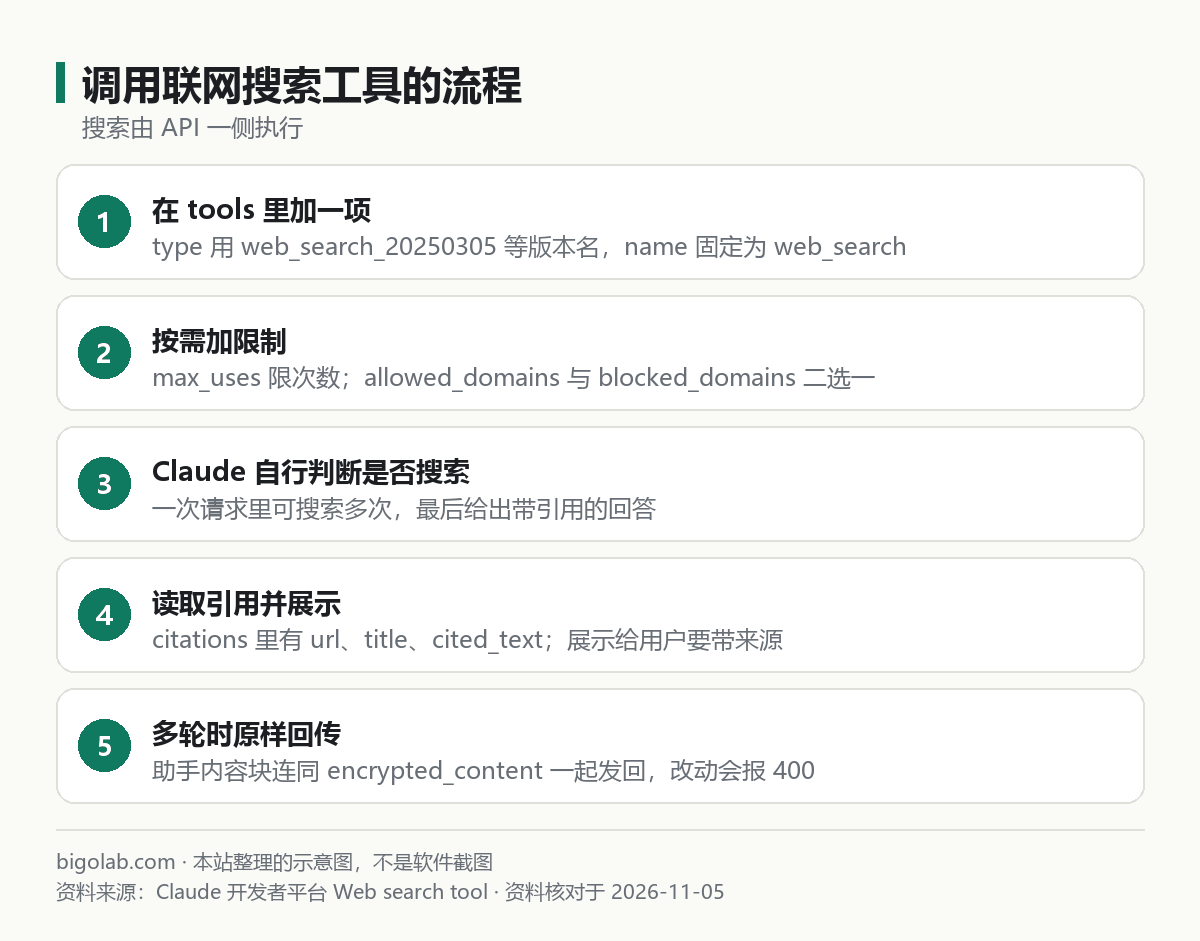
图:本站根据 Claude 官方文档:Web search tool 整理的示意图
一、最小请求
官方 Python 示例的写法(工具名固定为 web_search):
python
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "What's the weather in NYC?"}],
    tools=[{"type": "web_search_20250305", "name": "web_search", "max_uses": 5}],
)
print(response)
官方说明的运行过程:Claude 先根据提示词决定是否搜索;API 执行搜索并把结果交给 Claude,这个过程在一次请求里可以重复多次;最后 Claude 给出带引用的回答。
官方列出会触发搜索的情形:近期事件和新闻、当前价格与比分、可能已变化的机构 / 人物 / 产品信息,以及你明确要求搜索。稳定的知识(数学、编程概念、创意写作、已在对话里的内容)会直接回答。
二、工具参数
官方的完整定义里,除了 type 和 name,可选参数有:
json
{
  "type": "web_search_20250305",
  "name": "web_search",
  "max_uses": 5,
  "allowed_domains": ["example.com", "trusteddomain.org"],
  "blocked_domains": ["untrustedsource.com"],
  "user_location": {
    "type": "approximate",
    "city": "San Francisco",
    "region": "California",
    "country": "US",
    "timezone": "America/Los_Angeles"
  }
}(allowed_domains 与 blocked_domains 同时出现会报错,这里只是把字段列全。)
max_uses: 限制每次请求的搜索次数。超出时,对应的web_search_tool_result是一个带max_uses_exceeded错误码的错误。官方说简单事实查询通常用 1 到 3 次,比较类、多对象研究可能 10 次以上。- 域名过滤: 每项是不带协议的裸域名,可以带路径,例如
example.com或example.com/blog。 user_location: 用于让结果更贴近用户所在地。type必须是approximate;city、region、country、timezone至少给一个;country是两位 ISO 3166-1 国家代码,不支持的代码会被 API 拒绝(400);timezone是 IANA 时区名。allowed_callers: 控制 Claude 是直接调用搜索,还是通过代码执行调用(动态过滤)。web_search_20260209及之后默认是["code_execution_20260120"],要直接调用就设成["direct"];官方说不支持程序化工具调用的模型必须这样设,否则返回 400 并提示你设置。response_inclusion: 仅web_search_20260318及之后。设为"excluded"会把已被代码执行消费完的搜索结果块从响应里去掉,减少输出 token;默认"full"。
动态过滤是什么
官方的说法:基础搜索会把每条搜索结果都放进上下文,其中很多可能不相关。用 web_search_20260209 或更新版本时,Claude 会先写代码过滤结果,只让相关内容进入上下文,从而在搜索密集的请求上少用 token。官方说这需要 Claude 4.6 及更新的模型;API 会自动提供所需的代码执行,你不用另外加代码执行工具,通过这种方式产生的代码执行调用,除标准 token 费用外没有额外收费。
三、返回里有什么
官方示例的响应是一串内容块,按顺序大致是:Claude 的说明文字、server_tool_use(搜索词)、web_search_tool_result(结果列表)、带 citations 的文字回答。
搜索结果每条包含 url、title、page_age 和 encrypted_content。
引用(web_search_result_location)包含 url、title、encrypted_index 和 cited_text(最多 150 个字符)。官方说明:联网搜索的引用总是开启的;cited_text、title、url 三个字段不计入输入或输出 token。
多轮对话的关键: 想继续带搜索结果的对话,必须把助手的内容块原样发回去,包括每条结果的 encrypted_content。缺少或被改动,请求会失败并返回 400 校验错误。
官方还提醒:把 API 输出直接展示给终端用户时,必须包含对原始来源的引用;如果你对输出做了改写或和自己的内容合并后再展示,应按需要展示引用,并向你们的法务咨询。
四、错误和 pause_turn
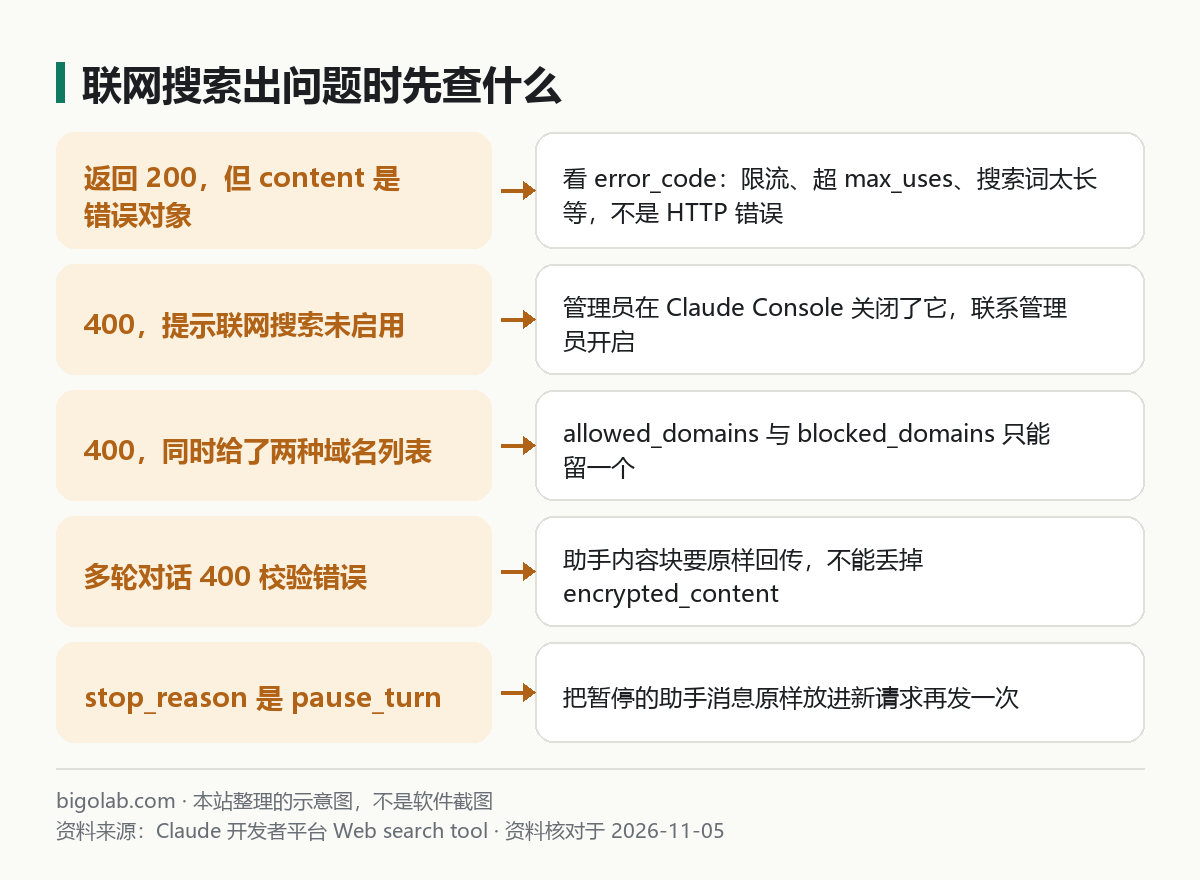
图:本站根据官方文档整理的示意图
搜索失败不一定是 HTTP 错误。 官方说,搜索工具遇到错误(比如触发限流)时,Claude API 仍然返回 200,错误体现在响应体里:content 是一个 web_search_tool_result_error 对象,而不是结果列表。如果搜索成功但没有匹配,是空的 content 列表,不算错误。错误码包括:
too_many_requests:超出速率限制;invalid_tool_input:搜索词参数无效;max_uses_exceeded:超过搜索次数上限;query_too_long:搜索词超长;request_too_large:请求太大,通常是域名过滤列表太长;unavailable:内部错误。
被禁用时: 官方说,联网搜索默认对你的组织开启,除非管理员在 Claude Console 里关闭了(管理员还可以在那里限制可搜索的域名)。关闭后,带这个工具的请求会返回 400 invalid_request_error,提示联网搜索未启用,而不是搜索结果里的错误码。
pause_turn: API 可能暂停一个很长的搜索回合,返回 stop_reason: "pause_turn"。继续的办法是把暂停的助手消息原样放进新请求再发。如果 Claude 在同一组并行调用里同时调用了联网搜索和你自己的客户端工具,API 返回 stop_reason: "tool_use",且还没有执行搜索;你返回客户端工具结果后,API 才在下一次请求里执行搜索。
429 本身的处理见 /guides/claude-api-error-429-rate-limit。
五、计费、缓存和批量
- 计费: 官方页面写:联网搜索在 Claude API 上是每 1000 次搜索 10 美元,另加搜索产生内容的标准 token 费用。一次搜索算一次用量,不论返回多少条结果;出错的搜索不计费。整个对话中取回的搜索结果会计为输入 token。
- Prompt 缓存: 想在多轮之间缓存工具定义,见官方「Tool use with prompt caching」;站内的缓存基础见 /guides/claude-prompt-caching。
- 批量: 联网搜索可以放进 Messages Batches API,价格与普通请求相同。官方提醒:为保护共享容量,批量接口会对每个组织的联网搜索限流,大批量带很多搜索的任务可能更慢。
- 流式: 开启流式后会收到搜索事件,搜索进行时流会有停顿。
常见问题
Q:所有模型都能用吗?
官方页面的「Availability」写的是联网搜索工具在每个模型上可用,并符合零数据保留和 HIPAA 就绪的条件;但动态过滤需要较新的模型。想在发请求前确认,官方建议读 Models API 里 capabilities.server_tools.web_search.supported 的值。
Q:Bedrock、Vertex 上能用吗?
官方页面列出了不同平台的可用性,并注明部分平台只支持基础版(web_search_20250305,不带动态过滤)。具体平台和版本请直接看官方「Availability」一节,本文不转述。
Q:我只想让它读某个具体网址的内容?
官方「Next steps」里列了另一个工具用于抓取指定网址的内容,本文没有覆盖,请看官方文档。
相关教程
- /guides/claude-tool-use-basics:工具调用的基本机制
- /guides/claude-api-python-quickstart:Python 快速上手
- /guides/claude-api-key-console:API Key 与 Console
参考资料
- Claude 开发者平台文档:Web search tool — https://platform.claude.com/docs/en/agents-and-tools/tool-use/web-search-tool
0 条评论
还没有评论,来抢沙发~