
结论先说
- 官方提供开箱即用的
docker compose up全栈编排:克隆官方仓库后一条命令即可拉起 Web 控制台、异步 Worker、PostgreSQL、ClickHouse、Redis 与 MinIO,无需注册任何外部云服务。 - 本机 Docker 至少预留 4GB 以上内存:新版架构依赖 ClickHouse 高速写入海量调用链,内存太小会导致容器反复重启或健康检查超时。
- 上生产前必须改掉默认密钥:测试跑通后若要对团队内网暴露,务必修改环境变量中的
NEXTAUTH_SECRET、SALT、ENCRYPTION_KEY与数据库默认密码。 - 提示词管理靠
production标签加客户端内存缓存实现零延迟热更新:运营或研发在网页后台把新版本切到production标签后,线上代码在缓存过期(默认 60 秒)后自动生效,Langfuse 挂掉时 SDK 也会降级使用内存旧缓存不崩业务。 - AI 编程订阅与团队采购入口:部署与编写后端工程可搭配高频编程助手提效,国内免外币卡开通可见本站 Claude Code 订阅说明、ChatGPT Business 团队定制 与 AI 会员充值中心。
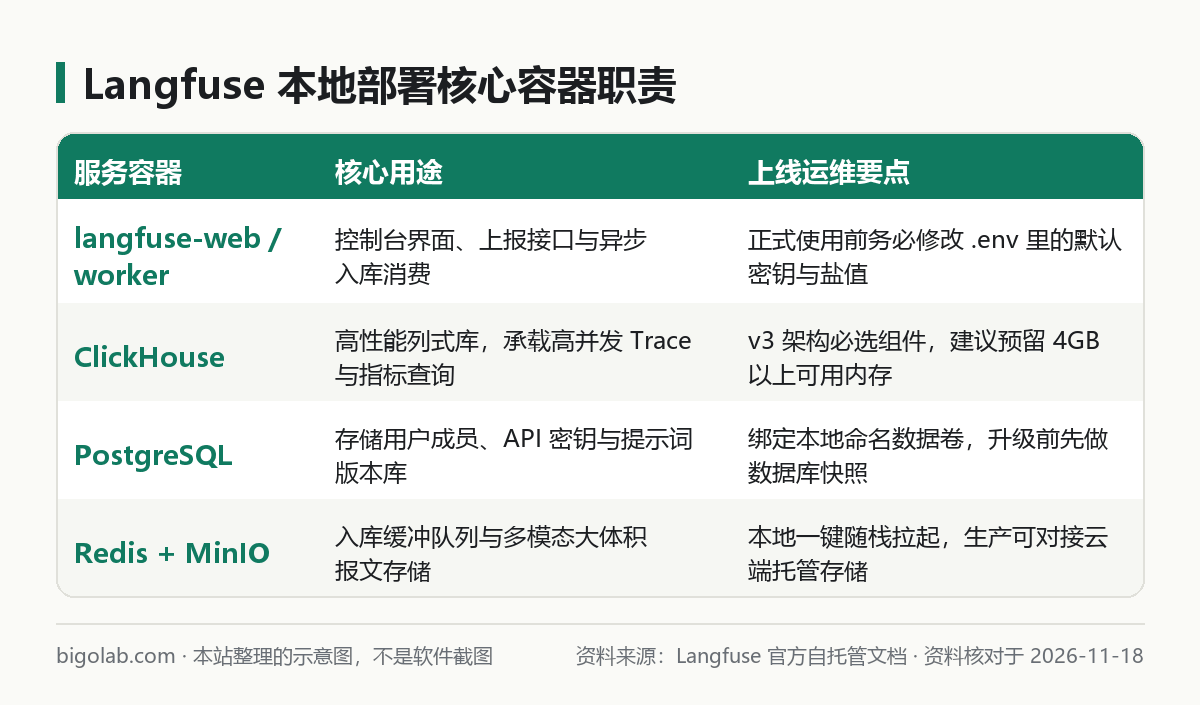
图:本站根据 Langfuse 官方文档:Local Deployment 整理的示意图
本文根据 Langfuse 官方自托管文档《Local Deployment (Docker Compose)》与《Prompt Management》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Langfuse 官方网站。
适用于谁
- 有数据合规要求,希望把所有用户对话 Trace、Token 账单与评测数据完全留在公司自有服务器或本机的开发团队;
- 厌倦了每次只改提示词里一句话都要走 Git 提交、CI 构建和重新发版流程的工程师;
- 准备用 Docker Compose 在本地快速拉起 Langfuse v3 并跑通第一条提示词热加载的人。
一、Docker Compose 本地一键部署步骤与资源要求
在装好 Docker Desktop(macOS / Windows WSL2)或 Linux Docker Engine 的机器上,确保 Docker 可用内存不低于 4GB(推荐 8GB),且本机 3000、5432、8123、9090 等端口未被占用,按顺序执行:
bash
# 1. 克隆官方仓库并进入目录
git clone https://github.com/langfuse/langfuse.git
cd langfuse

# 2. 后台启动完整容器栈(首次拉取镜像并初始化 ClickHouse 约需 2 至 3 分钟)
docker compose up -d

# 3. 观察 langfuse-web 容器日志,看到 Ready 即可访问
docker compose logs -f langfuse-web
看到服务就绪后,打开浏览器访问 http://localhost:3000:
- 点击 Sign up 在本地数据库创建第一个管理员账号(数据仅存本机 PostgreSQL,不联网发送);
- 依次创建 Organization(组织)与 Project(项目);
- 进入项目左侧 Settings > API Keys,点击创建密钥,复制保存
pk-lf-...(公钥)、sk-lf-...(私钥)以及本地地址http://localhost:3000。
内网长期运行必改项:官方示例编排文件里硬编码了演示用密码与 # CHANGEME 标记。正式给团队用之前,请用 openssl rand -hex 32 重新生成 NEXTAUTH_SECRET、SALT 与 ENCRYPTION_KEY,并将 NEXTAUTH_URL 改为内网真实访问域名或 IP 端口。
二、提示词版本管理(Prompt Management)实战
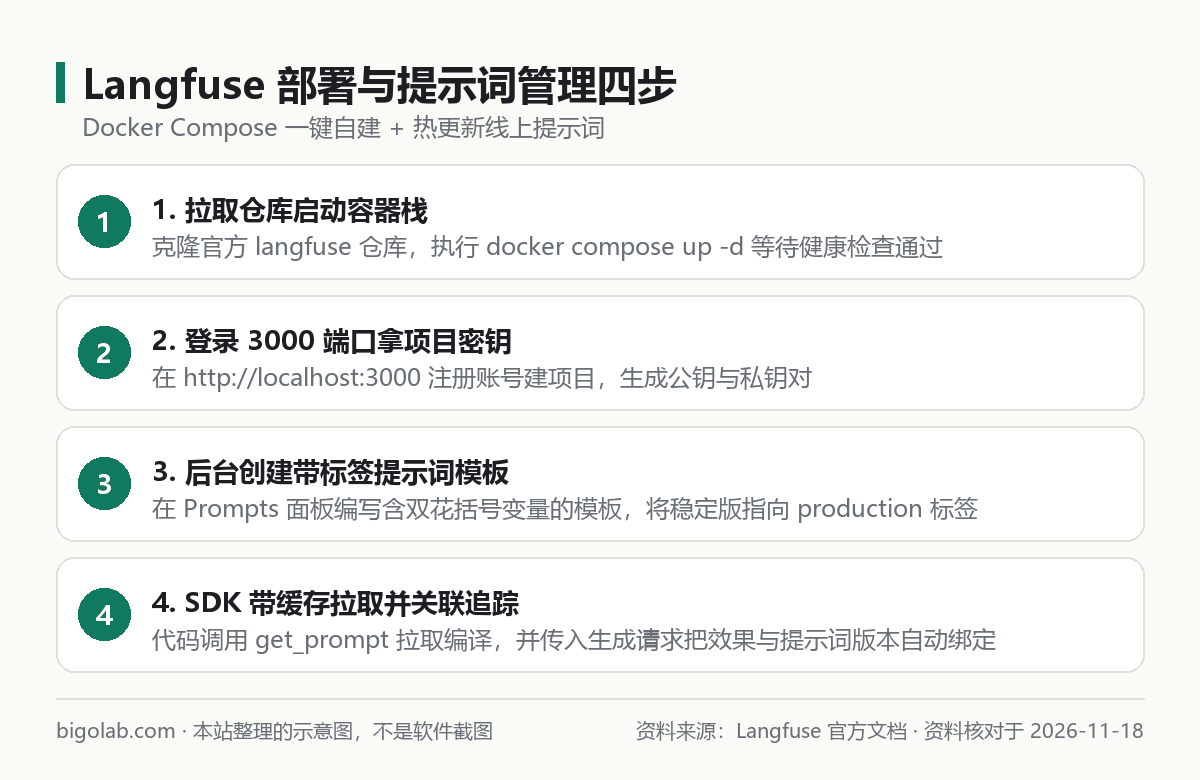
图:本站根据 Langfuse 官方文档:Prompt Management 整理的示意图
把提示词硬编码在 Python 代码里有两大痛点:产品经理没法帮忙调优措辞,而且线上追查 Bug 时不知道昨天下午那条错答究竟用的是哪一版提示词。Langfuse 的提示词中心通过「不可变版本号 + 环境标签(Labels)」解决这一问题:
- 在控制台新建模板:点击左侧菜单 Prompts > New prompt,名称填
order-refund-assistant,类型选Chat(对话消息列表)或Text(纯文本)。 - 使用双花括号定义动态变量:在内容框写入如下结构,勾选底部的 Set the "production" label 保存为
Version 1:
text
你是企业售后客服助手。请严格依据以下制度回答,不要编造条款:
【制度片段】:{{policy_context}}
【用户提问】:{{question}}- Python 代码拉取编译并与调用链双向绑定:安装
pip install langfuse openai(首次调模型接口可参考 大模型 API 首次调用通用入门),写入以下代码:
python
import os
from langfuse import Langfuse
from langfuse.openai import OpenAI

os.environ["LANGFUSE_PUBLIC_KEY"] = "pk-lf-你的公钥"
os.environ["LANGFUSE_SECRET_KEY"] = "sk-lf-你的私钥"
os.environ["LANGFUSE_HOST"] = "http://localhost:3000"

langfuse = Langfuse()
client = OpenAI()  # 使用 Langfuse 包装版客户端

# 默认拉取 label="production" 的版本,客户端自动内存缓存 60 秒(0 网络阻塞)
prompt = langfuse.get_prompt("order-refund-assistant", label="production", cache_ttl_seconds=60)
compiled_text = prompt.compile(
    policy_context="数码产品拆封激活后无质量问题不支持七天无理由退货。",
    question="刚激活的平板不喜欢能退吗?",
)

# 将 langfuse_prompt 传入请求,后台会自动按提示词版本号汇总成功率与成本
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": compiled_text}],
    langfuse_prompt=prompt,
)
print(resp.choices[0].message.content)
langfuse.flush()
代码上线后,如果发现某类边界问题回答生硬,直接在 localhost:3000 网页端编辑保存为 Version 2,先打上 staging 标签在测试环境验证,确认无误后把 production 标签挪到 Version 2,线上服务无需重启就会在 1 分钟内平滑切换过去。
订阅与账号准备提示:在本地调试 Docker 编排报错或编写后端服务时,配合终端智能体可大幅减少查日志时间(入门见 Claude Code 中文入门教程);国内开发者可在本站免外币卡自助开通 Claude Pro 或大额度的 Claude Max。
三、成本核算与缓存架构联动建议
Langfuse 内置了主流模型的公开价格表,也可以在控制台 Models 页添加企业私有化部署模型的自定义单价(官方公开价格速查见 AI 大模型 API 价格对比)。当你在管理十几万字长系统提示词模板时,记得把固定规则放在 system 顶部、动态 {{question}} 放在末尾,避免破坏模型厂商的前缀提示词缓存(原理见 RAG 与长上下文加提示词缓存选型框架)。
常见问题
问:执行 docker compose up -d 后 langfuse-web 反复报错退出怎么办?
答:九成是 clickhouse 或 postgres 容器还没初始化完毕,或者宿主机内存不足导致 ClickHouse 被系统 OOM 杀掉。运行 docker compose ps 检查各依赖容器是否为 healthy,清理无用镜像释放内存后再执行 docker compose up -d。
问:万一自建的 Langfuse 容器重启维护,会导致线上业务调 get_prompt 全部报错瘫痪吗?
答:只要该进程启动后成功拉取过一次提示词,SDK 就算遇到后台网络超时也会自动回退使用内存里的旧缓存副本继续服务;冷启动防灾还可在 get_prompt(..., fallback="兜底提示词") 参数里传入本地硬编码兜底文本。
问:后续怎么安全升级本地 Docker 版本的 Langfuse?
答:先对 PostgreSQL 数据卷做一次 pg_dump 备份,再拉取最新仓库配置或修改镜像版本号执行 docker compose pull && docker compose up -d,容器启动时会自动按序执行数据库与 ClickHouse 表结构迁移脚本。
问:国内个人或研发团队没有外币信用卡,怎么订阅 AI 编程会员或开具报销发票?
答:可前往本站 AI 会员充值中心 自助兑换 Claude Pro 卡密、ChatGPT Plus 或咨询团队定制(自助卡密无需提供账号密码),支持支付宝、微信支付与 AlipayHK 付款并支持开具增值税发票;实时价格与售后边界(掉订阅按剩余天数折退,封号不在质保范围)以页面展示为准。
相关教程
- 大模型 API 怎么用:从申请 Key 到第一次调用,OpenAI、Claude、Gemini 通用入门
- AI 大模型 API 价格对比:OpenAI、Anthropic、Google、xAI、DeepSeek 官方价格页速查
- RAG 检索增强生成和直接塞长上下文怎么选:成本、延迟、更新频率与官方选型判断框架
- Claude Code 中文入门教程(2026):安装、登录、第一个任务、常用命令
参考资料
- Langfuse 官方自托管文档:Local Deployment (Docker Compose) — https://langfuse.com/self-hosting/local
- Langfuse 官方文档:Prompt Management Get Started — https://langfuse.com/docs/prompts/get-started
- Langfuse 官方 GitHub 仓库 — https://github.com/langfuse/langfuse
0 条评论
还没有评论,来抢沙发~