
结论先说
- 核心原理是在建索引前「先补背景再入库」:传统切块直接把孤立段落转成向量,丢掉了全文语境;Contextual Retrieval 让模型结合整篇文档,为每个小块生成一段 50 至 100 字的专属背景说明拼在块首。
- 双路同步增强效果翻倍:拼好背景的新文本不仅用来算稠密向量(Contextual Embeddings),还同步写入关键词倒排库(Contextual BM25),Anthropic 官方公开评测显示 Top-20 检索失误率降低 49%;再叠加上 Reranking 重排序后失误率降低 67%。
- 靠 Prompt Caching 把离线建库成本压低一个数量级:处理同一篇长文档的几十个切片时,把整篇原文固定在提示词前缀并打上
cache_control,除第 1 块外其余所有块都按低至一折的缓存读取价计费。 - 资料小于 20 万 token 时不必折腾这套流水线:Anthropic 明确指出,若整个知识库不到 20 万 token(约 500 页文本),直接把全量文档塞入提示词并开启缓存比任何 RAG 都省事(对比见 RAG 与长上下文加缓存选型框架)。
- Claude 会员与开发工具订阅入口:日常使用 Claude 网页端项目知识库或 Claude Code 写检索工程,国内免外币卡开通可见本站 Claude Pro 充值页、Claude Max 充值页 与 AI 会员充值中心。
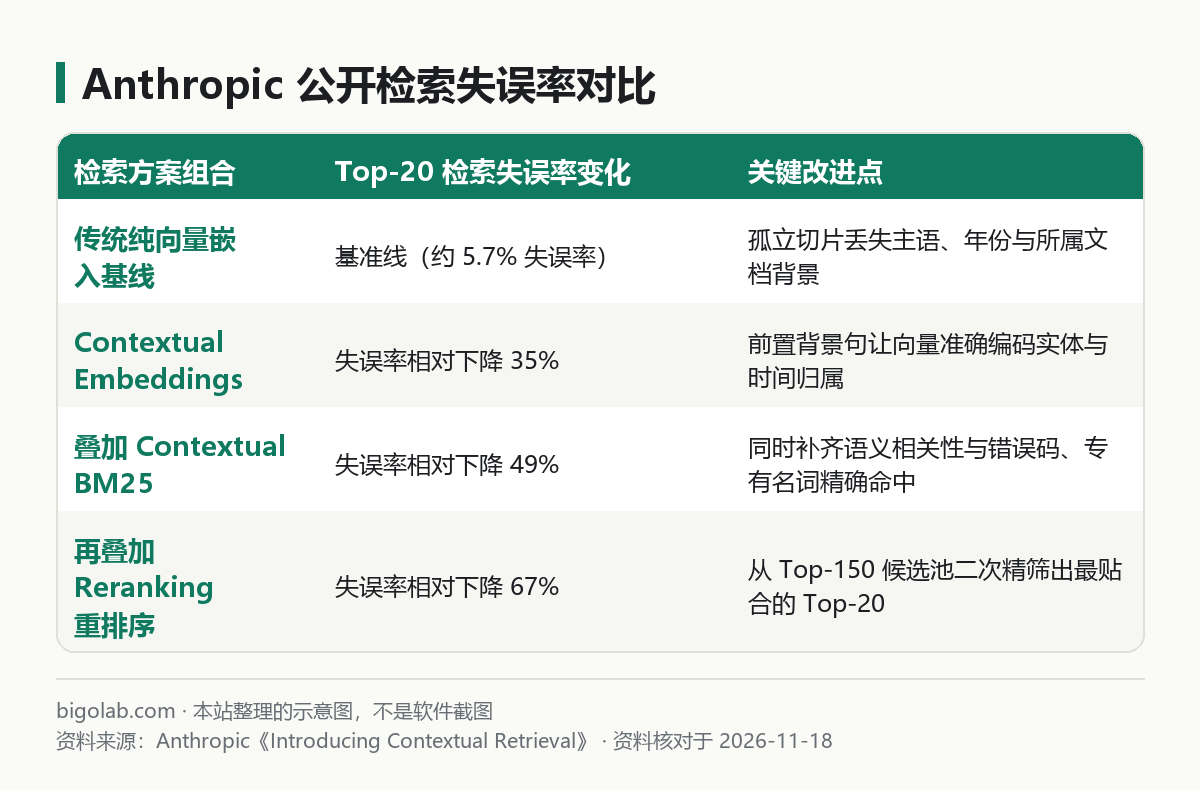
图:本站根据 Anthropic:Introducing Contextual Retrieval 整理的示意图
本文根据 Anthropic 官方技术博客《Introducing Contextual Retrieval》与 Claude API 官方文档《Prompt caching》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 检索多份历年财报、多产品型号手册或多主体合同时,经常把 A 公司数据错当成 B 公司召回来的开发者;
- 听说 Anthropic 提出的 Contextual Retrieval 能显著降低漏检率,想看清它跟普通标题拼接有什么本质区别的工程师;
- 担心给几万个文档块逐条调用大模型补背景会把 API 账单烧穿,想掌握官方缓存省钱写法的团队。
一、它到底解决了传统 RAG 的什么死穴
假设你的知识库里存了十几家上市公司近五年的季报,其中一个切片原文只有一句话:「该公司本季度营收环比增长 3%,主要受云业务带动」。当用户提问「ACME 公司 2023 年二季度营收涨了多少?」时,传统向量库和 BM25 都会抓瞎——因为这个小块里既没有 ACME 这个词,也没有 2023 年二季度。
经 Contextual Retrieval 预处理后,入库文本会变成:
text
这段文字摘自 ACME 公司 2023 年第二季度 SEC 财报文件,前文汇报了 2023 年一季度营收为 3.14 亿美元。该公司本季度营收环比增长 3%,主要受云业务带动。
补上这一句简短定位后,无论是稠密向量(调用细节可参考 OpenAI Embeddings 向量教程)还是 BM25 词面匹配,都能一次性精准锁定公司名称与季度归属。
二、官方标准提示词与 Prompt Caching 省钱实现代码
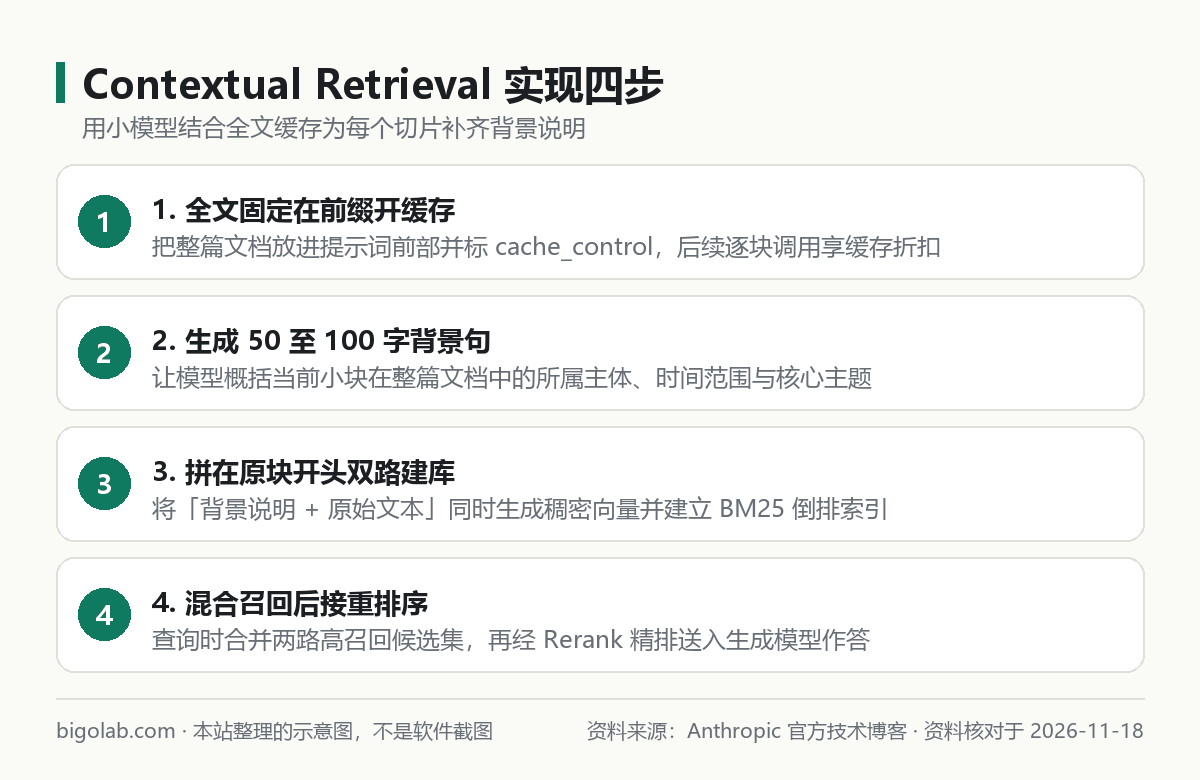
图:本站根据 Anthropic:Prompt caching 整理的示意图
如果每处理一个切片都把几万字的整篇文档重新计费一遍,账单会非常昂贵。官方做法是利用 Claude 的 提示词缓存(计费倍率与最短缓存门槛详见 Claude 提示词缓存入门教程):按「一篇文档接一篇文档」顺序串行或小并发跑批,把 <document> 全文锁在前缀加上 "cache_control": {"type": "ephemeral"},5 分钟有效期内同篇文档的第 2 至第 N 个切片全部享受缓存命中折扣:
python
import anthropic

client = anthropic.Anthropic()

def situate_chunk(whole_doc: str, chunk_text: str) -> str:
    """结合整篇文档缓存,为单个切片生成简短上下文定位说明"""
    resp = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=200,
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "type": "text",
                        "text": f"<document>\n{whole_doc}\n</document>",
                        "cache_control": {"type": "ephemeral"},  # 固定全文前缀打缓存断点
                    },
                    {
                        "type": "text",
                        "text": (
                            f"以下是我们需要定位在整篇文档中的片段:\n<chunk>\n{chunk_text}\n</chunk>\n"
                            "请给出一段简短精炼的背景说明(50-100字),交代该片段在整篇文档中的语境以改进检索效果。"
                            "请只返回这段简短背景说明本身,不要输出任何额外解释。"
                        ),
                    },
                ],
            }
        ],
    )
    context_prefix = resp.content[0].text.strip()
    return f"{context_prefix}\n\n{chunk_text}"
拿到返回的拼接字符串后,把它同时送进向量数据库生成 Embedding,并送进本地或搜索引擎的 BM25 分词索引。实操时请打印 resp.usage.cache_read_input_tokens,确认从第 2 个切片开始该字段大于 0,说明缓存真正生效了(各模型单价速查见 AI 大模型 API 官方价格对比)。
订阅与账号准备提示:搭好检索底座后日常改写业务代码可配合 Claude Code 提效,支持在本站开通 Claude Code 订阅;若注册官方 API 或网页账号时弹出身份核验卡住,也可查看本站 Claude KYC 人工协助(失败不收费)。
三、落地上线的三项工程优化细节
- 按业务领域微调背景提示词:金融财报、法律合同与代码仓库需要补齐的要素不同。例如对代码仓库做切块时,可把上述指令微调为「交代该函数所在文件路径、所属类职责及上下游调用关系」,命中率比通用模板更高。
- 控制单篇文档不超模型单次窗口:如果遇到单本长达上百万 token 的超巨型 PDF,先按大章拆成几万 token 一份的独立父章节作为
<document>,同样能保留完整语境且不爆窗口。 - 离线批量任务可叠加 Message Batches 批处理:不着急几分钟内建完索引的历史存量文档,可优先测试批量接口或控制同文档块在 5 分钟缓存 TTL 内紧凑跑完,防止请求间隔过长导致缓存过期重算。
常见问题
问:只往块首拼「文件名 + Markdown 标题路径」能不能代替 Contextual Retrieval?
答:拼标题是零成本的基础操作,建议必做;但如果章节标题只叫「第三节:经营表现」,标题里依然不含前文提到的年份、币种单位或对比基准,大模型读完全文生成的动态背景句能补上静态标题树没有的跨段隐含主语。
问:检索召回后喂给生成模型时,是喂「原始切片」还是「带背景说明的拼接切片」?
答:Anthropic 官方方案直接把「背景说明 + 原始切片」一并送给后续 Rerank 重排模型和最终生成大模型。因为前置的那句背景同样能帮重排器和生成模型看懂代词指代,防止张冠李戴。
问:文档局部修订了一段话,需要整篇重新跑一遍所有切片的背景生成吗?
答:如果只是改正错别字或局部数字,只重跑被修改的那一两个切片即可;但如果修改了文档开头的适用对象、生效年份等全局前提,则应整篇重刷以保证各子块背景一致。
问:人在国内没有境外信用卡,怎么订阅 Claude 会员或为团队采购报销开票?
答:可前往本站 AI 会员充值中心 自助选购 Claude Pro 免上号卡密 或 Claude Max 充值服务(无需交出密码,24 小时自助兑换),支持支付宝、微信支付与 AlipayHK 并可开具增值税发票;实时价格与售后边界(掉订阅按剩余天数折退,封号不在质保范围)以页面展示为准。
相关教程
- Claude 提示词缓存(Prompt Caching)入门:缓存时间、价格倍率与命中率
- RAG 检索增强生成和直接塞长上下文怎么选:成本、延迟、更新频率与官方选型判断框架
- OpenAI Embeddings 向量怎么用:text-embedding-3-small 调用、dimensions 缩短与搜索
- AI 大模型 API 价格对比:OpenAI、Anthropic、Google、xAI、DeepSeek 官方价格页速查
参考资料
- Anthropic 官方技术博客:Introducing Contextual Retrieval — https://www.anthropic.com/news/contextual-retrieval
- Claude API 官方文档:Prompt caching — https://platform.claude.com/docs/en/build-with-claude/prompt-caching
0 条评论
还没有评论,来抢沙发~