
结论先说
- 几十份以内的核心制度库,直接走「
Files API+Citations+ 提示词缓存」比自建粗糙切片 RAG 准得多:用client.files.upload传一次原版 PDF 拿到file_id,免去每次请求重复上传几兆字节文件,还能完整保留跨页上下文。 - 在
document块加上"citations": {"enabled": True},模型就不再靠记忆乱编页码:服务端会在返回块里结构化附带精确的 PDF 起止页码(page_location)和逐字原文摘录(cited_text),且官方规定引用的原文摘录部分不额外收输出 Token 费。 - 死守一条多租户安全红线:绝对不要信任前端传上来的
file_id:因为 Files API 上传的文件对当前 API Key 所属的整个工作区可见,file_id必须由你自己的业务后端按登录员工权限从数据库查出来拼接。 - 不想自己写代码搭前端页面、只想在现成界面建小团队制度知识库时:可以直接用网页版 Projects 功能,开通订阅可查看本站 Claude Pro 充值说明 或多人重度档 Claude Max 充值页。
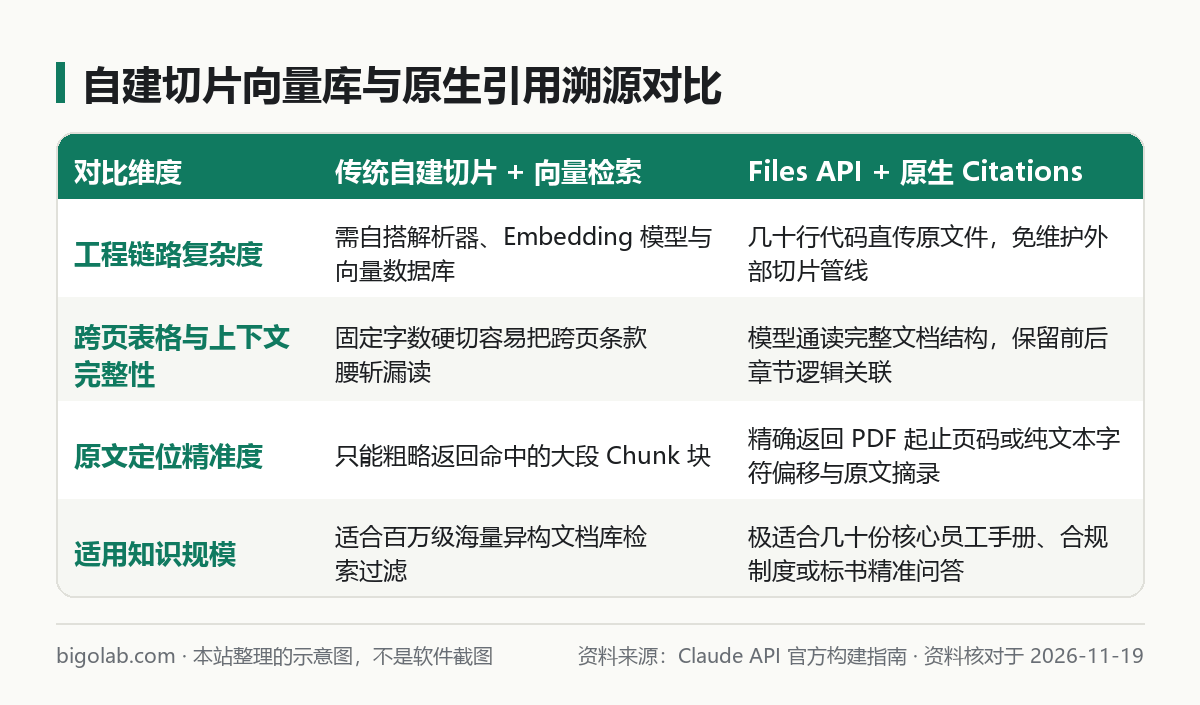
图:本站根据 Claude API 官方构建文档 整理的两种制度问答路线对比图
本文根据 Anthropic 官方开发者文档《Citations》《Files API》(platform.claude.com/docs)整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 想给公司内部搭一个「员工手册、财务报销制度、标书规范」精准问答助手,要求每一句回答后面都能点开对应 PDF 第几页哪句话的开发者;
- 手头核心制度文件一共就十几份 PDF,觉得为了这点体量去搭一套切片器 + Embedding + 向量数据库太重、而且硬切片总是把跨页表格砍断的工程师;
- 已经分别看过本站 Files API(1849 号文)和 Citations(1850 号文)单项介绍,想要一份把上传缓存、防越权与前端角标解析串成闭环的生产级代码的人。
一、从一次上传到带页码溯源输出的 Python 闭环代码
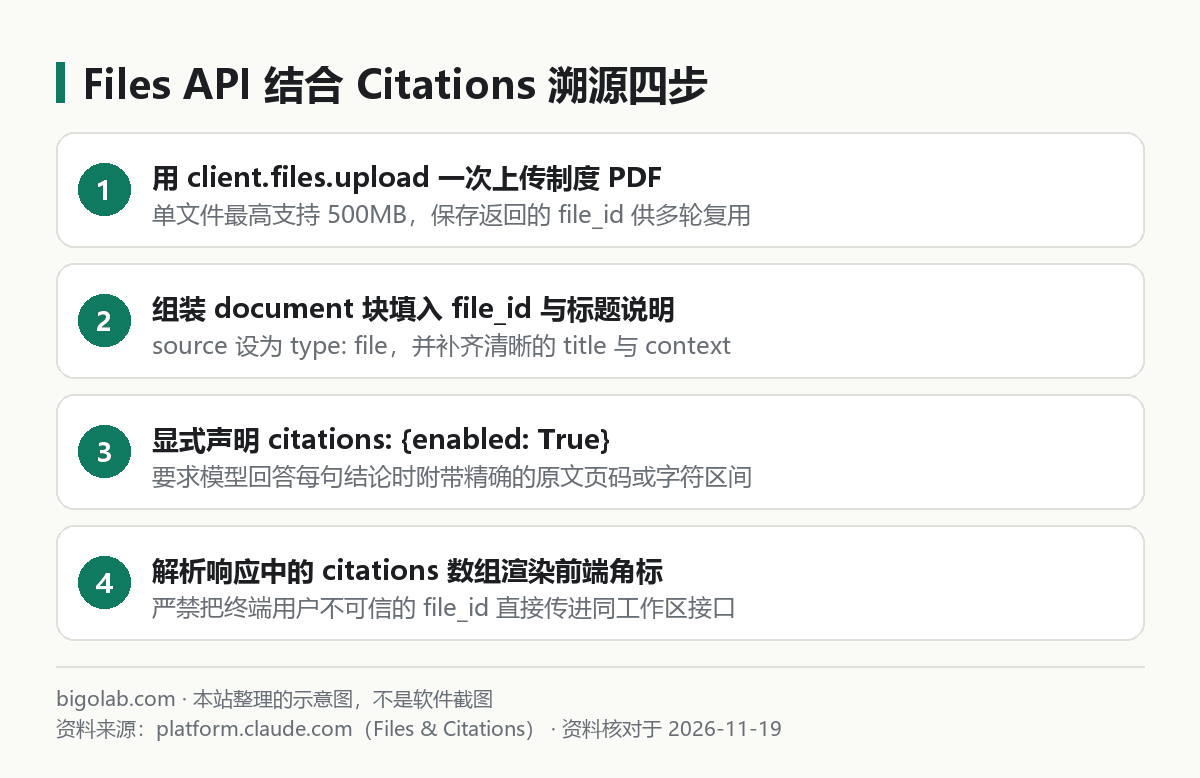
图:本站根据 Files API 与 Citations 文档 整理的四步落地流程示意图
注意:document 内容块开启原生引用支持 PDF 与纯文本(如果手头是 .docx 或 .xlsx,请先在后端转成 PDF 或纯文本再传;文件生命周期与 500MB 限制细则见 Claude Files API 详解,引用块全字段格式见 Claude Citations 接口详解)。
下面演示「管理员后台上传一次入库 → 员工提问时挂载 file_id、开启引用并顺手加缓存断点 → 解析页码角标」的完整代码:
python
import anthropic

client = anthropic.Anthropic()

# 第一阶段(仅在制度更新时跑一次):上传 PDF 并把返回的 file_id 存入你自己的业务数据库
uploaded = client.files.upload(
    file=("reimbursement_policy_2026.pdf", open("reimbursement_policy_2026.pdf", "rb"), "application/pdf")
)
policy_file_id = uploaded.id  # 例如 file_011CNha8...

# 第二阶段(员工每次提问时调用):引用服务端查出的安全 file_id,同时开启 Citations 与缓存
resp = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system="你是企业财务合规助手。请严格依据提供的制度文档回答,文档未规定的事项明确答复未找到依据。",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "document",
                    "source": {"type": "file", "file_id": policy_file_id},
                    "title": "2026版差旅与日常报销管理制度",
                    "context": "适用于全体正式员工的国内出差住宿标准与发票时效规定",
                    "citations": {"enabled": True},
                    "cache_control": {"type": "ephemeral"},
                },
                {
                    "type": "text",
                    "text": "一线城市出差住宿晚均上限是多少?跨月发票最晚几号前提交?",
                },
            ],
        }
    ],
)

# 第三阶段:提取正文与精确页码角标返回给前端渲染
for block in resp.content:
    if block.type == "text":
        print("回答片段:", block.text)
        for cite in (block.citations or []):
print(f" -> 出处:《{cite.document_title}》第 {cite.start_page_number}-{cite.end_page_number} 页 | 原文:{cite.cited_text!r}")长文档精读与高频生产力订阅入口:无论是往 Projects 挂载几十份背景资料、审阅几十页英文商业合同,还是连续绘制复杂架构图,免费版短窗口配额极易受限。国内用户可通过本站支付宝、微信支付或 AlipayHK 免上号自助开通 Claude Pro 会员(直达单品 Pro iOS 自助充值)或大额度 Claude Max 充值。
二、上生产前必踩稳的三个工程细节
- 在
document块顺手挂上cache_control:Files API 免掉的是「网络重复上传大文件字节流」的耗时,但每次推理时文档里的文字与页面视觉依然按输入 Token 计费。像上面代码那样在document块末尾加一行"cache_control": {"type": "ephemeral"},全公司员工高频追问同一本手册时,第二次起就能直接吃进九折以上的缓存读取优惠(缓存叠加原理见上一篇 提示词缓存与批处理降本指南)。 - 填好
title和context字段:当你在一次请求里同时挂了《考勤制度》《报销制度》《信息安全红线》三个document块时,清晰的title会原样出现在返回结果的cite.document_title里,前端不用再自己建映射表就能直接拼出漂亮的角标卡片。 - 多部门权限隔离别偷懒:如果财务部专属薪酬制度和全员公开考勤制度混传在同一个 Anthropic Workspace 下,你的后端路由必须先验当前提问人的部门角色,只把该角色有权看的
file_id数组塞进messages;若做对外 SaaS 多租户隔离,官方建议按租户拆分独立工作区。
常见问题
问:什么时候这套方案扛不住,还是得老老实实上向量数据库(RAG)?
答:当你的文档库膨胀到几百上千份、总容量远超单次上下文窗口(哪怕开了长窗口也没法每次把五百本 PDF 全挂进同一个请求)时,就需要先用向量或混合检索筛出最相关的前 3 至 5 份文档,再把筛出来的这几份 file_id 塞进上面的 document 块做精读溯源——「粗排检索 + 原生 Citations 精读」效果最佳。
问:上传进 Files API 的制度 PDF,如果原文件改了一个数字怎么热更新?
答:官方规定已上传的文件不支持原地覆盖修改。制度修订后,请重新调一次 client.files.upload 拿到新的 file_id 更新你业务数据库里的指针,并顺手调 client.files.delete 把旧文件删掉(PDF 视觉图表解析细节另见 Claude API PDF 支持说明)。
问:开启 citations 后为什么偶尔某句过渡话后面 block.citations 是空的?
答:像「根据您提供的制度规定,分以下两点说明:」这类纯礼貌衔接引导句本身不承载具体条款事实,因此不挂引用对象是完全正常的;真正包含金额、天数、审批人的实质断言块都会附带对应的引用列表。
问:新注册 Claude 收不到手机验证码,或者没有外币卡怎么开通 Pro / Max 会员?
答:注册受阻可先看本站 Claude 注册与普号说明页;已有账号升级会员可直接前往 Claude Pro 充值页 或 Claude Max 充值页 获取自助卡密兑换,支持开具增值税发票,实时价格与售后边界(封号不在质保范围)见各商品页。
0 条评论
还没有评论,来抢沙发~