
结论先说
- Obsidian 接入 AI 问答主要靠两款开源社区插件:偏重侧边栏对话与
@笔记精准引用的选 Copilot for Obsidian,偏重双链语义自动推荐与全库块级检索的选 Smart Connections。 - 问答配置必须拆开看「对话模型」和「向量(Embedding)模型」两项:即便对话选 Claude 或 GPT,也应注意 Claude 官方不直接提供通用文本 Embedding 接口,向量索引通常搭配 OpenAI Embedding 或本地 Ollama 嵌入模型完成。
- 连接本地 Ollama 必配跨域白名单环境变量:Obsidian 桌面端请求发自
app://obsidian.md,未设置OLLAMA_ORIGINS时会被 Ollama 默认拦截并报连接失败。 - 隐私敏感仓库务必先设排除目录再建索引:在插件的排除文件夹(Excluded folders)填入日记、财务账单、客户资料和密钥笔记路径,防止全库扫描时误传云端。
- 长文深度整理与日常主力会员入口:若插件 API 按量计费难以预估,日常写长篇综述也可将脱敏笔记直接粘入网页端或桌面端对话,无外币卡可在本站开通 Claude Pro 或 ChatGPT Plus。
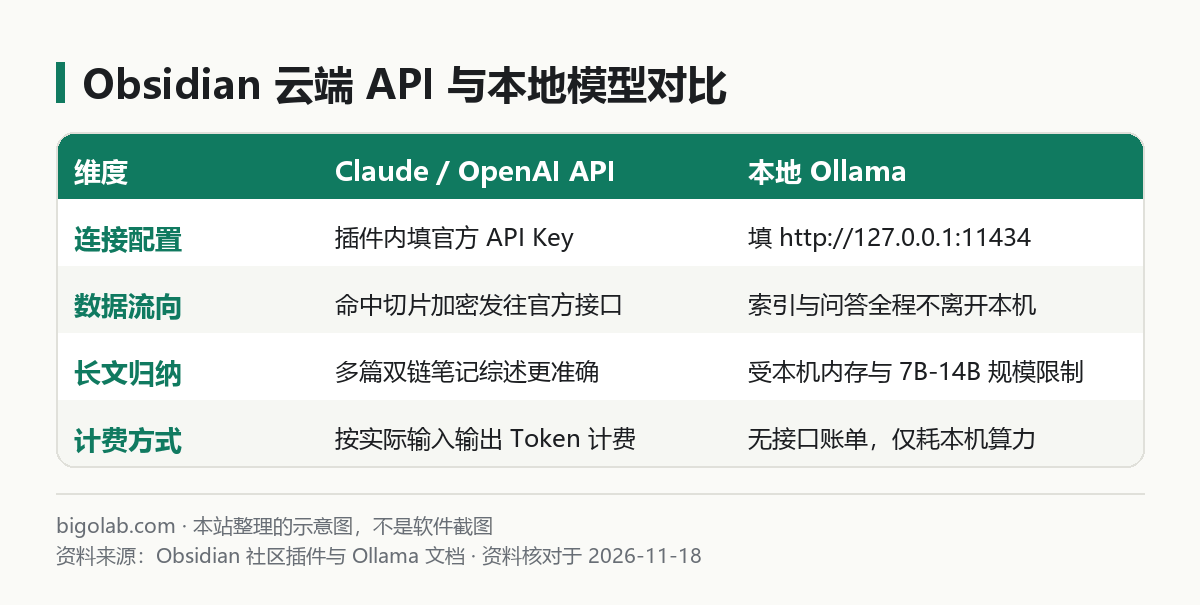
图:本站根据 Obsidian 官方帮助:Community plugins 与 Ollama 官方文档 整理的示意图
本文根据 Obsidian 官方帮助中心《Community plugins》、Copilot 与 Smart Connections 开源仓库说明及 Ollama 官方文档整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Obsidian、Anthropic 或 OpenAI 官方网站。
适用于谁
- 在 Obsidian 积累了上百篇双链 Markdown 笔记,想按语义检索旧想法、跨多篇读书笔记做汇总提问的人;
- 纠结用 Claude / OpenAI 云端 API 还是本地 Ollama 模型,不清楚哪些内容会被发往外部服务器的人;
- 配置本地 Ollama 时遇到连不上
11434端口、跨域报错(CORS)或全库向量索引卡死的用户。
一、主流插件选型:Copilot 与 Smart Connections 怎么选
首次安装前,需在 Obsidian 左下角打开「设置(Settings)> 第三方插件(Community plugins)」,点击「关闭安全模式(Turn on community plugins)」,再进入「浏览(Browse)」搜索安装:
| 维度 | Copilot for Obsidian | Smart Connections |
|---|---|---|
| 核心定位 | 侧边栏聊天助手、选中文本改写续写、Vault QA 全库问答 | 自动发现语义相近笔记段落、构建本地向量连接图谱与对话 |
| 上下文指定方式 | 支持输入 @笔记标题、#标签 或当前活动标签页精准喂给模型 | 自动检索全库相似度最高的 Markdown 标题块拼入提示词 |
| 模型支持范围 | 原生支持 Anthropic Claude、OpenAI、Gemini 与本地 Ollama | 支持本地内置轻量嵌入模型、Ollama 及主流云端官方 API |
建议只保留其中一款开启全库向量索引,同时启用两款向量插件会导致每次保存 Markdown 文件时双倍计算嵌入向量,拖慢笔记软件响应。
二、接入 Claude、ChatGPT 官方 API 与本地 Ollama 步骤
1. 配置云端官方 API Key
先在各厂商开发者后台申请密钥(步骤见 Claude API Key 怎么获取 与 OpenAI API Key 怎么获取),随后在插件设置面板操作:
- 进入「设置(Settings)> Copilot(或 Smart Connections)> Model / API 设置」;
- 在对应厂商栏填入
Anthropic API Key或OpenAI API Key; - 关键细节:若聊天模型选了 Claude(如 Sonnet 系列),切到「Embedding Model(嵌入模型)」选项卡时不要留空,需指定 OpenAI 的
text-embedding-3-small或本地 Ollama 嵌入模型,否则全库Vault QA无法建立本地向量库。
2. 配置本地 Ollama 实现零外发离线问答
若笔记内容涉密不允许离开本机,先按 Ollama 怎么用:安装、下载模型与常用命令 拉取对话模型与中文向量模型:
bash
ollama pull qwen2.5:7b
ollama pull bge-m3
接着配置跨域放行(否则 Obsidian 内部 WebView 请求 http://127.0.0.1:11434 会返回 403 或连接错误):
- macOS / Linux:终端执行
launchctl setenv OLLAMA_ORIGINS "app://obsidian.md*"(Linux 写入 systemd 服务环境变量)并重启 Ollama; - Windows:在系统环境变量新建用户变量
OLLAMA_ORIGINS,值填app://obsidian.md(或测试期填),彻底退出右下角托盘羊驼图标后重开。
最后在 Obsidian 插件中将服务地址设为 http://127.0.0.1:11434(兼容模式填 /v1,详见 Ollama API 本地接口与 OpenAI 兼容写法),对话模型填 qwen2.5:7b,嵌入模型填 bge-m3。
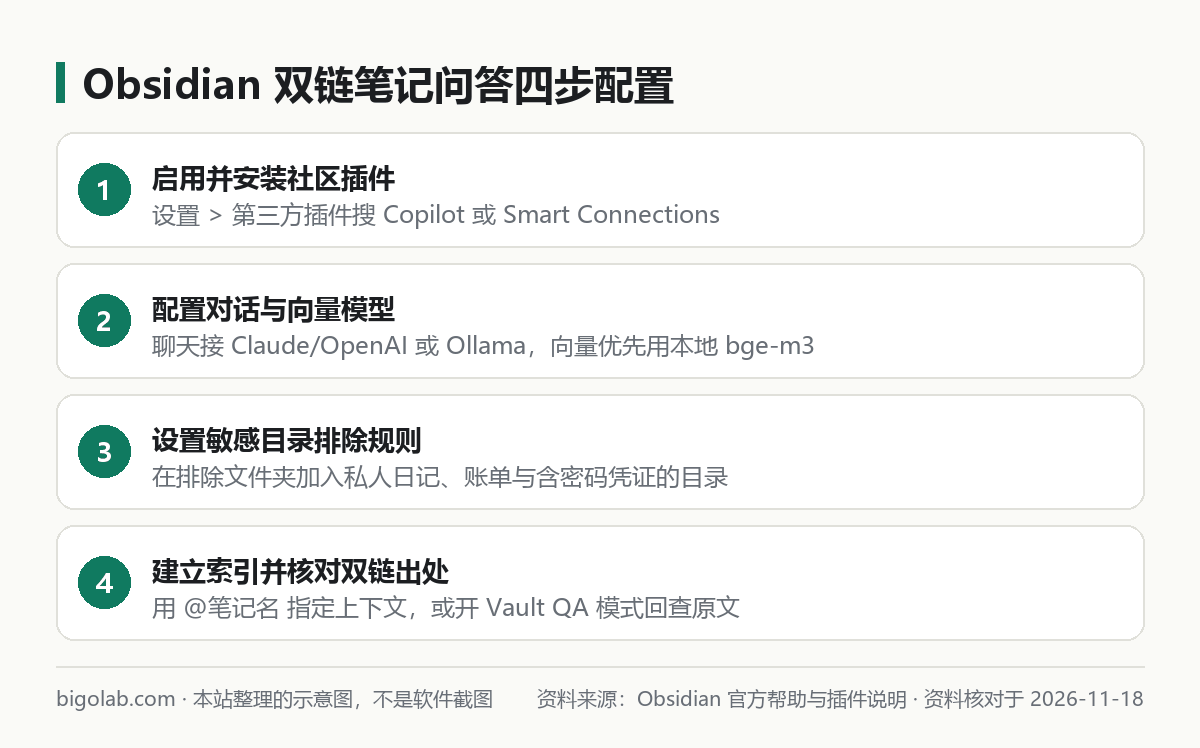
图:本站根据 Obsidian 官方帮助:Community plugins 整理的示意图
深度阅读与编程联动订阅提示:插件内调 API 按每次塞入的笔记切片字数计费,频繁全库问答账单容易超支。若你想把几十篇公开读书笔记导出给高阶模型做深度综述,或直接用终端工具操作本地 Markdown 仓库,可在本站自助开通固定月费的 Claude Pro、Claude Code 或 ChatGPT Plus。
三、隐私脱敏边界:哪些数据会上传、怎么隔离敏感目录
很多用户误以为「笔记文件存在本机硬盘,装个插件提问就不会泄密」,实际数据流向取决于你配置的组合,通用安全核查可对照 AI 使用隐私与数据安全清单:
- 纯本地组合(Ollama 对话 + Ollama / 本地内置 Embedding):建索引与生成回答全程在本机内存完成,断网也能运行,没有任何字符发往外部。
- 混合组合(本地 Embedding + 云端 Claude / OpenAI 对话):平时写笔记建索引不联网;但当你发起
Vault QA提问时,插件会把检索命中的那几段笔记原文连同你的问题一起通过 HTTPS 发给官方 API 服务器。 - 必做的三条脱敏防线:
- 在插件设置找到
Excluded folders / Exclusions,把日记/、财务/、密码与凭证/等私有目录加进去,建索引前先设好; - 不要用云端 API 全库问答模式直接扫未过滤的整个仓库,改用单次对话手动
@公开笔记名定向投喂; - 团队或企业内部文档确认所绑定的官方 API 账号不属于免费公开训练层级(官方商业 API 默认不将接口输入用于训练基座模型,具体以各家 API 数据隐私条款为准)。
常见问题
问:我已经开通了网页版 ChatGPT Plus 或 Claude Pro 会员,能免 API Key 直接填进 Obsidian 插件吗?
答:不能。网页版个人订阅额度和开发者平台的 API 余额是两套完全独立的计费体系,Obsidian 社区插件走的是官方 HTTP API 接口,必须填入开发者后台生成的 API Key 按实际 Token 结算,切勿在第三方未知插件中填入网页账号 Cookie 以防触发风控封号。
问:几千篇双链笔记第一次建向量索引非常慢、风扇狂转怎么办?
答:首次全库向量化需要对每篇文档分块推理,建议先通过排除规则过滤掉附件目录、Excalidraw 画板源码文件(.excalidraw.md 体积巨大且无问答价值)和历史归档目录,并使用轻量级向量模型如 nomic-embed-text 或 bge-m3。
问:为什么 AI 回答时没有理解笔记之间的 [[双链]] 跳转关系?
答:常规向量检索只按单段文本语义相似度召回切片,不会自动顺着双链展开多层邻居节点。提问时可在 Copilot 输入框显式用 @ 同时挂载主笔记与关联笔记,让模型一次性读全上下文。
问:国内没有境外信用卡,想开通 Claude Pro、ChatGPT Plus 配合整理笔记怎么办理,支持报销开票吗?
答:可前往本站 Claude Pro 充值页、ChatGPT Plus 充值页 或 AI 会员充值中心 下单,支持支付宝、微信支付与 AlipayHK 付款,提供无需交出密码的自助卡密兑换模式,企业与科研课题组采购可开具国内增值税发票;实时价格与售后规则(掉订阅按剩余天数折退,封号不在质保范围)以页面展示为准。
相关教程
- Ollama 怎么用:安装、下载模型与常用命令(Windows / macOS / Linux)
- Ollama API 调用教程:本地接口地址、Python 调用与 OpenAI 兼容写法
- Claude API Key 怎么获取:Claude Console 创建密钥、充值与用量查看
- AI 使用隐私与数据安全清单:哪些不能输入、训练开关在哪关
参考资料
- Obsidian 官方帮助文档:Community plugins 安全与管理 — https://help.obsidian.md/Plugins/Community+plugins
- Copilot for Obsidian 官方开源仓库说明 — https://github.com/logancyang/obsidian-copilot
- Smart Connections 官方开源仓库说明 — https://github.com/brianpetro/obsidian-smart-connections
- Ollama 官方 API 文档 — https://docs.ollama.com/api
0 条评论
还没有评论,来抢沙发~