
结论先说
- 调优前先把检索出来的原始片段打印出来肉眼看一遍:如果正确依据根本不在召回的 Top-K 里,换再贵的生成模型也救不回来;九成以上的 RAG 答非所问都出在切块与召回阶段。
- 第一步修切片(Chunking):别按固定字数硬劈表格和标题:改按 Markdown 标题或段落边界递归切分,把父级章节标题拼进每个子块开头,并留出 10% 至 15% 的重叠区防断句。
- 第二步补混合检索(Hybrid Search):单路向量搞不定生僻专有名词:把稠密向量检索(懂同义词语义)和 BM25 稀疏关键词检索(精确定位型号、法条号、错误码)双路并行,再用 RRF 融合排序。
- 第三步加 Rerank 重排序:先广撒网召回 Top-30,再精排截留 Top-5:初筛重速度容易混入似是而非的干扰段,用交叉编码器(Cross-Encoder)逐对重打分后再喂给大模型,准确率提升最立竿见影。
- 模型订阅与团队采购入口:若资料总量不大想直接用官方网页版项目知识库或终端编程工具调优代码,可在本站免外币卡开通 Claude Pro、ChatGPT Plus,更多服务见 AI 会员充值中心。
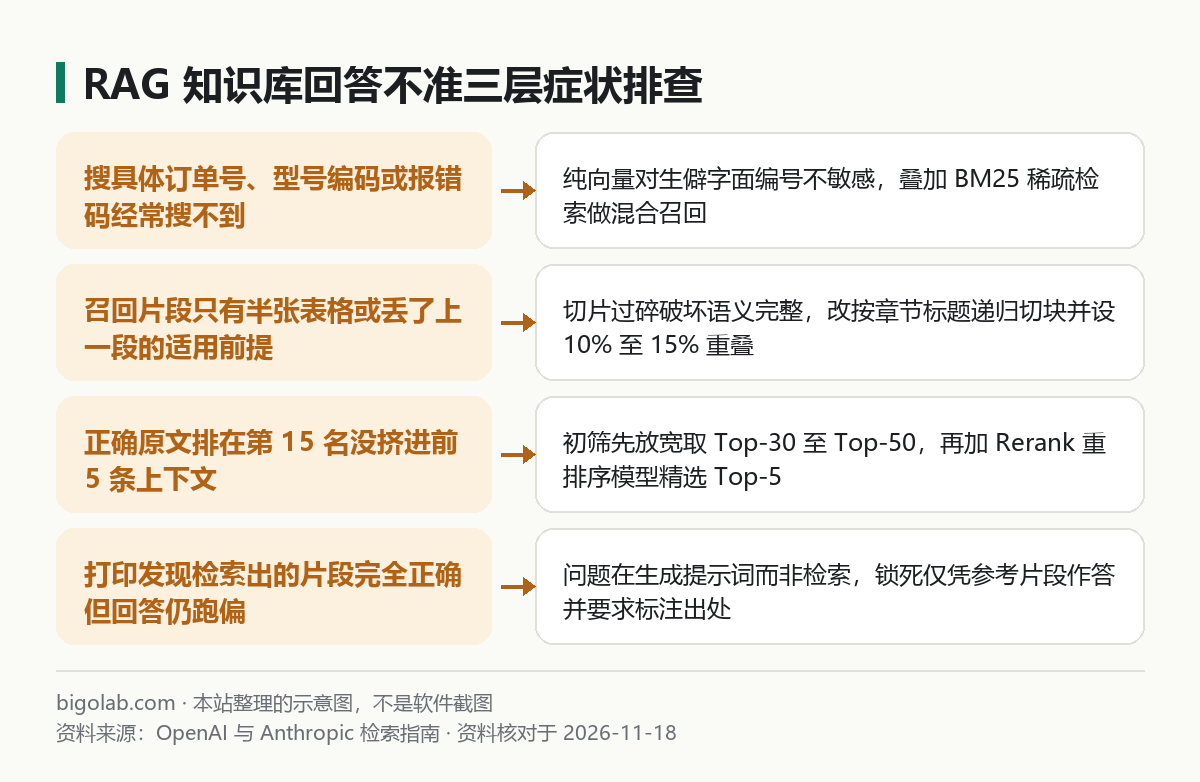
图:本站根据 OpenAI 官方文档:Retrieval 与 Anthropic:Contextual Retrieval 整理的示意图
本文根据 OpenAI 官方文档《Retrieval》与 Anthropic 官方技术文章《Introducing Contextual Retrieval》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 或 Anthropic 官方网站。
适用于谁
- 用默认参数搭完向量知识库,发现搜报错码、合同条款编号、SKU 型号经常漏检或张冠李戴的开发者;
- 准备一个劲换更贵的生成大模型,却还没确认到底是「没搜出来」还是「搜出来了没读懂」的工程师;
- 想拿到 BM25 混合检索倒数排序融合(RRF)与重排序(Rerank)清晰调优顺序的人。
一、第一步:修复结构化切片(Chunking)与元数据注入
在确认资料规模确实超出了纯缓存适用范围(判断边界见 RAG 与长上下文加提示词缓存选型指南)后,先检查入库切片有没有把一句话或一张表劈成两半:
- 按文档层级递归切分,而非按字符死切:优先按
# / ## / ###标题、双换行段落、句号依次降级切分,常规制度与说明文档单块控制在 400 至 800 tokens 左右,相邻块保留 50 至 100 tokens 重叠。 - 整表不拆行,代码块不拆函数:遇到 Markdown 表格一旦从中间截断,下半截数据行就彻底丢了表头列名;解析时应将完整小表作为独立块保留,大表则在拆分后的每一页子表顶部重复拼上表头行。
- 把文档标题与路径塞进块首:一个孤立切片只写「保修期为 24 个月」,向量化后根本分不清是哪款产品(向量模型调用细节见 OpenAI Embeddings 向量教程 与 Gemini Embeddings 任务类型指南)。入库前统一拼接为
[文档:X200 说明书 > 第四章售后] 保修期为 24 个月,能直接消除大量串货错答。
二、第二步:用「BM25 + 稠密向量」混合检索消灭编号漏检
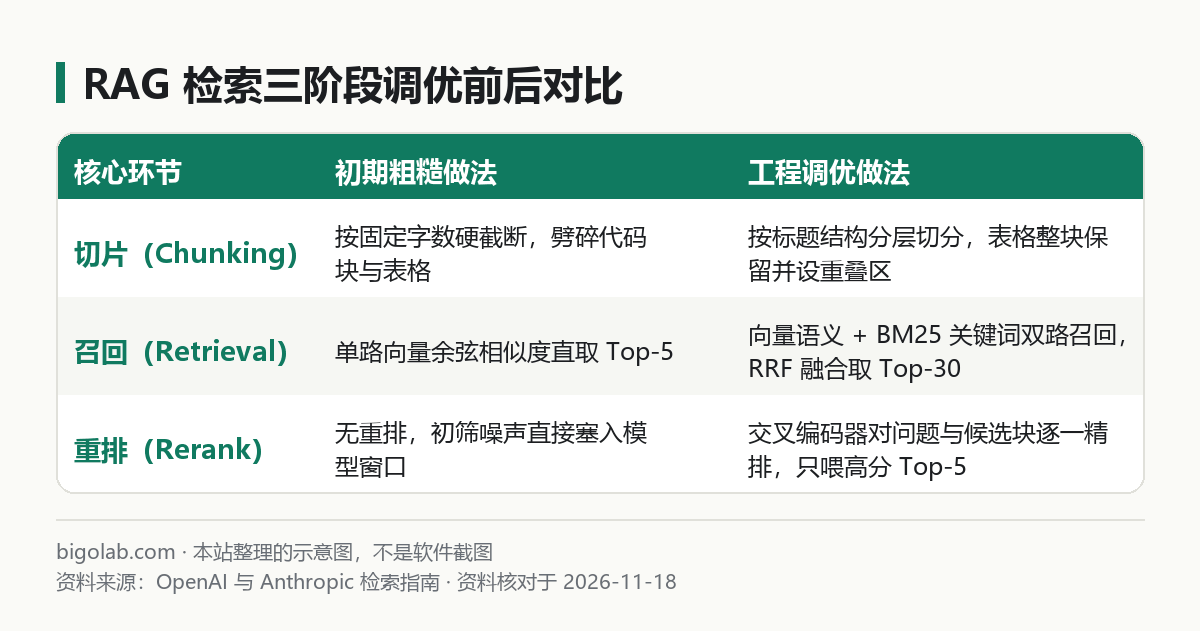
图:本站根据 Anthropic:Contextual Retrieval 整理的示意图
纯稠密向量把整段话压缩成一串浮点数,擅长匹配「怎么退钱」和「退款申请流程」,但遇到 ERR_SSL_PROTOCOL、GB/T 35273 或具体员工工号时,向量距离往往拉不开差距。Anthropic 实验表明,将向量检索与传统 BM25 词频检索合并可显著降低漏召回。两路分数由于量纲不同,最稳妥的无参合并算法是 倒数排序融合(Reciprocal Rank Fusion,RRF):
python
def rrf_merge(dense_ids: list[str], bm25_ids: list[str], k: int = 60, top_n: int = 30) -> list[str]:
    """将向量检索排名与 BM25 排名按 RRF 公式融合,无需手工归一化分数"""
    scores: dict[str, float] = {}
    for rank, doc_id in enumerate(dense_ids, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    for rank, doc_id in enumerate(bm25_ids, start=1):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
    return [doc_id for doc_id, _ in sorted(scores.items(), key=lambda x: x[1], reverse=True)[:top_n]]
凡是在向量路和关键词路排名都靠前的片段,RRF 得分会自动叠加置顶;即便某一路完全没搜到,另一路排第一的精确报错码也能稳稳进入候选池。
订阅与账号准备提示:编写切片清洗脚本与检索评测流水线时,可借助终端编程助手快速生成测试集,国内免境外卡开通可见 Claude Code 订阅说明;若团队不想自运维底层检索库,也可了解自带企业网盘连接器的 ChatGPT Business 团队定制。
三、第三步:接入 Rerank 重排序与锁死生成提示词
双路融合拿到 Top-30 甚至 Top-50 候选块后,如果一股脑全塞给大模型,既浪费输入 Token 又容易触发「中间迷失(Lost in the Middle)」。标准做法是在中间插一道 Rerank(重排序):
- 为什么重排比向量初筛更准:双塔 Embedding 模型是把问题和文档各自独立算成向量再比夹角,没法做词对词的细粒度交互;而 Cross-Encoder 重排模型把「用户提问 + 候选片段」拼在一起过注意力层逐字比对,能精准踢掉「字面都有退货二字、但讲的是供应商退货而非消费者退货」的伪相关块。
- 漏斗参数配比:两路初筛各取 25 至 50 条 → RRF 合并去重留 30 条 → 送入 Rerank 模型按相关性重排 → 截取前 5 至 8 条高分片段拼进提示词。
- 锁死生成端兜底纪律:确认喂进去的 5 段已经包含正确答案后,在
system提示词(长规则可开启 Claude 提示词缓存 降本)里明确要求:「仅依据给定参考片段作答,每条结论句末标注[片段编号];若参考片段未提及,直接回答现有资料未说明,禁止推测」。
常见问题
问:加上 Rerank 重排序后接口变慢了半秒怎么办?
答:重排耗时与送入重排的候选条数及单块字数成正比。把送入 Rerank 的初筛池从 100 条收窄到 25 至 30 条,并控制单块不超过 600 tokens,通常能把重排延迟压在 100 至 200 毫秒以内。
问:用户提问太口语化或带指代词(比如第二轮只问「那海外版呢?」)导致搜不准怎么解?
答:多轮对话进检索器前必须加一步「查询改写(Query Rewriting)」:先用轻量快模型结合前两轮对话把「那海外版呢?」补全成独立完整的检索句「X200 海外版的保修期是多久?」,再拿去跑混合检索。
问:换更大维度的 Embedding 模型和加 Rerank 哪个优先级更高?
答:只要当前已用上主流多语言或中英文向量模型,先补上「BM25 混合检索 + Rerank 重排序」带来的收益通常远大于单纯升级同代更大维度的向量模型,且无需全库重新刷一遍历史数据。
问:人在国内没有外币卡,怎么订阅 Claude、ChatGPT 付费档或开具报销发票?
答:可在本站 AI 会员充值中心 自助选购 Claude Pro 免上号卡密 或 ChatGPT Plus 充值服务(无需交出账号密码),支持支付宝、微信支付与 AlipayHK 付款并可开具增值税发票;实时价格与售后边界(掉订阅按剩余天数折退,封号不在质保范围)以商品页展示为准。
相关教程
- RAG 检索增强生成和直接塞长上下文怎么选:成本、延迟、更新频率与官方选型判断框架
- OpenAI Embeddings 向量怎么用:text-embedding-3-small 调用、dimensions 缩短与搜索
- Gemini API Embeddings 文本向量怎么用:gemini-embedding 调用与任务类型
- Claude 提示词缓存(Prompt Caching)入门:缓存时间、价格倍率与命中率
参考资料
- OpenAI API 官方文档:Retrieval — https://platform.openai.com/docs/guides/retrieval
- Anthropic 官方技术博客:Introducing Contextual Retrieval — https://www.anthropic.com/news/contextual-retrieval
0 条评论
还没有评论,来抢沙发~