
结论先说
- 裸塞长上下文只适合偶发单次提问;高频问答必须在「长上下文 + 提示词缓存(Prompt Caching)」与「RAG 检索增强生成」之间做选择。
- 资料总量小于 20 万 token(Anthropic 官方参考线,约 500 页文本)且内容相对静态时,优先用长上下文 + 提示词缓存。省去切块、向量化与重排链路,也不会因漏召回而答错跨章节问题。
- 资料达到 GB 级、百万条记录,或内容每分钟都在变动,必须用 RAG。物理窗口装不下全量数据,高频改动也会不断击穿前缀缓存。
- 必须核算缓存存活期(TTL)内的访问频率:如果几小时才有人问一句,缓存每次都已过期重算,轻量级 RAG 反而更省钱。
- 生产环境常采用混合架构:把固定的系统指令、工具定义、核心手册放前缀开缓存,再用 RAG 把海量库里检出的动态片段拼在消息末尾。
- 国内免卡开通与账号服务入口:自有账号免上号自助开通可见本站 Claude Pro 充值页 与 Claude Max 充值页;缺可用账号或遇身份核验可查看 Claude 注册说明 与 Claude KYC 认证协助。
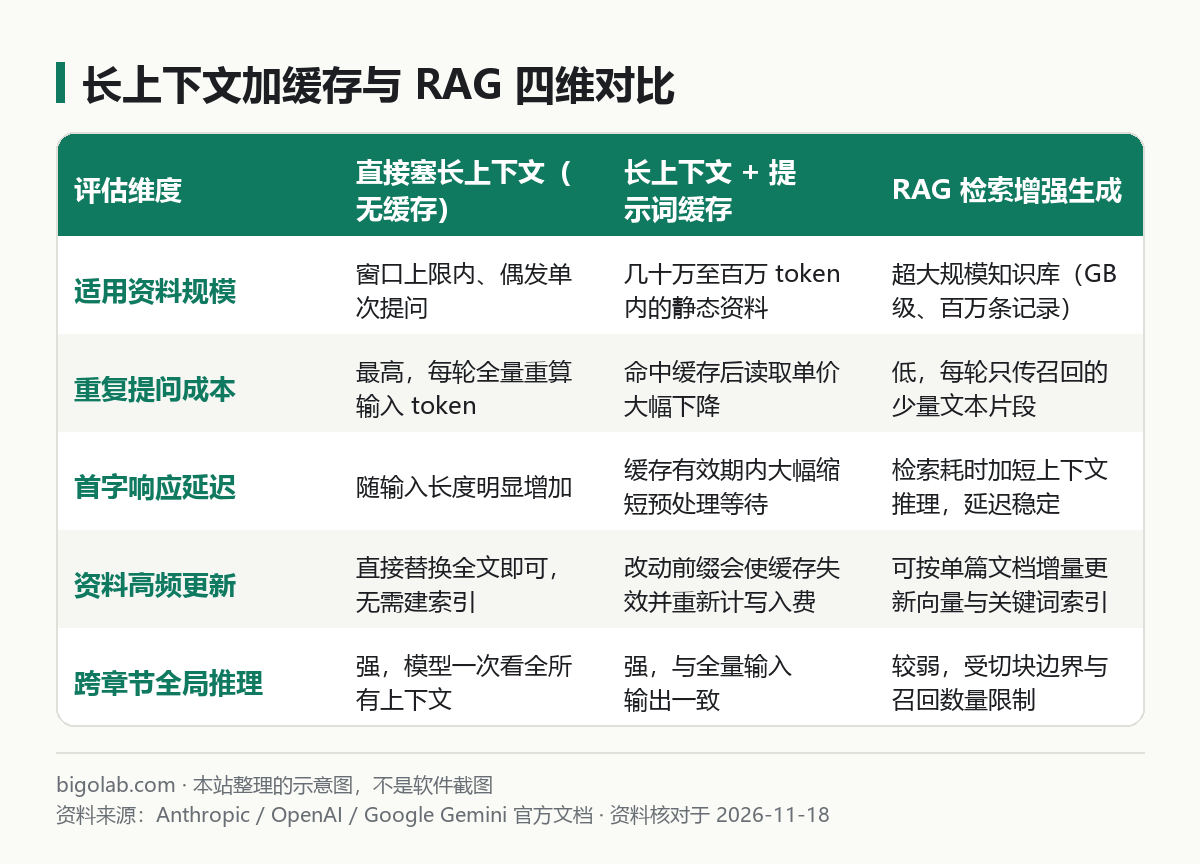
图:本站根据 Anthropic:Introducing Contextual Retrieval 与 Google Gemini:Long context 整理的示意图
本文根据 Anthropic 官方文档《Prompt caching》《Introducing Contextual Retrieval》、OpenAI 官方文档《Prompt Caching》《Retrieval》与 Google Gemini API 官方文档《Long context》《Context caching》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic、OpenAI 或 Google 官方网站。
适用于谁
- 准备搭建企业制度问答、产品手册客服或代码库分析工具,纠结要不要上向量数据库的开发者;
- 听说模型支持百万级上下文,想知道「RAG 是不是不用做了」的技术负责人;
- 把长文档直接塞进 API 提示词后发现账单偏贵、首字响应偏慢,想找优化方案的人。
一、本质差异:切块召回 vs 全量缓存
传统 RAG 先把文档切成几百字的小块(Chunks)转成向量入库,提问时只取最相关的几个片段放进提示词。它的短板是切块有损:一旦问题需要跨十几个章节汇总数据,或者切块切断了上下文指代,检索漏掉后模型就无法作答。
Google 在《Long context》文档中对比指出:把整份代码库或多篇财报一次性塞进几十万至百万 token 的窗口,模型拥有全局视野,能直接完成跨文档推理。而各家推出的提示词缓存(Prompt Caching / Context Caching)解决了每次重算全量 token 太贵太慢的问题:把固定前缀的计算状态留在服务端内存,有效期内再次命中同一前缀时大幅降低输入单价与首字等待。
二、三家官方的提示词缓存规则对比
| 平台 | 触发方式 | 缓存有效期(TTL) | 计费特点(按官方规则) |
|---|---|---|---|
| Claude API | 顶层自动缓存,或在内容块标 cache_control | 默认 5 分钟(命中续期),可选 1 小时 | 写入按 1.25 倍或 2 倍计费;读取通常降至基础输入价的 0.1 倍及以下 |
| OpenAI API | 达最短门槛(通常 1024 token 起)且前缀一致时自动触发 | 按近期访问热度自动保留(通常数分钟至一小时内) | 写入不加价,命中部分按官方折扣输入单价计费 |
| Gemini API | 除隐式缓存外,可显式调用 Context Caching 上传大文件 | 支持自定义指定存活时长 | 按缓存读取单价加按小时驻留存储费两部分计费 |
Claude 缓存断点与命中率排查详见 Claude 提示词缓存入门教程。如果不调 API、只在网页端传几十页项目资料日常提问,可直接用官方网页版的项目知识库(Projects),需要更大上传容量与长窗口额度时可了解 ChatGPT Plus 或 Claude Pro;网页端窗口规则见 ChatGPT 上下文长度限制 与 Claude 上下文超限处理办法。
三、四步选型判断框架
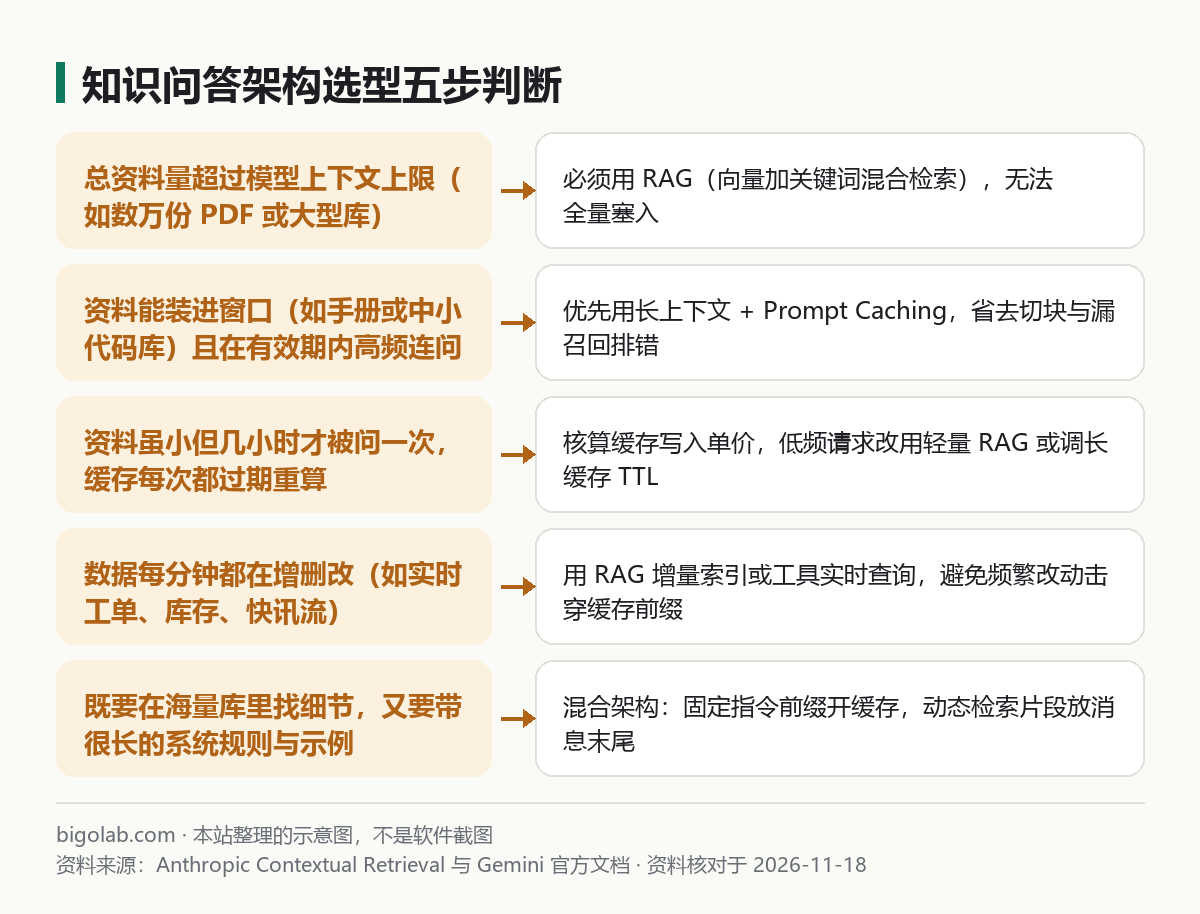
图:本站根据 Anthropic:Prompt caching 与 OpenAI:Retrieval 整理的示意图
- 看资料总规模:小于 20 万 token 的静态手册,Anthropic 明确建议整份塞入并开 Prompt Caching,不必搭向量库;20 万到 100 万 token 之间,做整书归纳走长窗口,查孤立小事实走 RAG(国产百万窗口表现可参考 DeepSeek 上下文长度说明);超过百万 token 必须上 RAG。
- 看请求间隔:高峰期每分钟都有提问,5 分钟缓存持续续期,长上下文极划算;若一天只问两三次,每次都冷启动重算几十万 token,账单会远高于每次只传几千 token 的 RAG。
- 看更新频率:提示词缓存要求前缀一字不差,前缀里改一个字就会使后续缓存全部失效。年度手册、法规汇编适合进缓存;每分钟变动的工单、库存、资讯流只能用 RAG 增量索引或工具实时查询。
- 看问题形态:「报错码 E4012 是什么」这类局部查点,关键词(BM25)加向量检索最快最省;「汇总两百页纪要里所有人的分歧」这类全局综合,优先走长上下文全量输入。
四、混合架构:固定前缀开缓存 + 动态片段走 RAG
知识库大到必须用 RAG 时,仍可把两者结合起来:
- 切块时补背景(Contextual Retrieval):按 Anthropic 官方方案,切分长文时先让模型结合全文给每个小块生成 50 到 100 字背景说明,拼在小块前再建向量与 BM25 索引;生成说明时对整篇原文开启 Prompt Caching 压低预处理成本。
- 提问时静态在前、检索在后:严格按「工具定义 → 系统规则与固定示例(此处打缓存断点)→ 本轮 RAG 召回片段 + 用户提问」组装请求,让前半截始终命中缓存。
python
# 静态前缀放在 system 并开启缓存,动态检索片段放 messages 末尾
messages = [
    {
        "role": "user",
        "content": f"参考片段:\n{rag_chunks}\n\n问题:{user_query}"
    }
]
常见问题
问:有了百万级上下文,全塞进去准确率一定比 RAG 高吗?
不一定。Google 与 OpenAI 文档均指出,无关背景过多时仍可能干扰细小事实定位并拖慢响应;若只需一小段明确依据,干净的高相关性检索片段往往更快更准。
问:开了 Prompt Caching 为什么账单没降?
常见原因有三:把时间戳或动态检索内容放在了提示词开头破坏了前缀一致;未达到该模型最短可缓存 token 门槛;两次提问间隔超过了缓存 TTL。
问:OpenAI 的 File Search 属于长上下文还是 RAG?
属于托管式 RAG。OpenAI《Retrieval》文档说明它会自动解析文件、切块、生成向量并做混合检索,无需自建向量库。
问:人在国内没有外币信用卡,怎么订阅或升级 Claude 付费套餐?
答:可在本站 AI 会员充值总览页 选择 Claude Pro 自助充值 或 Claude Max 充值,付款后即时发卡密、24 小时自助兑换且可开具增值税发票;实时价格与售后边界(含封号不质保)以商品页当天展示为准。
相关教程
- Claude 提示词缓存(Prompt Caching)入门:缓存时间、价格倍率与命中率
- ChatGPT 上下文长度与字数限制:一次能输入多少字、长对话变慢怎么办
- Claude 上下文长度不够、对话太长怎么办:报错提示与各模型窗口大小
- DeepSeek 上下文长度与最大输出是多少:1M 上下文与超限表现
参考资料
- Claude API 官方文档:Prompt caching — https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Anthropic 官方技术博客:Introducing Contextual Retrieval — https://www.anthropic.com/news/contextual-retrieval
- OpenAI API 官方文档:Prompt Caching — https://platform.openai.com/docs/guides/prompt-caching
- OpenAI API 官方文档:Retrieval — https://platform.openai.com/docs/guides/retrieval
- Google Gemini API 官方文档:Long context — https://ai.google.dev/gemini-api/docs/long-context
- Google Gemini API 官方文档:Context caching — https://ai.google.dev/gemini-api/docs/caching
0 条评论
还没有评论,来抢沙发~