
本文根据 DeepSeek 官方 API 文档整理,资料核对于 2026-10-24。数字可能随模型更新变化,以官方页面和接口返回为准。图为本站整理的示意图。
适用于谁
- 搜「deepseek 上下文长度」「deepseek 最大输出」「deepseek 能处理多长的文档」的人;
- 想一次性丢一整本书、一个大仓库给它的人;
- 遇到输出被截断、请求报 400 说太长的开发者。
结论先说
- 上下文长度是 1M,最大输出长度是 384K。官方价格页的模型细节里,
deepseek-flash和deepseek-v4-pro这两行写的是相同的数字:上下文长度 1M,输出长度最大 384K。 - 精确数字:官方「获取模型列表」接口的示例里,两个模型都是
context_window1048576(输入和输出 token 合计)、max_output_tokens393216(max_tokens可接受的最大值)。 - 上下文包括输入和输出合计:接口文档对
context_window的说明是「输入与输出 token 合计」,所以输入越长,留给输出的空间越少。 - 超过限制会报错,而不是自动截断:Responses API 文档写明,
truncation参数不支持,输入超出上下文窗口时返回 400 错误。
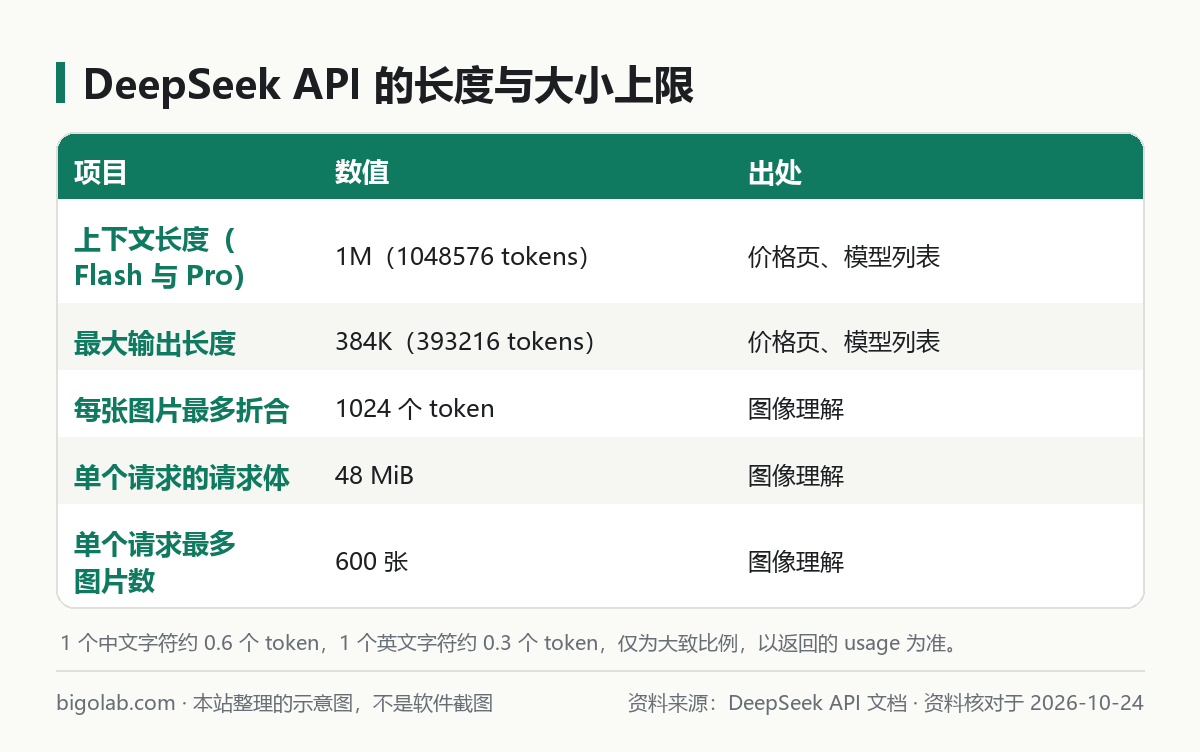
图:本站根据 DeepSeek 官方价格页 与图像理解文档整理的示意图
一、1M token 大概是多少字
token 是模型的计量单位,也是计费单位。官方 Token 用量文档给出的大致换算:
- 1 个英文字符约 0.3 个 token;
- 1 个中文字符约 0.6 个 token;
- 但不同模型的分词不同,实际处理的 token 数以返回结果里的
usage为准。
按这个比例粗略估算,1M(约 105 万)token 对应的中文大约是一百多万字符的量级。这只是估算,具体内容里夹杂代码、数字、英文时差别会很大,所以真要接近上限,务必用 usage 或官方提供的离线 tokenizer 去算。官方文档提供了 tokenizer 压缩包下载,可以在本地离线计算一段文本的 token 用量。
二、输出长度:384K 是上限,不是建议
最大输出 384K 说明模型单次回复最多可以很长。几点提醒:
- 设置
max_tokens就是限制这次最多输出多少。JSON 输出尤其要设够,官方提醒设置太小会让 JSON 被中途截断,见 /guides/deepseek-json-output-function-calling; - 思考模式下,思维链也算输出。官方 2025-05-28 的 R1-0528 说明里提到那一代模型的
max_tokens包含思考过程,默认 32K、最大 64K,那是旧模型的规则;现在的上限见价格页,是否包含思维链请以最新官方文档为准; - 写长文时,更长不等于更好,分章节写更容易控制,参考 /guides/deepseek-write-novel-prompts。
三、图片、请求体大小的限制
给 deepseek-flash 传图片时,官方图像理解文档给出这些数字:
- 每张图片会自动缩放,每张图消耗的 token 数有上限,为 1024 个,比如 2000×2000 和 5000×5000 的图片,缩放后消耗的 token 数相同;
- 请求体大小限制 48 MiB(内联的 base64 图片计入);
- 外部 URL 图片最大 32 MiB,URL 长度最多 8192 个字符,需在 60 秒内下载完成;
- 通过 Files API 上传、用
file_id引用的图片最大 64 MiB; - 单个请求最多 600 张图片;图片最长边最多 8192 像素,一个请求包含 15 张及以上图片时降为 4096 像素;
detail设为low时,图片在推理前缩放到 512×512,更快、更省 token。
DeepSeek-V4 Pro 不支持图像输入。图片相关的更多说明见 /guides/deepseek-upload-file-image。
四、长上下文怎么省钱:缓存
官方的「上下文硬盘缓存」对所有用户默认开启。简单说:后续请求和之前请求的前缀重复的部分,计入「缓存命中」,单价低很多。命中的前提是前缀被完整匹配:
- 多轮对话里,第二轮请求里包含第一轮请求的全部内容,就能命中第一轮的缓存;
- 如果第一轮是 A+B,第二轮是 A+C,第二轮没法命中;但系统检测到公共前缀 A 后会把 A 单独缓存,第三轮 A+D 就能命中 A。
所以把固定的系统提示、长文档放在最前面,把会变化的问题放在最后,能让缓存命中率更高。命中与未命中的价格见 /guides/deepseek-v4-pro-vs-flash-api-price。
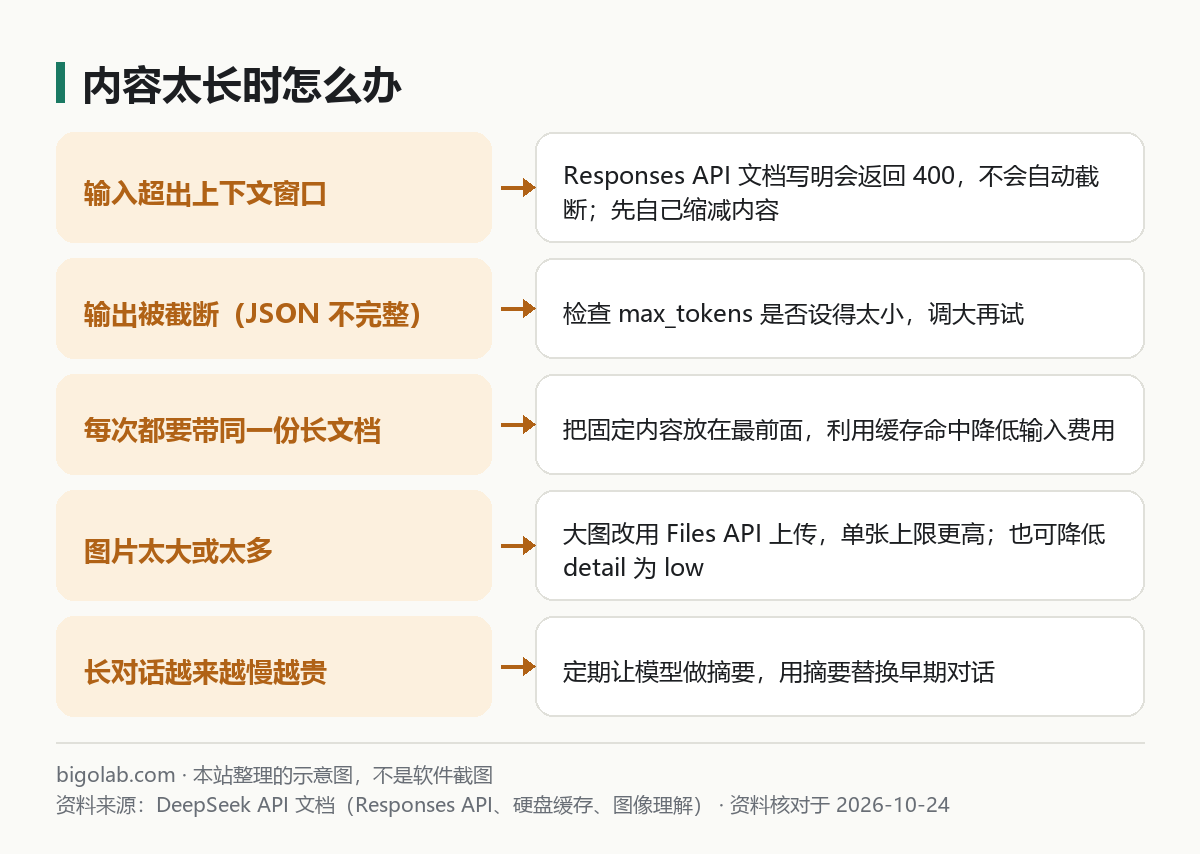
图:本站根据 DeepSeek 官方 Responses API、硬盘缓存与图像理解文档整理的示意图
常见问题
Q:1M 上下文是不是意味着可以把整本书丢进去问?
容量上可以,但内容越长,响应越慢、费用越高,也更容易出现「中间部分被忽略」的情况。长文档提问的技巧见 /guides/long-document-prompting-tips。
Q:网页版能上传多大的文件、对话能多长?
官方没有给统一数字,界面会有提示,见 /guides/deepseek-upload-file-image。
Q:不同模型的上下文一样吗?
价格页上 deepseek-flash 和 deepseek-v4-pro 相同。别家模型各自不同,比如 ChatGPT 的见 /guides/chatgpt-context-length-limits。
Q:输出被截断了怎么办?
先看返回的结束原因,再检查 max_tokens;JSON 输出被截断时调大它。报错类问题见 /guides/deepseek-api-error-codes。
想同时用 ChatGPT、Claude 等海外模型做对比?本站提供 AI 会员充值,ChatGPT 可看 Plus 充值。
参考资料
- DeepSeek API 文档:模型 & 价格 — https://api-docs.deepseek.com/zh-cn/quick_start/pricing
- DeepSeek API 文档:获取模型列表 — https://api-docs.deepseek.com/zh-cn/api/list-models
- DeepSeek API 文档:Token 用量计算 — https://api-docs.deepseek.com/zh-cn/quick_start/token_usage
- DeepSeek API 文档:使用 Responses API — https://api-docs.deepseek.com/zh-cn/guides/responses_api
- DeepSeek API 文档:上下文硬盘缓存 — https://api-docs.deepseek.com/zh-cn/guides/kv_cache
- DeepSeek API 文档:图像理解 — https://api-docs.deepseek.com/zh-cn/guides/vision
- DeepSeek-V4 预览版发布公告 — https://api-docs.deepseek.com/zh-cn/news/news260424
0 条评论
还没有评论,来抢沙发~