
本文根据 DeepSeek 官方公告、更新日志和价格页整理,资料核对于 2026-10-24。DeepSeek 更新很快,以官方页面为准。图为本站整理的示意图。
适用于谁
- 搜「deepseek v4.1 flash」「deepseek v4 flash 0731」的人;
- 看到几个相近的版本号、不知道区别的人;
- 想知道代码里该写哪个模型名的开发者。
结论先说
- V4.1 Flash 是 DeepSeek 2026-09-10 发布的模型,官方称它是新模型结构系列中最小尺寸的模型,具备原生多模态视觉理解能力。
- API 里用
deepseek-flash。官方价格页写明,当前版本是 DeepSeek-V4.1-Flash-1017(2026-10-17 升级而来)。 - 0731 是更早的版本:2026-07-31 的 V4-Flash 正式版(API 公测,模型名
deepseek-v4-flash),已被取代;旧名仍可调用,但对应模型已下线,请求由新版提供服务。 - 价格和调用方式没有因为 1017 升级而变,官方说明仍用
deepseek-flash即可。
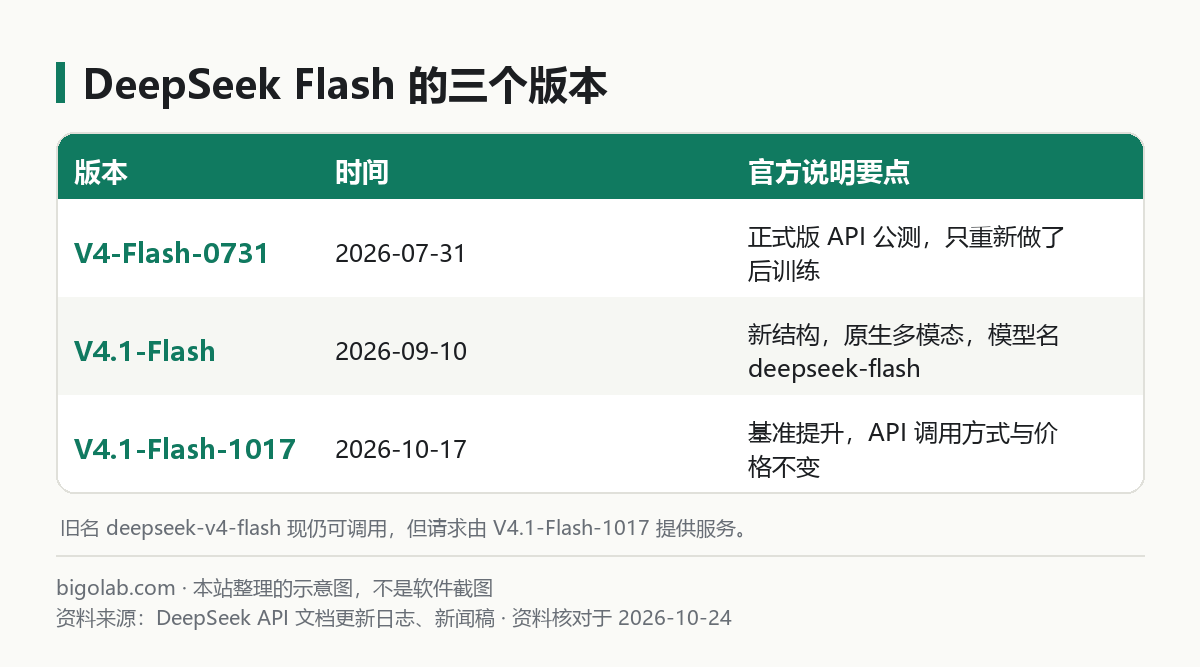
图:本站根据 DeepSeek 官方更新日志 整理的示意图
一、三个版本分别是什么
V4-Flash-0731(2026-07-31)
官方更新日志:DeepSeek-V4-Flash 正式版 API 上线公测,模型名 deepseek-v4-flash。官方称 Agent 能力大幅增强、基准测试远超 V4-Pro-Preview,并原生支持 Responses API 格式、针对性适配 Codex。关键的一句:0731 的模型结构、尺寸和 Preview 版本保持一致,仅重新进行了后训练;这次只升级了 API 接口,Pro 的 API 以及 App / 网页端模型没有改动。
V4.1-Flash(2026-09-10)
官方公告的核心信息:
- 结构:552B 参数的 MoE 模型,采用新的 Causal-Encoder-Decoder 结构,输入和输出不对称,输入激活只有 8B,输出激活 16B,官方称成本显著低于已知的同尺寸模型;
- 更少缓存:新一代模型大幅减少了 KV Cache 的大小,对 HBM 的需求减少到上一代的 1/4,对 SSD 的需求减少到 1/8;官方在 Agent 场景下,缓存命中的费用占比往往较高,所以压缩 KV Cache 能显著降低成本;
- 原生多模态:具备视觉理解能力,API 把模型名改为
deepseek-flash即可调用; - 对 Pro 的关系:官方称 V4.1 Flash 在性能、费用、速度、总用时等指标上全面超越 V4 Pro;同日更新日志说明 V4 Pro 的 API 在 2026-09-14 之后继续提供、计费方式不变;
- 价格下调:新价格自 2026-09-10 12:00 起生效,见 /guides/deepseek-price-changes-timeline;
- 合作方:腾讯的 WorkBuddy、CodeBuddy 和 OpenCode 作为官方合作伙伴,已接入 V4.1 Flash。
官方公布了一组基准成绩,例如 GPQA Diamond 90.9、Codeforces(Rating)3471、Terminal-Bench 2.1 为 90.6、DeepSWE v1.1 为 74.2 等;同时标注了测试口径(如 HLE 括号里的数字仅在纯文本子集上测试)。这些是官方自己的评测,不同框架、不同任务结果不同,建议只当参考。
V4.1-Flash-1017(2026-10-17)
官方说明:V4.1 Flash 升级到 DeepSeek-V4.1-Flash-1017,网页端、App 与 API 模型同步更新。相比上一版本在各基准测试中取得提升,官方更新日志给出的成绩包括 Terminal-Bench 4.0 为 42.3(用 Claude Code 框架测试)、DeepSWE v1.1 为 77.0(用 Mini-SWE-V2 框架测试)、HLE(不带工具)42.6 等。官方还说:缩短了任务运行时间和输出长度,让用户以更低成本、更快速度完成任务;特别针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等平台框架做了优化,建议升级到 DeepSeek Harness 0.2.1-rc.1 及以上版本。
同日还发布了:自研搜索 API(Search 与 Fetch,各 5 元 / 千次),以及模型权重的开源(Hugging Face 与 ModelScope 上有 DeepSeek-V4.1-Flash-1017)。
二、API 怎么调用
官方价格页参数:
| 项目 | 内容 |
|---|---|
| 模型名 | deepseek-flash |
| 当前版本 | DeepSeek-V4.1-Flash-1017 |
| Base URL | OpenAI 格式 https://api.deepseek.com,Anthropic 格式 https://api.deepseek.com/anthropic |
| 上下文 / 输出 | 1M / 最大 384K |
| 思考模式 | 支持思考与非思考,默认思考 |
| 图像理解 | 支持(Pro 不支持) |
| 并发限制 | 2500 |
旧模型名 deepseek-v4-flash、deepseek-v4-flash-vision-exp 仍可调用,但对应模型已下线,请求由 V4.1-Flash-1017 提供服务,按 Flash 价格计费,官方建议改用 deepseek-flash。
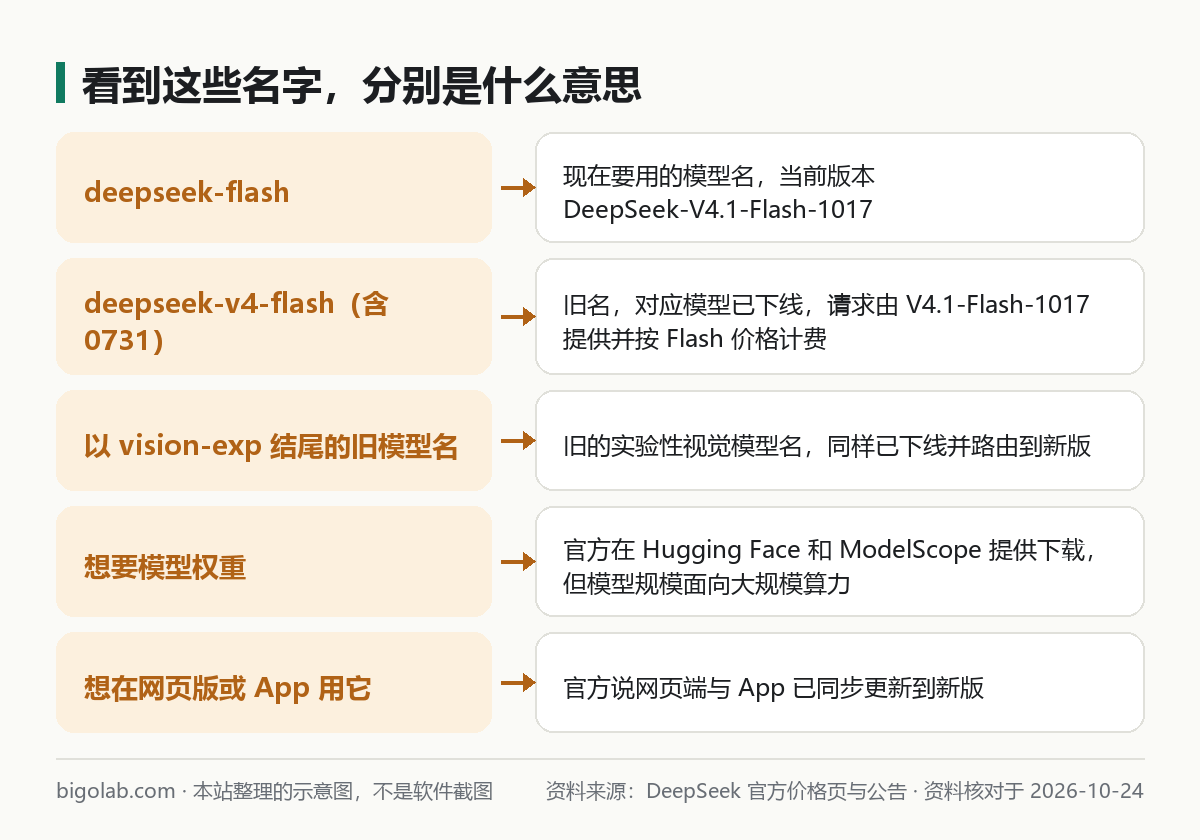
图:本站根据 DeepSeek 官方价格页与公告整理的示意图
- 价格:空闲时段输出 4 元 / 百万 token,高峰 8 元,逐项见 /guides/deepseek-v4-pro-vs-flash-api-price;
- 思考模式开关与强度:/guides/deepseek-thinking-mode-reasoning-effort;
- 识图:/guides/deepseek-multimodal-image-recognition;
- 上下文与输出上限:/guides/deepseek-context-length-output-limit。
三、想在本地跑它可以吗
官方公告说权重已在 Hugging Face 开源,并说如果有大规模部署需求且具备相应资源(2k 卡 GPU、有存储集群),欢迎联系官方。也就是说它面向的是有大规模算力的机构,不是个人电脑的选项。个人电脑能跑的是 R1 蒸馏小模型,见 /guides/deepseek-local-deploy-hardware-requirements。
常见问题
Q:V4.1 Flash 和 V4 Pro 选哪个?
官方没有写所有任务都选哪个。官方称 V4.1 Flash 在多项指标上超过 V4 Pro,但 Pro 的 API 仍在提供,且两者在图像理解、并发上限、价格上不同,对比见 /guides/deepseek-v4-pro-vs-flash-api-price。
Q:网页版是不是已经用上了 1017?
官方更新说明写网页端与 App 已同步更新到新版。入口见 /guides/deepseek-how-to-use。
Q:V4 正式版是什么?
见 /guides/deepseek-v4-official-release-changes。
Q:用 Claude Code、Codex 能接它吗?
可以,见 /guides/deepseek-claude-code-setup、/guides/deepseek-codex-setup。
想同时用 ChatGPT、Claude 等海外模型做对比?本站提供 AI 会员充值,ChatGPT 可看 Plus 充值。
参考资料
- DeepSeek-V4.1-Flash 发布(2026-09-10)— https://api-docs.deepseek.com/zh-cn/news/news260910
- DeepSeek-V4.1-Flash-1017 发布(2026-10-17)— https://api-docs.deepseek.com/zh-cn/news/news261017
- DeepSeek API 文档:更新日志 — https://api-docs.deepseek.com/zh-cn/updates
- DeepSeek API 文档:模型 & 价格 — https://api-docs.deepseek.com/zh-cn/quick_start/pricing
- DeepSeek 官网:V4.1 Flash 新闻稿 — https://www.deepseek.com/news/deepseek-v4-1-flash/
0 条评论
还没有评论,来抢沙发~