
本文根据 Ollama 官方模型库与文档、DeepSeek 官方公告整理,资料核对于 2026-10-24。官方没有给出本地部署的最低配置表,下文的估算方法是整理出来的建议。图为本站整理的示意图。完整的安装与运行命令见 /guides/deepseek-local-deploy-ollama。
适用于谁
- 搜「deepseek 本地部署硬件要求」「deepseek 本地 部署 配置 要求」的人;
- 想知道自己的电脑(显存多大、内存多少)能跑哪个尺寸的人;
- 准备买显卡、内存之前,想先弄清楚需求的人。
结论先说
- 官方没有给「最低配置」表。Ollama 模型页只列了每个标签的文件体积和上下文窗口。所以「要什么配置」要自己从体积出发估算。
- 个人电脑上能跑的是蒸馏小模型,不是官方在线版。Ollama 上的
deepseek-r1从 1.5b 到 70b 是用 DeepSeek-R1 的数据在 Qwen、Llama 等基座上蒸馏的;只有 671b 才是完整的 DeepSeek-R1,文件 404GB。 - 估算口诀:显存(或内存)要大于文件体积,还要给上下文留余量。装不下就会有一部分跑在 CPU 上,变慢。
- 上下文长度默认由显存决定:显存不到 24GiB 默认只有 4k,很多「读长文档读到一半忘了」的问题就出在这里。
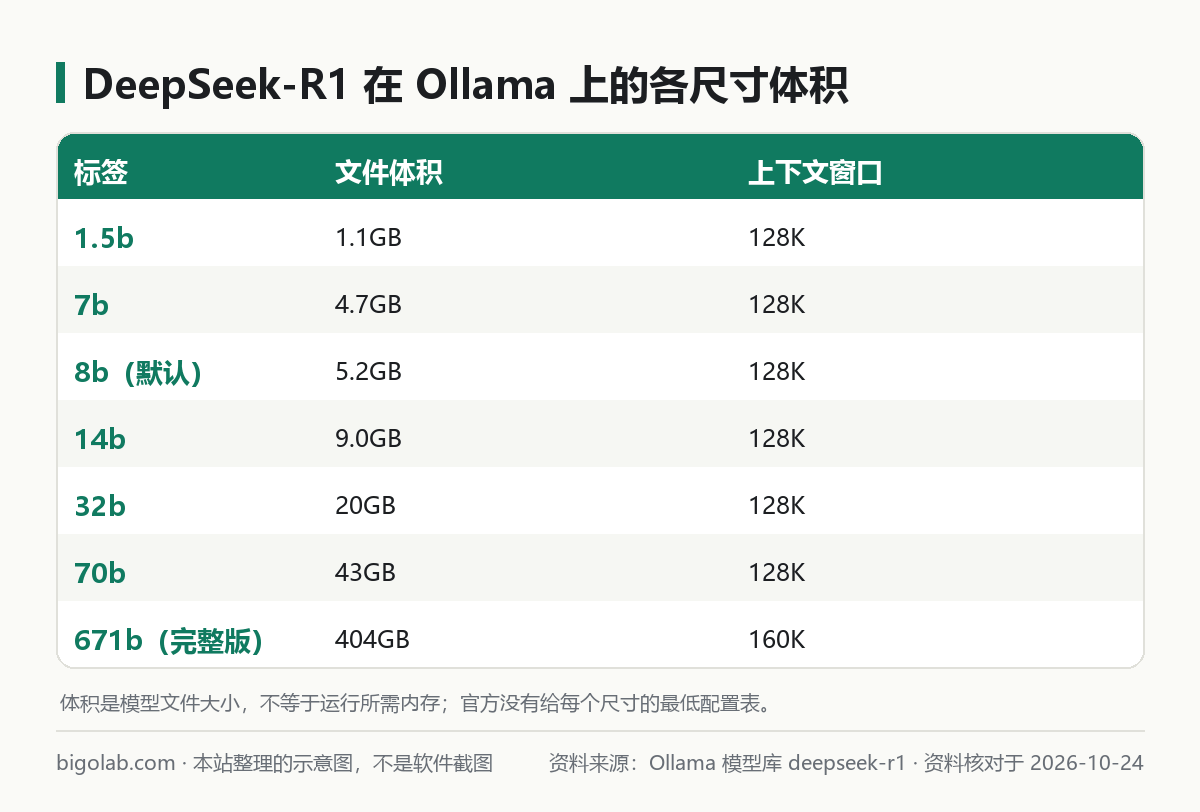
图:本站根据 Ollama 模型库 deepseek-r1 整理的示意图
一、各尺寸体积(Ollama 官方标签页)
上图是默认量化版本的体积。同一个尺寸还有不同精度的版本,精度越高体积越大。以标签页列出的两个尺寸为例:
| 尺寸 | q4_K_M(默认) | q8_0 | fp16 |
|---|---|---|---|
| 1.5b | 1.1GB | 1.9GB | 3.6GB |
| 7b | 4.7GB | 8.1GB | 15GB |
也就是说,同样是 7b,换成 fp16 精度,体积是默认的三倍多。拿不准就用默认标签,别一上来追求高精度。
另外两点:
- 默认的 8b(
ollama run deepseek-r1)是 DeepSeek-R1-0528-Qwen3-8B,在 Qwen3 8B 上蒸馏的版本; - Ollama 搜索页里还有
deepseek-v4.1-flash、deepseek-v4-pro,它们标注的是按 token 计费(带 in / out 价格),是通过 Ollama 云端调用的在线模型,不是下载到本地运行的。
二、怎么估算自己的电脑能跑什么
官方没有给公式,下面是一个够用的思路:
- 有独立显卡:看显存。可用显存 ≥ 文件体积 + 一些余量(上下文越大余量越多)。比如 8GB 显存可以考虑 7b / 8b(4.7–5.2GB)这一档,12–16GB 可以试 14b(9.0GB),24GB 可以试 32b(20GB),这是根据体积推算的,不是官方保证;
- 没有独立显卡:用内存跑,速度慢。内存要明显大于文件体积,还要留给系统和其他程序;
- 多张卡或统一内存(如部分笔记本):同样看总的可用容量,具体支持情况看 Ollama 的硬件支持页;
- 硬盘:至少留出文件体积的空间,更新模型时还会再占一份。
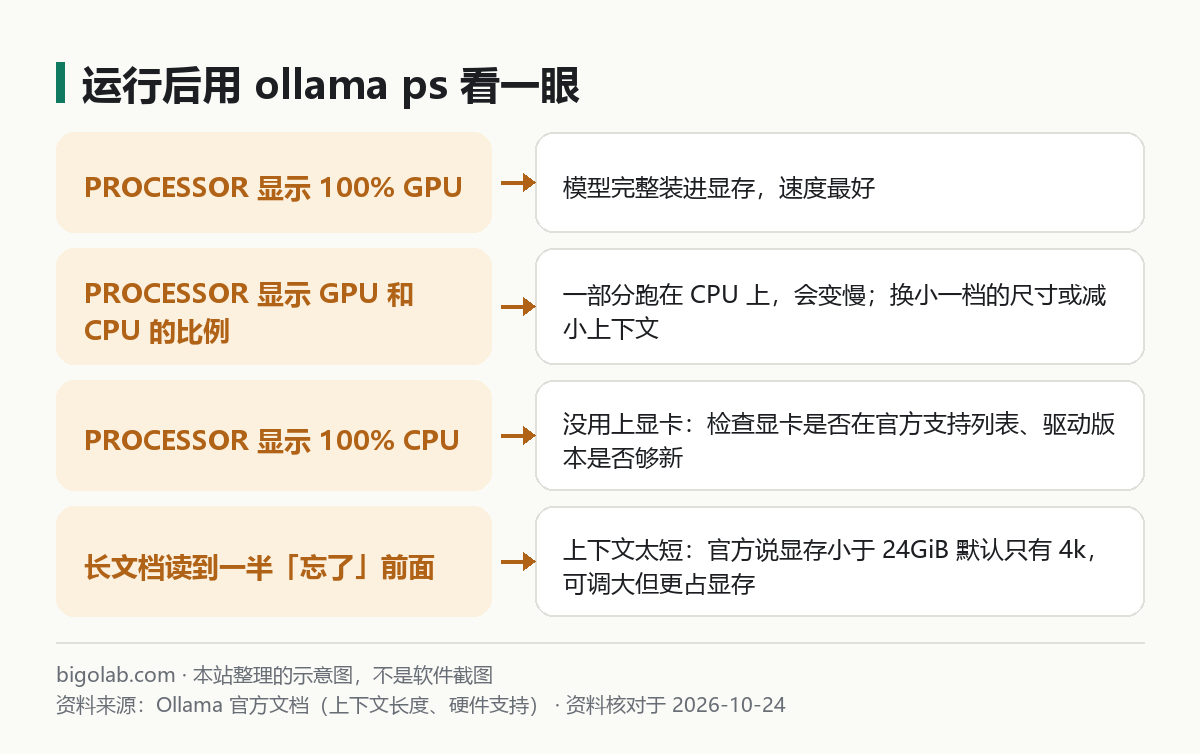
图:本站根据 Ollama 官方上下文长度文档 整理的示意图
三、显卡支持范围
Ollama 硬件支持页写明,Nvidia 显卡需要计算能力 5.0 以上、驱动版本 550 及更新;计算能力 5.0 到 6.2 的显卡需要驱动 570 及更新。页面里按计算能力列出了具体型号,比如 RTX 30 / 40 / 50 系列、GTX 10 系列等。AMD 显卡和其他平台的支持范围也在同一页,请以官方页面为准。如果装好后 ollama ps 显示 100% CPU,先检查这两点:显卡在不在列表里、驱动够不够新。
四、上下文长度怎么设
Ollama 官方文档给出的默认值:
- 显存小于 24GiB:4k;
- 24–48GiB:32k;
- 48GiB 及以上:256k。
官方还建议,联网搜索、Agent 和编程工具这类任务至少设到 64000。调整方法是在 Ollama 桌面应用设置里拖滑块,或启动服务时设置环境变量:
bash
OLLAMA_CONTEXT_LENGTH=64000 ollama serve官方提醒:上下文越长,需要的内存越多。设大之后用 ollama ps 看 PROCESSOR 一列有没有出现 CPU 的比例,有的话说明装不下了,要减小上下文或换小一档的模型。
五、本地版和官方在线版的区别
官方在线版(网页 / App / API)当前是 DeepSeek-V4.1-Flash 和 V4 Pro,上下文 1M,见 /guides/deepseek-v4-pro-vs-flash-api-price。本地能下载的 R1 蒸馏小模型是更早一代的推理模型,能力和在线版有明显差距,也没有官方的联网搜索。本地部署的价值在于离线、数据不出本机、不排队,而不是更强。
如果你只是想要「更好用」,直接用官方在线版更省事,网页版用法见 /guides/deepseek-how-to-use,API 见 /guides/deepseek-api-key。
常见问题
Q:16GB 内存、没有独显能跑吗?
能跑小尺寸(如 1.5b、7b、8b),速度会慢。体积 5.2GB 的 8b 对 16GB 内存来说是可行的起点,但要留出系统和其他程序的空间。
Q:想跑完整的 DeepSeek-R1(671b)要什么?
官方标签页写的文件体积是 404GB,需要服务器级的大内存或多卡,个人电脑基本做不到。
Q:下载的模型占多大?
就是标签页上的文件体积,例如 deepseek-r1:8b 约 5.2GB。
Q:还有更小的版本吗?
有,1.5b 只有 1.1GB,但能力有限,适合试跑和简单任务。
想同时用 ChatGPT、Claude 等海外模型做对比?本站提供 AI 会员充值,ChatGPT 可看 Plus 充值。
参考资料
- Ollama:deepseek-r1 模型库页面及标签页 — https://ollama.com/library/deepseek-r1
- Ollama 文档:Context length — https://docs.ollama.com/context-length
- Ollama 文档:Hardware support — https://docs.ollama.com/gpu
- Ollama:deepseek 搜索结果 — https://ollama.com/search?q=deepseek
- DeepSeek API 文档:DeepSeek-V4.1-Flash 发布 — https://api-docs.deepseek.com/zh-cn/news/news260910
0 条评论
还没有评论,来抢沙发~