
结论先说
- 提问开头第一句必须写死「数据库方言与版本号 + 真实 DDL 表结构」:PostgreSQL、MySQL 8.4、BigQuery、ClickHouse 与 Hive 的日期差函数和窗口帧语法差异极大,不报方言几乎必报错。
- 强制要求用 CTE(
WITH ... AS)分层拆解,严禁写三层套娃子查询:把「数据去重与分区过滤 -> 窗口标记 -> 最终聚合指标」拆成命名清晰的 CTE,出错时一眼就能定位到哪一层算偏了。 - 写留存与漏斗必须提前锁死 3 个业务口径:单日多次事件是否按
(user_id, dt)去重、漏斗是否要求严格按时间先后且限定时间窗(如 24 小时内)、无交易日滑动窗口是用ROWS按行数还是先补齐日期维度。 - 让 ChatGPT 在内置 Python 沙盒里用 SQLite 造 15 行极端测试数据自跑一遍:包含同秒并发订单、单日重复登录、跳过中间步骤的脏数据,能把隐藏口径 Bug 提前拦在上线之前。
- 复杂多表口径推导、慢 SQL 执行计划诊断以及内置沙盒造数验算对高阶推理配额消耗较明显:免费轻量模型在边界逻辑上更容易遗漏,国内无外币卡用户可通过本站 ChatGPT Plus 自助充值 或 ChatGPT Plus 会员直充 获得更稳定的高阶代码分析体验。
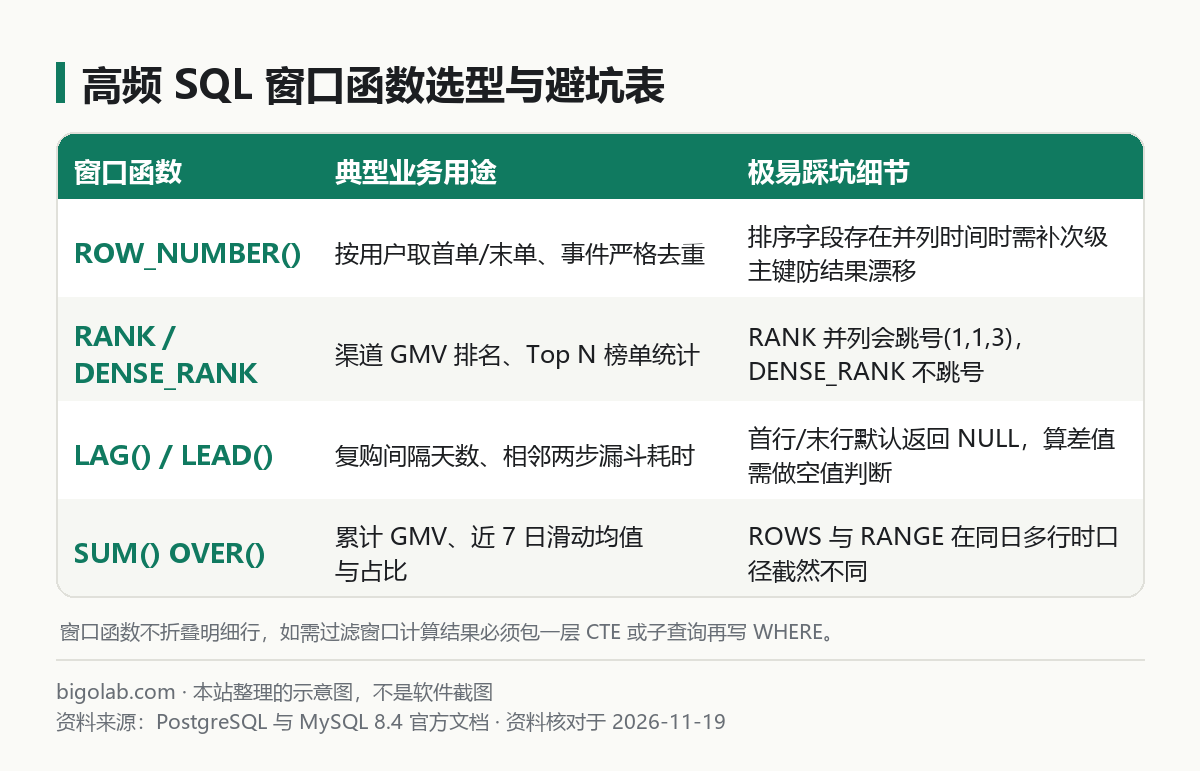
图:本站根据 PostgreSQL 官方文档 与 MySQL 8.4 手册 整理的示意图
本文根据 PostgreSQL 官方文档《Window Functions》、MySQL 8.4 参考手册《Window Functions》及 OpenAI 帮助中心《Data analysis with ChatGPT》整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 数据分析师、产品经理与增长运营,日常要拉取次日/7 日留存、连续活跃天数、复购时间间隔与多步有序转化漏斗,但写嵌套
OVER(PARTITION BY ...)常常晕头转向的人; - 后端研发与 BI 工程师,希望把又慢又长的多层
SELF JOIN子查询重构成清晰可读、易维护且对索引友好的 CTE + 窗口函数查询的人; - 曾经让 ChatGPT 直接写复杂 SQL,结果跑出来「MySQL 不支持该日期函数」「留存率超过 100%」或「漏斗没限制步骤先后顺序」的实战用户。
一、实战场景一:用 MIN OVER 与 LAG 算精准留存与复购间隔
如果是零基础了解建表和基础查询,可先看 用 ChatGPT 写 SQL 与解释报错教程。而在增长分析里,最容易算错的就是「同一天多次活跃导致分子虚高」以及「用注册表还是用首次行为算 Cohort 队列」。直接套用下面这套提示词:
text
请用【填写方言,如:PostgreSQL 16 / MySQL 8.4】编写一段清晰、可直接用于生产的 CTE 窗口函数 SQL。

表结构(已脱敏):
- `user_events`:`user_id` (BIGINT), `event_name` (VARCHAR), `event_time` (TIMESTAMP), `channel` (VARCHAR)
- 常见数据特点:同一用户在一天内可能多次触发 `app_open` 和 `pay_success`;表已按 `event_time` 建索引

业务需求:
1. 统计最近 30 天内,按用户「首次激活日期(`first_date`)」分组的新增 Cohort 队列规模,以及次日(D1)、7 日(D7)、30 日(D30)留存人数与留存率(保留 2 位小数);
2. 另写一段基于 `LAG()` 窗口函数的查询,统计每位付费用户在相邻两笔 `pay_success` 订单之间的复购间隔天数(按时间升序,同一时间戳以 `order_id` 兜底排序),并输出中位数与各间隔区间的分布;
3. 强制要求:
   - 第一层 CTE 先按 `(user_id, DATE(event_time))` 去重,杜绝留存率超过 100%;
   - 对未满 7 天或未满 30 天的近期队列在结果中标注 `NULL` 而非误显示 `0%`;
   - 最后使用内置 Python(sqlite3)构造 12 行含同日多登录、未复购与跨月边界的测试数据跑一遍,给出预期结果核对表。
通过把「未满观察期标 NULL」和「同日去重」提前写进约束,拿到的 SQL 质量能直接达到资深数据分析师水准。提醒一句:涉及真实生产业务表时只贴脱敏 DDL 与模拟样例,不要上传真实用户明细,隐私配置见 ChatGPT 隐私设置与数据控制说明。
额度与订阅提示:连续让模型推导多层 CTE、在 Python 沙盒里造边界测试数据并逐行优化EXPLAIN慢查询,很容易触及免费账户的高阶模型限制。国内无外币卡用户可通过本站 ChatGPT Plus 充值指南 或免交密码的 ChatGPT Plus 卡密兑换 提升日常分析配额;每天深度写复杂数仓 SQL 与大数据脚本的重度工程师也可对比升级 ChatGPT Pro 充值方案(档位对比见 ChatGPT Plus 和 Pro 区别)。
二、实战场景二:用 LEAD / RANK 与 SUM OVER 做严格有序漏斗和滑动汇总
普通 GROUP BY 统计漏斗最大的漏洞是「不管步骤先后」——用户先误点支付失败页再回头看商品详情,也会被算进转化。利用窗口函数做「时间有序 + 窗口限定」漏斗及累计趋势统计,复制下面这段指令:
text
数据库方言:【例如:MySQL 8.4 / PostgreSQL 16】
数据表 `funnel_events` 字段:`user_id`, `session_id`, `event_name`(含 `view_item`、`add_cart`、`submit_order`、`pay_success`), `event_ts` (TIMESTAMP), `amount` (DECIMAL)。

请分两段 CTE 窗口函数查询帮我实现:
任务 A(严格有序 24 小时转化漏斗):
- 仅统计先发生 `view_item`,且在首次浏览后的 24 小时内依次发生 `add_cart` -> `submit_order` -> `pay_success` 的去重用户数与步间转化率;
- 若用户跳步直接触发后端回调事件,不得计入完整转化链路;请用条件聚合或 `MIN() OVER` / 窗口标记写出无自连接爆炸风险的高效方案。

任务 B(按渠道的累计销售额与近 7 日滑动均值):
- 先按 `(channel, dt)` 汇总日销售额,再用 `SUM() OVER(PARTITION BY channel ORDER BY dt ROWS BETWEEN 6 PRECEDING AND CURRENT ROW)` 计算近 7 日滚动总额与累计占比;
- 请用 `DENSE_RANK()` 标记每日各渠道销售额排名,并明确提醒我:如果某个渠道某天零订单缺行,`ROWS BETWEEN 6 PRECEDING` 会产生什么偏差、该如何先关联日期维度表补零。
拿到脚本后,可以先在 ChatGPT 代码沙盒里验证逻辑(方法见 用 ChatGPT 写代码与运行报错排查),跑通后再将结果导出做可视化(见 ChatGPT 分析 Excel 数据实战)。
三、慢查询排障:把 EXPLAIN 执行计划贴给 ChatGPT 降耗时
窗口函数虽然语法优雅,但如果 PARTITION BY 和 ORDER BY 没命中合适索引,在千万行大表上很容易触发大规模磁盘排序(Using filesort 或 External Merge Sort)。直接把脱敏后的 EXPLAIN ANALYZE 文本贴给 ChatGPT,附上指令:
text
下面这条窗口函数 SQL 在 3000 万行订单表上跑了 42 秒。这是脱敏后的 `EXPLAIN ANALYZE` 输出与现有索引列表:
[粘贴执行计划与索引定义]

请帮我:
1. 指出耗时最高的前两个算子(如全表扫描、磁盘排序、窗口分区下推失败);
2. 给出精确的联合索引设计建议(列顺序严格对齐 WHERE 等值列 -> PARTITION BY 列 -> ORDER BY 列);
3. 重写一版先做分区时间裁剪、把过滤条件尽量前移到最内层 CTE 的优化后 SQL。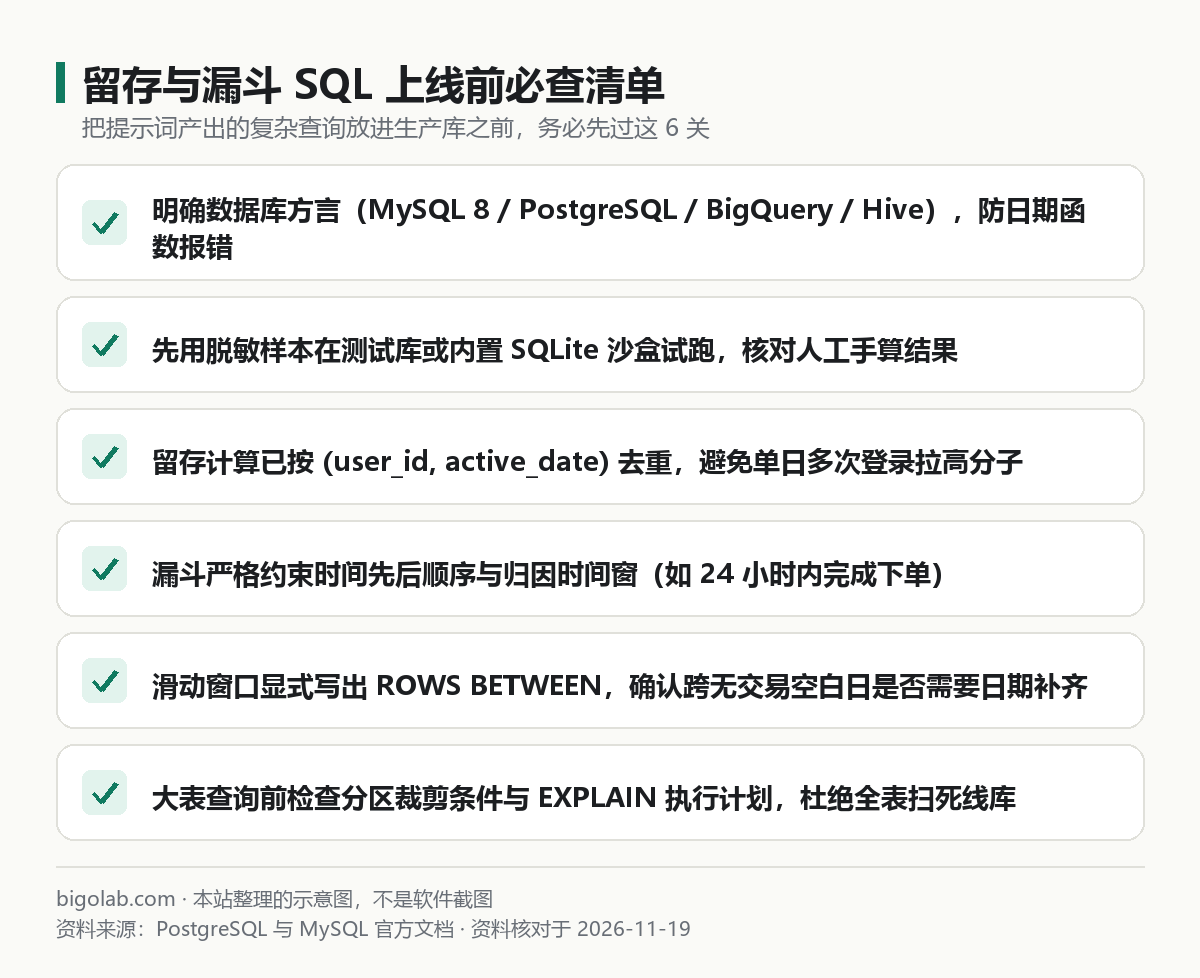
图:本站根据 PostgreSQL 官方文档 与 MySQL 8.4 手册 整理的示意图
常见问题
问:为什么把窗口函数直接写在 WHERE ROW_NUMBER() OVER(...) = 1 里数据库会报错?
答:根据标准 SQL 执行顺序,WHERE 子句在窗口函数计算之前执行,所以 PostgreSQL、MySQL 等数据库禁止在 WHERE 里直接引用窗口函数(少数数仓如 Snowflake / BigQuery / DuckDB 支持专属 QUALIFY 语法)。通用写法是把窗口计算放进上层 CTE,再在外层用 WHERE rn = 1 过滤。
问:ROWS BETWEEN 和 RANGE BETWEEN 到底差在哪,为什么有时候算出不一样的数字?
答:ROWS 严格按物理行数往前数(比如往前 6 行),而 RANGE 按排序字段的数值或时间范围计算。如果同一天存在多条记录或日期排序有并列值,RANGE 会把所有并列行打包一起算,而 ROWS 只截断固定行数。在提示词里显式写明「按日先聚合去重,再使用 ROWS 或时间间隔 RANGE」能彻底消除歧义。
问:公司用的还是老版本 MySQL 5.7,不支持窗口函数怎么办?
答:在提示词开头明确写「运行环境为 MySQL 5.7,不支持 OVER() 窗口函数」,ChatGPT 会自动改写为用户变量(@prev_user / @rn)或受控关联子查询兼容方案,并同步提示升级数据库版本的注意事项。
问:国内没有外币卡,怎么稳定开通 ChatGPT Plus / Pro 或团队版以解锁多文件上传与高阶模型?
答:可通过本站 AI 会员充值总览 进入 ChatGPT Plus 充值页 获得充足的高阶推理与 Python/SQLite 沙盒验算额度;对于高频编写复杂数仓 SQL 与多模型工程分析的重度用户,可直接选购 ChatGPT Pro 会员直充,数据团队多人协同且强调数据不参与训练建议升级 ChatGPT Business 团队版。支持支付宝、微信支付及 AlipayHK。实时价格以页面展示为准;订阅期内若掉订阅按剩余天数折退,因违反官方条款导致的封号不在质保范围内。
相关教程
- 用 ChatGPT 写 SQL:描述表结构生成查询、解释报错和优化慢查询,先在测试库跑再上线
- 用 ChatGPT 写代码怎么用:代码块的复制、编辑、预览、运行 Python,报错了怎么办
- ChatGPT 分析 Excel 数据:上传表格、清洗、透视与出图(附可复制提问)
- ChatGPT 隐私设置:怎么关闭「改进模型」训练、数据控制与隐私中心
- ChatGPT Plus 和 Pro 有什么区别:Pro 100、200、500 三档怎么选
参考资料
- PostgreSQL 官方文档:Tutorial — Window Functions — https://www.postgresql.org/docs/current/tutorial-window.html
- MySQL 8.4 Reference Manual:Window Functions — https://dev.mysql.com/doc/refman/8.4/en/window-functions.html
- OpenAI 帮助中心:Data analysis with ChatGPT — https://help.openai.com/en/articles/8437071-data-analysis-with-chatgpt
0 条评论
还没有评论,来抢沙发~