
结论先说
- 主力文本向量模型是
gemini-embedding-001:通过client.models.embed_content调用,contents既能传单条字符串,也能传字符串列表一次生成多条向量。 - 做 RAG 检索时,入库和查询必须分设不同的
task_type:文档切片入库时设RETRIEVAL_DOCUMENT,用户搜问题时设RETRIEVAL_QUERY,专门对齐非对称检索空间。 - 支持用
output_dimensionality按需裁剪维度:默认输出3072维,官方推荐的轻量化档位是1536或768,能大幅减少向量库存储和检索内存占用。 - 裁剪维度后必须手动补一步
L2 归一化:官方明确提醒,默认3072维返回时已是单位向量,但缩减到低维后的子向量不再保持模长为 1,算点积或余弦相似度前要先归一化。 - 谷歌账号准备与多工具订阅入口:使用 Gemini、Google AI Studio 与 Antigravity 需具备符合地区与年龄要求的个人谷歌账号,缺号可查看本站 谷歌账号购买说明(含带 2FA 的 谷歌邮箱成品号),跨平台付费订阅总览见 AI 会员充值中心。
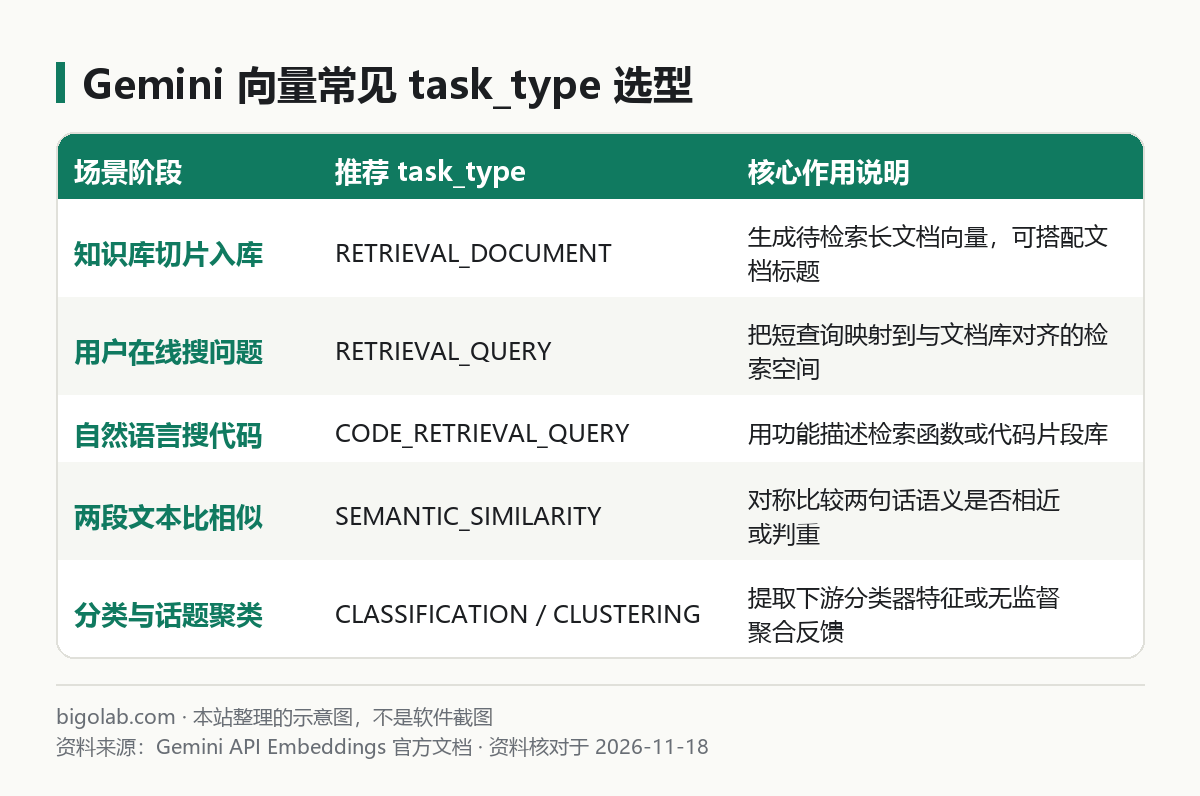
图:本站根据 Gemini API 官方文档:Embeddings 整理的示意图
本文根据 Google AI for Developers 官方文档《Embeddings》《Gemini Developer API pricing》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Google 官方网站。
适用于谁
- 准备用 Gemini API 给本地 Markdown、PDF、客服问答库做向量化入库(RAG)的开发者;
- 搜「gemini embedding api」,想知道
task_type该填哪一个、文档入库和用户提问为什么要填不同值的人; - 向量数据库(如 pgvector、Milvus、Qdrant)嫌
3072维太占内存或受索引上限限制,想安全缩减到768或1536维的人。
一、基础调用:单条与多条文本一次转向量
先确认本地已装好 google-genai 并配好环境变量 GEMINI_API_KEY(未配置见 Gemini API Key 申请与配置教程)。调用 embed_content 把多段文本转成浮点数向量只需几行代码:
python
from google import genai
from google.genai import types

client = genai.Client()

result = client.models.embed_content(
    model="gemini-embedding-001",
    contents=[
        "支持七天无理由退货,拆封后需保留完整原包装。",
        "工作日 16:00 前下单当天发出,默认发顺丰快递。",
    ],
    config=types.EmbedContentConfig(
        task_type="RETRIEVAL_DOCUMENT",
        output_dimensionality=768,
    ),
)

for idx, emb in enumerate(result.embeddings):
print(f"第 {idx + 1} 条向量维度:{len(emb.values)},前 4 维:{emb.values[:4]}")如果有几十万条历史文档要离线建库,还可以走官方批量向量异步接口(client.batches.create_embeddings)享标准价五折优惠,速率限制与计费口径见 Gemini API 免费额度与限速说明 与 Gemini API 价格说明。
二、task_type 八种任务类型怎么选(别全用默认)
在 RAG 知识库场景里,用户问的是短短一句「怎么退货」,库里存的是几百字的售后规则——两者长度和语体不对等。指定任务类型能让模型把向量投影到最适合该下游任务的子空间:
task_type 参数值 | 适用场景 | 配套用法说明 |
|---|---|---|
RETRIEVAL_DOCUMENT | 知识库文档入库 | 给待检索的文章段落生成向量,可配合 title 传标题 |
RETRIEVAL_QUERY | 用户搜索词向量化 | 在线检索时把用户的提问转成向量,匹配 RETRIEVAL_DOCUMENT |
CODE_RETRIEVAL_QUERY | 自然语言搜代码 | 输入功能描述,去代码片段库里检索对应函数 |
QUESTION_ANSWERING | 标准问答对匹配 | 问题侧用此类型,答案段落侧搭配 RETRIEVAL_DOCUMENT |
FACT_VERIFICATION | 事实核查找证据 | 待核实的陈述句用此类型,去语料库里找支撑原文 |
SEMANTIC_SIMILARITY | 两段话语义判重 | 对称比较两句话意思是否相近,两边填同一个类型 |
CLASSIFICATION | 文本分类特征 | 把向量喂给下游分类器识别工单类别或情绪标签 |
CLUSTERING | 无监督话题聚类 | 把大批用户反馈自动聚成若干热点主题簇 |
一句话记忆:对称比相似用 SEMANTIC_SIMILARITY;短问题搜长文档,存用 RETRIEVAL_DOCUMENT,查用 RETRIEVAL_QUERY。横向对比 OpenAI 同类模型见 OpenAI Embeddings 向量使用教程。
三、维度裁剪(MRL)与必做的 L2 归一化代码
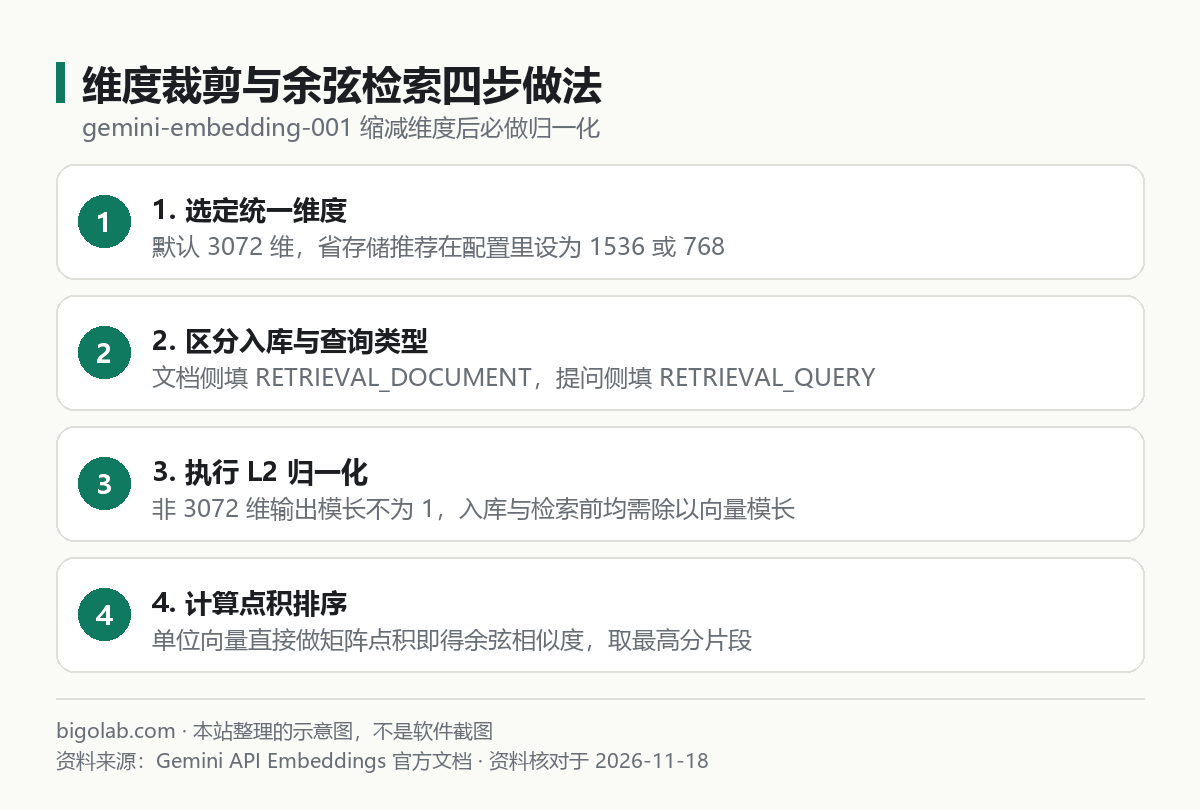
图:本站根据 Gemini API 官方文档:Embeddings 整理的示意图
gemini-embedding-001 采用套娃表示学习(MRL)训练,最重要特征集中在最前面的维度。通过 output_dimensionality 把默认的 3072 维截断成 1536 或 768 维时,无需重训模型即可把存储压降一半到四分之三,也兼容部分向量索引的 2000 维上限。
注意一个关键数学细节:官方说明 3072 维完整向量出厂已是单位向量,直接点积等于余弦相似度;但裁剪成 768 或 1536 维后模长不再等于 1。入库和检索前请务必补做 L2 归一化:
python
import numpy as np
from google import genai
from google.genai import types

client = genai.Client()

def l2_normalize(vec: list[float]) -> np.ndarray:
    arr = np.array(vec, dtype=np.float32)
    norm = np.linalg.norm(arr)
    return arr / norm if norm > 0 else arr

docs = ["退款会在审核通过后 1 至 3 个工作日原路退回。", "修改收货地址请在发货前联系在线客服。"]
doc_res = client.models.embed_content(
    model="gemini-embedding-001",
    contents=docs,
    config=types.EmbedContentConfig(task_type="RETRIEVAL_DOCUMENT", output_dimensionality=768),
)
doc_matrix = np.vstack([l2_normalize(e.values) for e in doc_res.embeddings])

query_res = client.models.embed_content(
    model="gemini-embedding-001",
    contents="申请退钱之后多久能到账?",
    config=types.EmbedContentConfig(task_type="RETRIEVAL_QUERY", output_dimensionality=768),
)
scores = doc_matrix @ l2_normalize(query_res.embeddings[0].values)
best_idx = int(np.argmax(scores))
print(f"最匹配文档:{docs[best_idx]}(相似度:{scores[best_idx]:.4f})")
若准备海外开发环境时需要独立 Google 账号开通 AI Studio 和 API 项目,可查看本站 谷歌账号购买说明 或浏览 充值服务总览。
常见问题
问:能不能入库时存 768 维,查询时忘记传维度用默认 3072 维去搜?
答:不能。维度不一致在任何向量数据库里都会直接报错,建库与在线检索必须锁定同一个模型名称和同一个维度数字。
问:升级向量模型后需要重跑全库索引吗?
答:必须全量重新生成向量(Re-index)。不同模型的向量空间互不相通,即便把维度裁成一样的数字,算出的余弦距离也没有意义。
问:单条文本最长能塞多少字进去转向量?
答:向量模型的单条输入上限(数千 token 级)远小于对话模型的百万窗口,以官方 Models 页标注为准。长文档建议按 300 至 800 字做语义分块(Chunking)效果更稳。
问:没有可用的个人谷歌账号,或者同时想开其他主流 AI 会员怎么办?
答:本站提供即买即发的 谷歌邮箱成品号(登录方法见 谷歌账号购买页),同时支持支付宝、微信支付与 AlipayHK 自助充值 ChatGPT Plus、Claude Code 等主流服务,实时价格与质保细则以各商品页说明为准。
相关教程
- Gemini API Python 调用教程:安装 google-genai SDK 与基础请求
- Gemini API 免费额度是多少:免费层级、RPM / TPM 速率限制查询
- Gemini API 价格:各模型每百万 tokens 计费标准速查
- OpenAI Embeddings 向量怎么用:dimensions 缩短与余弦相似度搜索对比
参考资料
- Gemini API 官方文档:Embeddings — https://ai.google.dev/gemini-api/docs/embeddings
- Gemini Developer API pricing — https://ai.google.dev/gemini-api/docs/pricing
0 条评论
还没有评论,来抢沙发~