
结论先说
- 完全不依赖 LangChain 框架也能独立使用:只要安装极轻量的
langsmithSDK,用一行wrap_openai或wrap_anthropic加上@traceable装饰器,就能把纯原生 Python / TypeScript 代码的完整调用树上报到控制台。 - LangGraph 与 LangChain 项目真正零改代码:只需在环境变量里设好
LANGSMITH_TRACING=true与LANGSMITH_API_KEY,所有图节点流转、条件边跳转与工具返回会自动串成嵌套火焰图。 - 自动折算 Token 成本与缓存明细:控制台会按模型公开单价自动统计输入、输出及提示词缓存命中 Token,哪一步烧钱一眼可见(各家单价对照见 AI 大模型 API 官方价格对比)。
- 个人 Developer 档自带月度免费额度:注册即送单人工作区与月度免费基础 Trace 配额(超额前适合个人开发联调,默认留存期较短),日志异步后台上报不阻塞主业务响应。
- AI 编程工具与会员充值入口:日常编写与调试智能体代码若需搭配高配额终端助手,可在本站免外币卡开通 Claude Code 订阅 或 ChatGPT Plus,更多开发者订阅见 AI 会员充值中心。
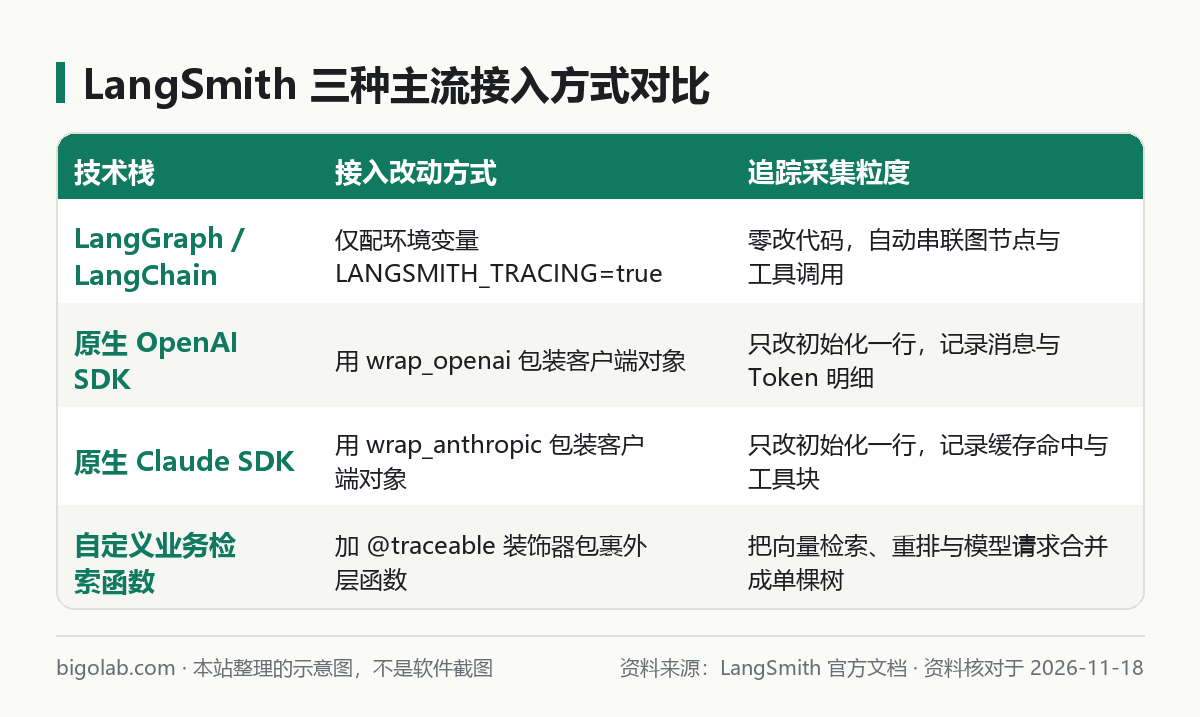
图:本站根据 LangSmith 官方文档:Trace with LangSmith 整理的示意图
本文根据 LangSmith 官方文档与 LangChain 官方定价页整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 LangChain 官方网站。
适用于谁
- 用 LangGraph 或原生 OpenAI、Anthropic SDK 写多步智能体,遇到工具死循环或回答跑偏却没法看中间拼接提示词的开发者;
- 想在后台直观看到每次问答的首字延迟(TTFT)、各子节点耗时占比与缓存命中 Token 成本的团队;
- 想弄清不用 LangChain 框架能不能单独用 LangSmith,以及个人免费版够不够日常调试的人。
一、三步完成初始化:拿密钥与配环境变量
如果你是第一次申请大模型接口密钥,可先参考 大模型 API 从申请 Key 到首次调用入门。接入 LangSmith 只需三步准备:
- 生成 API Key:登录
https://smith.langchain.com(支持 GitHub 或 Google 账号登录),点击左下角齿轮图标进入 Settings > API Keys > Create API Key,选择 Personal Access Token 并复制保存lsv2_pt_...开头的密钥。 - 安装依赖包:在虚拟环境中执行
pip install -U langsmith openai anthropic。 - 写入三项核心环境变量(新版官方统一使用
LANGSMITH_*前缀,同时向下兼容旧版LANGCHAIN_TRACING_V2):
bash
export LANGSMITH_TRACING="true"
export LANGSMITH_API_KEY="lsv2_pt_你的真实密钥"
export LANGSMITH_PROJECT="rag-agent-dev"   # 不填默认归入 default 项目
如果你的工程基于 LangGraph 或 LangChain 构建,配完上面三行环境变量直接运行原有脚本,打开网页后台就能看到完整节点拓扑与状态变更,一行 Python 代码都不用动。
二、原生 OpenAI / Claude 接口怎么加嵌套追踪
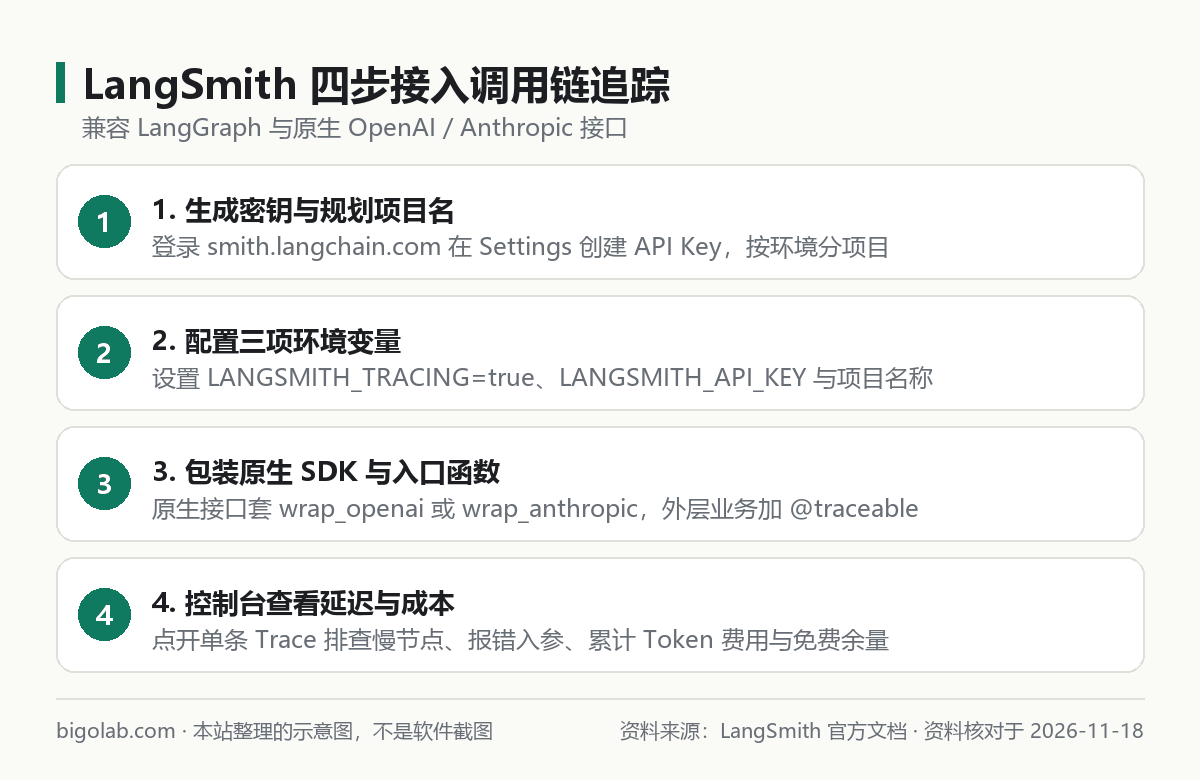
图:本站根据 LangSmith 官方文档 整理的示意图
很多生产项目嫌重没有引 LangChain,而是直接调官方 openai 或 anthropic SDK。此时把 客户端包装器(Wrappers) 与 @traceable 装饰器 组合起来效果最好:外层函数加 @traceable 建立父根节点,内部多次向量检索、重排和大模型请求就会自动收纳在同一条 Trace 树下,而不是散成几条孤立记录:
python
from openai import OpenAI
from anthropic import Anthropic
from langsmith import traceable
from langsmith.wrappers import wrap_openai, wrap_anthropic

# 包装原生客户端,后续所有调用自动记录模型参数、耗时与 Token
oai_client = wrap_openai(OpenAI())
claude_client = wrap_anthropic(Anthropic())

@traceable(run_type="retriever", name="vector_search")
def retrieve_docs(query: str) -> list[str]:
    return ["退换货规则:签收 7 天内未拆封支持无理由退货。"]

@traceable(name="customer_qa_pipeline", metadata={"env": "staging"})
def answer_question(user_query: str) -> str:
    docs = retrieve_docs(user_query)
    resp = claude_client.messages.create(
        model="claude-sonnet-4-5",
        max_tokens=512,
        messages=[{"role": "user", "content": f"依据:{docs}\n问题:{user_query}"}],
    )
    return resp.content[0].text

print(answer_question("拆封了还能退货吗?"))
运行后点开 rag-agent-dev 项目里的这条记录,左侧会清晰展示父节点 customer_qa_pipeline 下挂着 vector_search(绿色检索图标)与 Messages(大模型图标),右侧能直接检查提示词缓存是否命中。关于两家前缀缓存的触发门槛,可对照 OpenAI API 提示词缓存教程 与 Claude 提示词缓存入门。
订阅与账号准备提示:开发阶段除了用 API 跑追踪流水线,日常写业务逻辑与排查慢链路强烈建议交给高频编程订阅承担,省去心疼按量 API 账单;国内开发者可在本站免外币卡开通 Claude Pro 或 ChatGPT Plus。
三、免费层(Developer)限额、数据脱敏与采样控制
上线前务必了解官方计费与隐私控制边界:
| 关注维度 | 官方规则说明(以定价页当天为准) | 工程配置建议 |
|---|---|---|
| Developer 免费层限额 | 面向单人开发者免费开放,含每月固定免费基础 Trace 配额(常见为 5,000 条/月),数据默认保留 14 天 | 本地开发与小流量验证够用;多人协作或需 400 天长留存再升级 Plus 档 |
| 开启追踪对接口延迟的影响 | SDK 采用后台异步线程批量打包发送日志,不阻塞主请求返回 | Serverless(如 AWS Lambda / Vercel)环境退出前需开 LANGSMITH_TRACING_BACKGROUND=false 或调 flush 防丢包 |
| 生产高并发采样与脱敏 | 支持设 LANGSMITH_TRACING_SAMPLING_RATE=0.1(仅采 10% 流量),支持注册匿名化函数遮蔽手机号密钥 | 严禁在内网严监管金融医疗场景裸传明文隐私字段;必须不出内网请改用自建开源方案 |
常见问题
问:配好了环境变量,为什么网页控制台里一条记录都没有?
答:按顺序核查三处:第一,LANGSMITH_TRACING 字符串是否拼成了纯小写 "true";第二,若账号建在欧盟区(eu.smith.langchain.com),必须额外配置 LANGSMITH_ENDPOINT="https://eu.api.smith.langchain.com";第三,短生命周期脚本刚跑完进程就退出导致后台队列没来得及发完,可在脚本末尾调用 langsmith.Client().flush() 验证。
问:一条复杂的 LangGraph 对话跑了 8 个节点,算 1 条 Trace 还是 8 条?
答:按 LangSmith 官方计费口径,一次完整顶层调用树算作 1 条根 Trace(内部包含多个子 Run / Span),这也是为什么要用 @traceable 把同一次用户请求包在一个根节点下,既清晰又省免费配额。
问:公司要求所有提问日志绝不能发往外部 SaaS 云端怎么办?
答:LangSmith 自托管版仅面向 Enterprise 企业商业合同开放;中小团队若要求零授权费在自己服务器用 Docker 私有化部署可观测平台,直接选用 MIT/开源自托管方案(如 Langfuse)更合适。
问:人在国内没有境外信用卡,怎么开通 Claude 或 ChatGPT 会员辅助写代码?
答:可在本站 AI 会员充值中心 自助选购 Claude Pro 免上号卡密 或 ChatGPT Plus 充值服务(无需交出账号密码),支持支付宝、微信支付与 AlipayHK 付款并可开具增值税发票;实时价格与售后边界(掉订阅按剩余天数折退,封号不在质保范围)以商品页展示为准。
相关教程
- 大模型 API 怎么用:从申请 Key 到第一次调用,OpenAI、Claude、Gemini 通用入门
- AI 大模型 API 价格对比:OpenAI、Anthropic、Google、xAI、DeepSeek 官方价格页速查
- OpenAI API 提示词缓存(Prompt Caching)怎么用:1024 token 门槛与命中排查
- Claude 提示词缓存(Prompt Caching)入门:缓存时间、价格倍率与命中率
参考资料
- LangSmith 官方文档:Trace with LangSmith — https://docs.smith.langchain.com/observability/how_to_guides/trace_with_langsmith
- LangSmith 官方文档首页 — https://docs.smith.langchain.com/
- LangChain & LangSmith 官方定价页 — https://www.langchain.com/pricing
0 条评论
还没有评论,来抢沙发~