
结论先说
- 默认自动开启,无需手动打断点:在支持的模型上,OpenAI 会自动对请求开头的相同前缀做精确匹配缓存,命中缓存本身不收额外的写入费。
- 硬门槛是共同前缀满 1024 token:短于 1024 token 的提示词不会触发缓存;达到 1024 token 后,按 128 token 为步长递增计算命中长度。
- 省钱且降延迟:官方数据显示缓存命中最高可降低 80% 首字延迟(TTFT),缓存输入单价相比普通输入最高可省 90%–95%(视具体型号而定)。
- 用
prompt_cache_key提升路由命中率:传入稳定的会话或业务标识字符串,可帮助网关把共享相同前缀的请求路由到同一批缓存实例。 - 排查只看
cached_tokens:Responses API 看usage.input_tokens_details.cached_tokens,为0时优先查长度是否够 1024、开头是否混入了时间戳等动态文本。 - 国内免境外卡开通入口:若没有境外银行卡或遇到支付被拒,可在本站通过支付宝、微信支付或 AlipayHK 自助获取兑换码开通 ChatGPT Plus 或 ChatGPT Pro,团队多席位支持联系客服定制 ChatGPT Business 团队版。
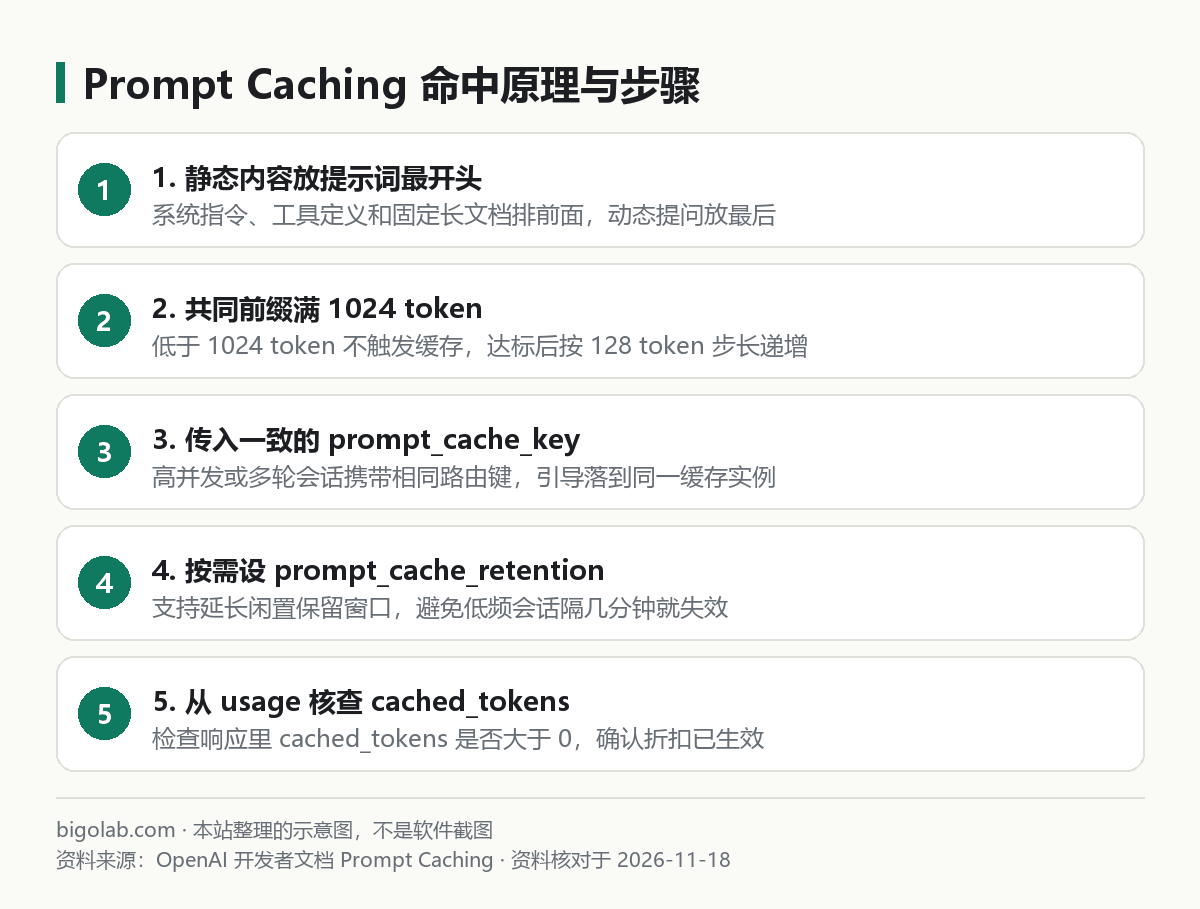
图:本站根据 OpenAI 开发者文档:Prompt Caching 整理的示意图
本文根据 OpenAI 开发者文档《Prompt Caching》《Counting tokens》与官方 API 价格页整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 每次调用 OpenAI API 都要塞入长系统指令、固定业务文档或几十个工具定义,希望大幅压低输入成本与首字延迟的开发者;
- 发现响应
usage里的cached_tokens一直显示为0,想知道卡在哪条规则上的人; - 想搞清 OpenAI 自动缓存与
prompt_cache_key、prompt_cache_retention参数怎么配合的人。
一、工作原理、1024 token 门槛与省费比例
OpenAI 的提示词缓存采用严格前缀匹配(Exact prefix matching):系统从整个请求的最开头第 1 个 token 往后比对,包括顶层 instructions(或系统消息)、tools 工具列表、历史消息以及图片等输入。只要开头有一段连续完全一致的内容且达到 1024 token,后续请求复用这段前缀时就直接跳过预填充计算。
递增规则很直观:满 1024 token 先缓存 1024,之后每多出整 128 token(1152、1280、1408……)再往上扩一格,不足一个步长的尾部按普通输入计费。发请求前不确定前缀够不够 1024,可调用官方计数接口精确测算,方法见 /guides/openai-api-token-count-estimate。
在计费上,OpenAI 不收缓存创建或存储附加费(这与 Anthropic 显式缓存收写入倍率不同,对比见 /guides/claude-prompt-caching)。按官方 API 价格表,主力模型的缓存折扣非常可观:例如 gpt-6-astra 标准输入每百万 token 为 $10.00、缓存输入仅 $1.00(打 1 折);gpt-6.1-sol 标准输入 $2.00、缓存输入 $0.10(省 95%)。完整型号单价表见 /guides/openai-api-price-official-table。注意 API 账单与个人网页会员分开结算,日常网页问答或用 Codex 订 ChatGPT Plus 即可,两者区别见 /guides/chatgpt-subscription-vs-openai-api。
二、代码怎么写:固定前缀、prompt_cache_key 与保留策略
想拿到稳定的高命中率,写请求时遵循「静态全放前、动态全放后」即可,并配合 prompt_cache_key 做实例路由:
python
from openai import OpenAI

client = OpenAI()

# 静态长背景与规则(确保连同 tools 一起超过 1024 tokens)
LONG_SYSTEM_SPEC = "你是企业财务合规审核助手……(此处省略超过 1024 tokens 的固定制度全文)"

response = client.responses.create(
    model="gpt-6.1-sol",  # 以官方价格页与模型页当前可用型号为准
    instructions=LONG_SYSTEM_SPEC,
    prompt_cache_key="finance-audit-v1",  # 相同前缀业务传一致的 key 提高路由命中率
    input=[
        {"role": "user", "content": "请核查这份报销单摘要是否符合差旅标准:……"}
    ],
)

print("总输入 token:", response.usage.input_tokens)
print("命中缓存 token:", response.usage.input_tokens_details.cached_tokens)
两个实用控制参数:
prompt_cache_key:当你的应用并发很高时,请求可能被分发到多台不同后端机器导致缓存分散。给共用同一套系统指令或同一用户线程的请求传相同的prompt_cache_key(注意单个 key 每分钟请求量不要极端集中过载,可按租户或业务线分桶),能显著提高命中率。- 保留时间与
prompt_cache_retention:默认内存缓存通常在闲置 5–10 分钟后自动淘汰(低峰期偶有延长)。在支持扩展缓存保留的模型与接口上,可配置prompt_cache_retention(例如内存级"in_memory"或长保留窗口"24h",具体枚举取值以所用模型的最新 API 参考为准),适合间隔几十分钟才继续说话的异步智能体。Responses API 基础结构见 /guides/openai-responses-api。
本站订阅与团队开通提示:如果你在国内遇到银行卡被拒或急需提升对话与推理配额,可前往本站 ChatGPT Plus 充值说明页 或 ChatGPT Pro 5x/20x 充值页 自助获取卡密完成开通(全程无需交出账号密码,可开增值税发票);企业多成员协作可直接查看 ChatGPT Business 团队定制方案。
三、怎么看有没有命中、为什么 cached_tokens 总是 0
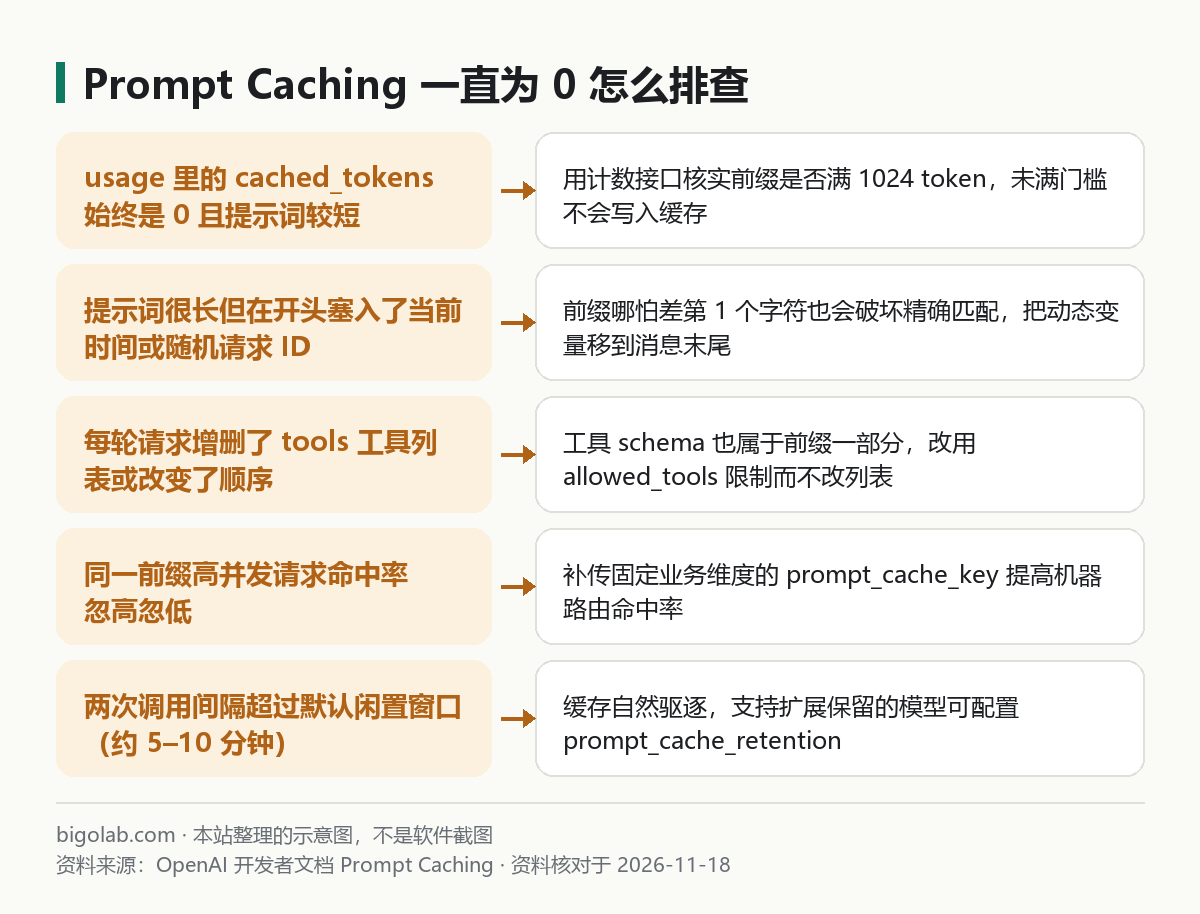
图:本站根据 OpenAI 开发者文档:Prompt Caching 整理的示意图
每次调用返回后,直接检查响应里的 usage 对象:
- Responses API:读
response.usage.input_tokens_details.cached_tokens; - Chat Completions API:读
completion.usage.prompt_tokens_details.cached_tokens。
如果连续发两次请求,cached_tokens 依然是 0,按下面五点逐一核对:
- 前缀不到 1024 token:中英文分词密度不同,几百汉字往往只有几百 token,先凑够 1024 门槛。
- 开头混入了动态变量:最常见的坑是在系统提示词第一行写了
当前时间:2026-11-18 19:30:05或随机用户请求 ID。第 10 个 token 一变,后面 1 万个 token 全军覆没。务必把动态时间、检索出的实时片段放到最后一条用户消息里。 tools列表顺序或增删变动:工具定义位于上下文前部。如果想在某轮禁用部分函数,不要直接删改tools数组,改用tool_choice里的allowed_tools限定可用范围,用法见 /guides/openai-api-function-calling。- 第一次请求刚发完就并发发第二次:缓存需要在首笔请求完成前缀处理后才能写入就绪,紧挨着毫秒级同时发出的请求来不及复用。
- 闲置超时被逐出:两次请求相隔十几分钟以上,内存缓存已被回收,重新热身一次即可恢复。
常见问题
问:开启了零数据保留(ZDR)或 store: false,还能用提示词缓存吗?
答:默认内存级提示词缓存不把用户内容持久化落盘,通常仍可在请求间短暂命中;但依赖持久存储的跨长周期特性请以组织合规协议与官方文档说明为准。
问:缓存命中的 token 还会占用模型的上下文窗口上限和 TPM 速率限制吗?
答:上下文窗口总长度依然按完整输入 token 数计算;至于每分钟 token 速率限制(TPM)各层级如何折算缓存部分,可在控制台 Limits 页查看当前模型说明。
问:图片、音频和结构化输出 Schema 能被缓存吗?
答:可以。只要图片条目(相同的图片内容与 detail 档位)或 text.format 的 JSON Schema 位于不变的共同前缀内,且总前缀满 1024 token,同样计入缓存。
问:国内没有境外信用卡,怎么开通或续费 ChatGPT Plus / Pro?
答:可在本站使用支付宝、微信支付或 AlipayHK 下单获取卡密自助兑换(支持 ChatGPT Plus、Pro 5x 可覆盖档 与 Pro 5x 空白号档),实时价格、兑换前提与售后规则(掉订阅按剩余天数折退,封号不在质保范围)以对应页面说明为准。
相关教程
- OpenAI API 价格是多少:输入、缓存输入与输出价格表
- OpenAI API 的 token 怎么算、怎么估算费用
- OpenAI Responses API 是什么:和 Chat Completions 的区别
- Claude 提示词缓存(Prompt Caching)入门
参考资料
- OpenAI 开发者文档:Prompt Caching — https://developers.openai.com/api/docs/guides/prompt-caching
- OpenAI API 价格页 — https://developers.openai.com/api/docs/pricing
- OpenAI 开发者文档:Counting tokens — https://developers.openai.com/api/docs/guides/token-counting
0 条评论
还没有评论,来抢沙发~