
结论先说
- 快筛与精读应当分工:在 Zotero 内置阅读器装 Translate for Zotero 插件负责摘要与图注的即时划词翻译;确定要精读的核心文献,再把原 PDF 或高亮笔记喂给 Claude / ChatGPT 深挖方法细节。
- 切勿在未脱敏情况下上传未发表审稿件:同行评审(Peer Review)保密稿件或涉密课题数据严禁传给外部商业模型,仅对已公开出版的 arXiv、IEEE、ACM、Nature 等文献使用云端精读。
- 批注转 Markdown 是最省额度的上下文喂法:利用 Zotero 右侧「从批注添加条目笔记(Add Item Note from Annotations)」,只把你标黄的核心段落导出提问,比整本塞入几十页附录更聚焦。
- 参考文献格式一律由 Zotero 本地生成,绝不让 AI 默写引文:只允许大模型基于你实际投喂的真实 PDF 总结观点,正文中插入 BibTeX 或 GB/T 7714 引文全部走 Zotero Word 插件自动生成。
- 长文献多篇对比主力订阅入口:一次性投喂多篇双栏长 PDF 做横向综述极吃上下文窗口,国内无外币卡可在本站自助开通 Claude Pro 或 ChatGPT Plus。
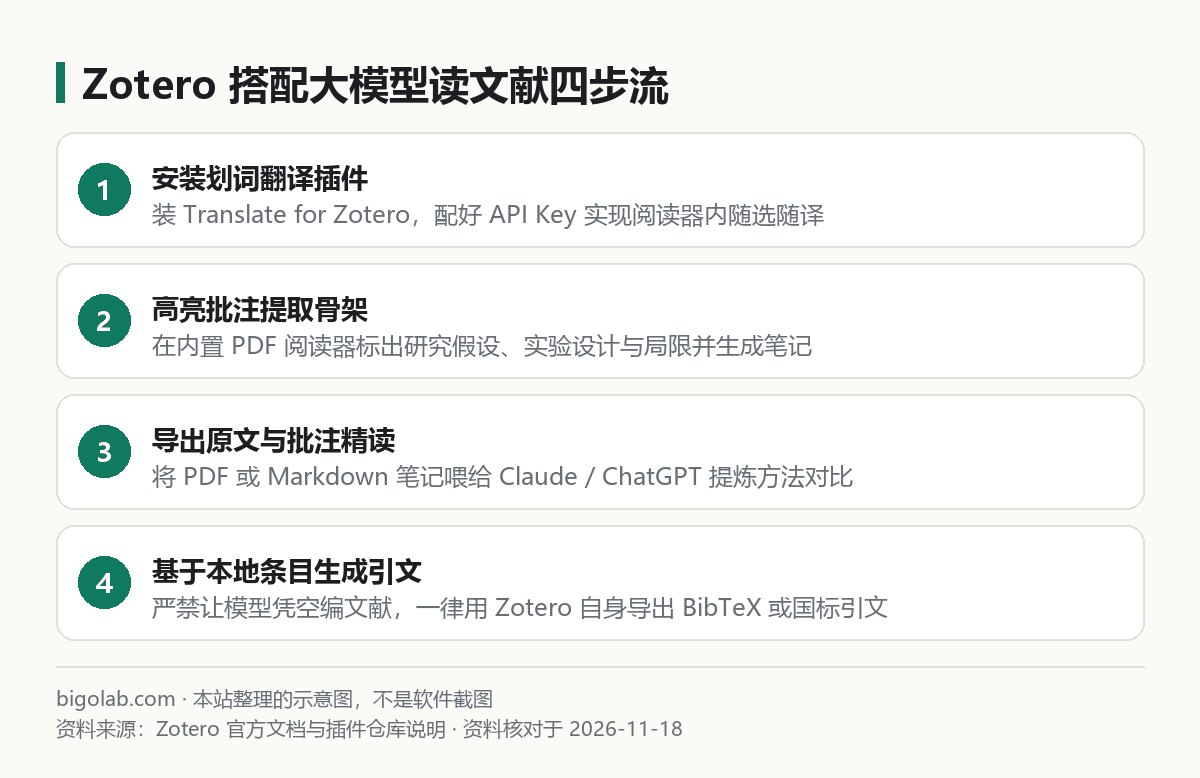
图:本站根据 Zotero 官方文档:PDF Reader and Note Editor 整理的示意图
本文根据 Zotero 官方文档《Zotero PDF Reader and Note Editor》及开源插件 Translate for Zotero 说明整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Zotero、Anthropic 或 OpenAI 官方网站。
适用于谁
- 每天要在 Zotero 里筛读大量英文期刊或顶会 PDF,希望边看边划词翻译专业长难句的研究生与科研人员;
- 想把多篇文献的实验设置、基线指标和研究局限交给 Claude 或 ChatGPT 做横向对比表的人;
- 担心大模型编造不存在的论文标题、假作者或错误 DOI,需要建立合规文献综述流程的写作者。
一、在 Zotero 阅读器配置大模型划词翻译插件
Zotero 7 原生内置了响应很快的标签页 PDF 阅读器,配合开源插件 Translate for Zotero(仓库名 zotero-pdf-translate)即可实现选中英文自动在右侧栏显示专业译文,整篇长文档翻译的通用原则也可参考 AI 翻译 PDF 和长文档完整流程。
配置步骤如下:
- 安装
.xpi插件包:前往 GitHub 仓库 Releases 页面下载最新.xpi文件,打开 Zotero 顶部菜单「工具(Tools)> 插件(Plugins)」,点击右上角齿轮图标选「Install Plugin From File...」导入启用。 - 填入官方大模型翻译源:打开「编辑(Edit)> 设置(Settings)> 翻译(Translate)> 服务(Service)」,选择 OpenAI 或兼容大模型通道,填入你在官方平台申请的 API Key(申请方法见 OpenAI API Key 怎么获取 与 Claude API Key 怎么获取)。
- 选轻量高速模型降延迟:划词翻译每次只发一两句话,不需要昂贵的推理模型,优先填轻量快速档(如
gpt-4o-mini或 Haiku 档),并在系统提示词加上「保留本学科英文专业缩写,在首次出现处用括号附原文」。 - 阅读器内随选随存:双击打开任意 PDF 文献,鼠标框选摘要或图表说明即可在右侧面板看到译文;点击面板上的「添加到批注」还能把双语对照直接存进高亮卡片。
二、导出高亮批注喂给 Claude / ChatGPT 做单篇与多篇精读
筛出值得深读的 3–5 篇核心文献后,不建议只在窄小的侧边栏逐句翻译,而是结合 Zotero 官方批注导出与长窗口网页端(如 Claude Projects 或 ChatGPT Projects)做结构化拆解,完整综述提纲写法见 用 AI 读论文、做文献综述的流程。
- 在 Zotero 提取核心高亮:边看边用不同颜色标记(如黄色标研究痛点、绿色标核心公式与架构、红色标实验局限),点右侧笔记面板加号「Add Item Note from Annotations」,右键该笔记导出为 Markdown。
- 上传原 PDF 或批注笔记发问:将核心 PDF 连同你自己的批注疑问一起上传,复制以下防幻觉精读提示词:
text
请仅严格依据我上传的这几篇论文 PDF 原文回答,禁止引入外部未提及的猜测:
1. 用 Markdown 表格对比各篇的【核心解决问题、输入输出假设、关键创新模块、所用数据集与评估指标】;
2. 每一格结论后必须用括号标注原文所在的【文件名 + 页码 + 章节/图表号】(如 PaperA, p.4, Table 2),方便我回 Zotero 核对;
3. 单独列出作者在 Discussion 或 Limitations 章节承认的适用边界,若原文未写请直接填「原文未说明」。科研课题组与个人长文本订阅提示:连续上传十几篇高密度英文顶会 PDF 极易撞上免费版每日文件与消息配额上限。若国内没有双币信用卡或课题组报销需要正规票据,可前往本站开通 Claude Pro(长文档细节定位与图表解读表现突出)或 ChatGPT Plus,更多套餐与开票说明见 AI 会员充值中心。
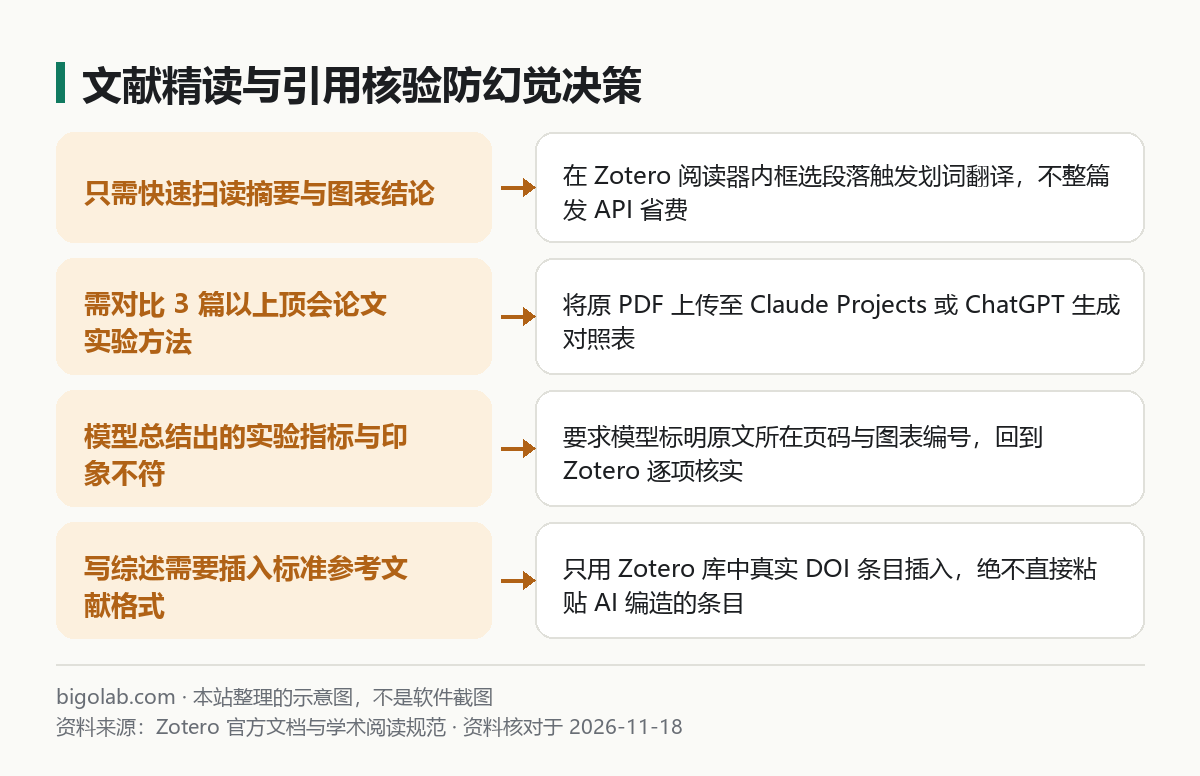
图:本站根据 Zotero 官方文档:PDF Reader and Note Editor 整理的示意图
三、严守学术红线:杜绝 AI 捏造参考文献的三步核验法
直接对大模型说「帮我推荐 10 篇近三年关于某某方向的参考文献并给出国标格式」,极高概率会得到真实学者姓名 + 拼凑出来的假标题 + 指向毫不相关文章的假 DOI。正确分工必须遵循以下铁律(更多学术写作提示词见 Claude 论文写作提示词 与 用 ChatGPT 做论文开题和文献综述):
- 找文献走学术检索库而非纯聊天生成:用大模型帮你把中文研究点发散成地道英文检索布尔表达式(如
("retrieval augmented generation" OR RAG) AND ("table parsing" OR "financial report")),自己去 Google Scholar、Web of Science 或 Semantic Scholar 检索并通过 Zotero Connector 浏览器插件抓入本地库。 - 按页码回查实验数字:凡是要写进你开题报告或论文 Related Work 里的具体提升百分比、参数量,必须顺着模型标注的
Table X / Section Y在 Zotero 原文里亲眼核实一遍。 - 引文格式化 100% 交给 Zotero:写作时只让模型帮你润色逻辑衔接句,文内角标与文末 Reference 列表统一用 Zotero 的 Word / LaTeX(Better BibTeX)插件从你已核实的本地文献库一键生成。
常见问题
问:双栏排版的英文 PDF 框选跨列句子时,换行符把一句话截断导致翻译不通顺怎么办?
答:Translate for Zotero 插件在设置中默认提供「自动拼接PDF换行符」选项,开启后会自动把段内硬回车替换为空格再发给大模型接口,遇到公式与上下标交叉处可手动框选单栏段落。
问:能不能直接让第三方插件扫描我整个 Zotero 文献库几百篇 PDF 自动建知识库?
答:技术上虽有开源问答扩展支持,但几百篇英文长论文全量切块调云端 API 会瞬间消耗数百万 Token 并产生高昂账单。更稳妥省钱的做法是按子课题建 Zotero 分类文件夹,每次只挑最核心的 5–10 篇放进 Claude Projects 做专题精读。
问:用大模型帮忙润色英文论文初稿算不算学术不端?
答:取决于目标期刊或高校的最新声明规范。主流出版商(如 Elsevier、Springer Nature、IEEE)普遍禁止将 AI 列为共同作者或直接生成无核实的实验论述,但多数允许作者在规定范围内用于语言语法润色,并要求在文末方法或致谢/声明处按期刊模板如实披露所使用的工具名称与用途。
问:国内学生和科研人员没有外币卡,怎么订阅 Claude Pro 或 ChatGPT Plus 读文献,能开发票报销吗?
答:可在本站 Claude Pro 充值页、ChatGPT Plus 充值页 或 AI 会员充值总览 自助下单,支持支付宝、微信支付及 AlipayHK,提供免交账号密码的自助卡密充值方式,并支持开具国内增值税发票供课题组与企业合规报销;实时价格与售后保障(掉订阅按剩余天数折退,封号不在质保范围)以商品页说明为准。
相关教程
- 用 AI 读论文、做文献综述的流程:单篇精读、多篇对比、综述提纲与引文核对
- Claude 论文写作提示词:选题、文献梳理、大纲、修改的可复制模板
- 用 ChatGPT 做论文开题和文献综述:选题、研究问题到开题提纲
- AI 翻译 PDF 和长文档:术语表、分段翻译、双语校对的完整流程
参考资料
- Zotero 官方文档:Zotero PDF Reader and Note Editor — https://www.zotero.org/support/pdf_reader
- Translate for Zotero 开源插件文档 — https://github.com/windingwind/zotero-pdf-translate
- OpenAI API 官方接口参考 — https://platform.openai.com/docs/api-reference/chat
- Anthropic Claude API 官方文档 — https://docs.claude.com/en/api/messages
0 条评论
还没有评论,来抢沙发~