
结论先说
- 默认绝不用于训练模型:OpenAI 官方明确承诺,不会使用 ChatGPT Business 工作区中的业务数据(包括提示词输入、上传文件和模型输出)来训练或改进 OpenAI 模型。
- 数据归属权归客户组织:在法律允许的范围内,你的组织保留对输入内容和模型输出内容的拥有权与控制权。
- 传输与存储全程加密:数据在静态存储时采用 AES-256 加密,在网络传输过程中采用 TLS 1.2 及以上标准加密(涵盖 Business 下的 ChatGPT、Work 与 Codex)。
- 成员对话默认彼此隔离:每位成员有独立的聊天与本地 Codex 历史,除非成员主动共享链接或项目,否则工作区所有者和管理员默认看不到私人对话。
- 认清自助版的合规上限:自助 Business 不提供零数据保留(Zero Data Retention)、医疗行业 BAA 协议或自定义数据驻留地区,有这类硬要求需走 Enterprise 合同方案。
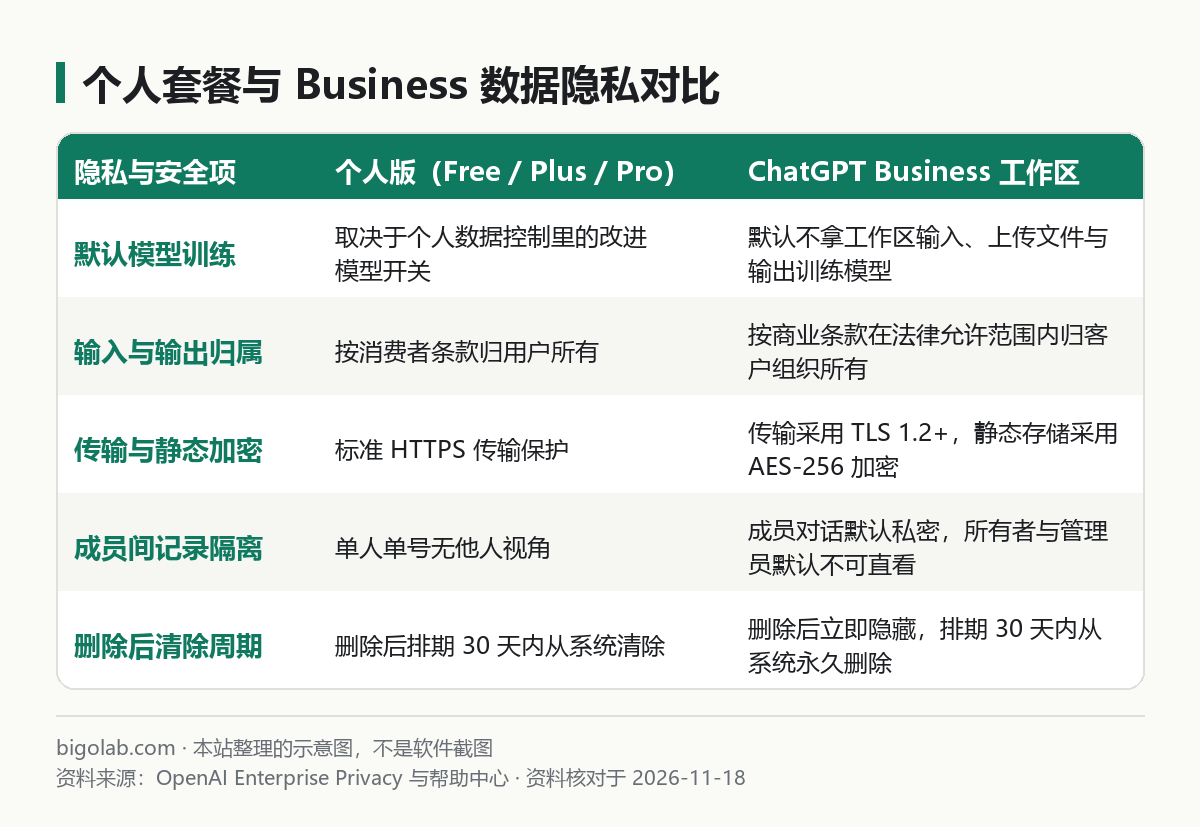
图:本站根据 OpenAI Business Data 页面 与帮助中心整理的示意图
本文根据 OpenAI 官方商业数据隐私页面(openai.com/business-data/)及帮助中心《ChatGPT Business overview》《ChatGPT Business: General FAQ》整理,资料核对于 2026-11-18。本文仅供信息核对参考,不能代替律师的合规审查意见。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 公司准备采购团队账号,IT 或安全负责人追问「发进去的源代码和业务报表会不会被拿去训练下一代大模型」的人;
- 担心同事或老板能在后台直接翻看自己工作区聊天记录的团队成员;
- 需要核对加密标准、对话删除清除周期,以及自助 Business 到底能不能签 BAA 或零数据保留的人。
一、官方对「不用于训练」的准确口径
在个人版(Free、Plus、Pro)里,对话会不会用于改进模型,取决于用户自己有没有去设置里关掉「为所有人改进模型」开关(两档套餐的完整对比见 ChatGPT Business 和 Plus 区别)。
而在 ChatGPT Business(以及 Enterprise、Edu)工作区中,免训练是组织级出厂默认规则,不需要员工逐个去点开关:
- 你在网页和桌面端发出的文字、上传的表格与文档、模型生成的回答,默认都不进入模型训练池;
- 在同一 Business 工作区下使用 ChatGPT Work 与 Codex 处理代码仓库时,官方安全文档同样写明受涵盖服务处理的业务数据在传输与静态存储中均受加密保护,且默认不用于训练 OpenAI 模型。
需要为公司或研发团队开通具备默认免训练承诺的工作区,可查看本站 ChatGPT Business 团队版定制。
二、内部可见性、保留期限与删除规则
除了防外部模型训练,团队内部也很关心「谁能看、留多久、怎么删」:
- 内部隐私边界:官方概览页写明,默认情况下工作区所有者(Owner)和管理员(Admin)无法在后台直接调阅普通成员的私人聊天和 Codex 会话历史(角色权限表见 ChatGPT Business 管理员控制台怎么用)。只有被放进共享项目或主动分享的 GPT、对话,对应范围内的同事才看得见。
- 保留与删除周期:未删除的对话会保留在工作区账号内供成员随时检索。当成员手动删除一条对话后,它会立刻从历史界面消失,并排期在 30 天内从 OpenAI 系统中永久清除(除非因法律义务或安全滥用调查必须依法留存)。Codex 本地与云端会话的归档删除细节见 Codex 怎么删除对话、清理任务。
- 连接器数据的区别:如果成员在对话中连接过 Google Drive、邮箱或日历,删除该对话会一并清掉留存在对话里的同步数据副本,但不会改动网盘或邮箱里的原始文件;只点「归档」不点「删除」则会继续保留。
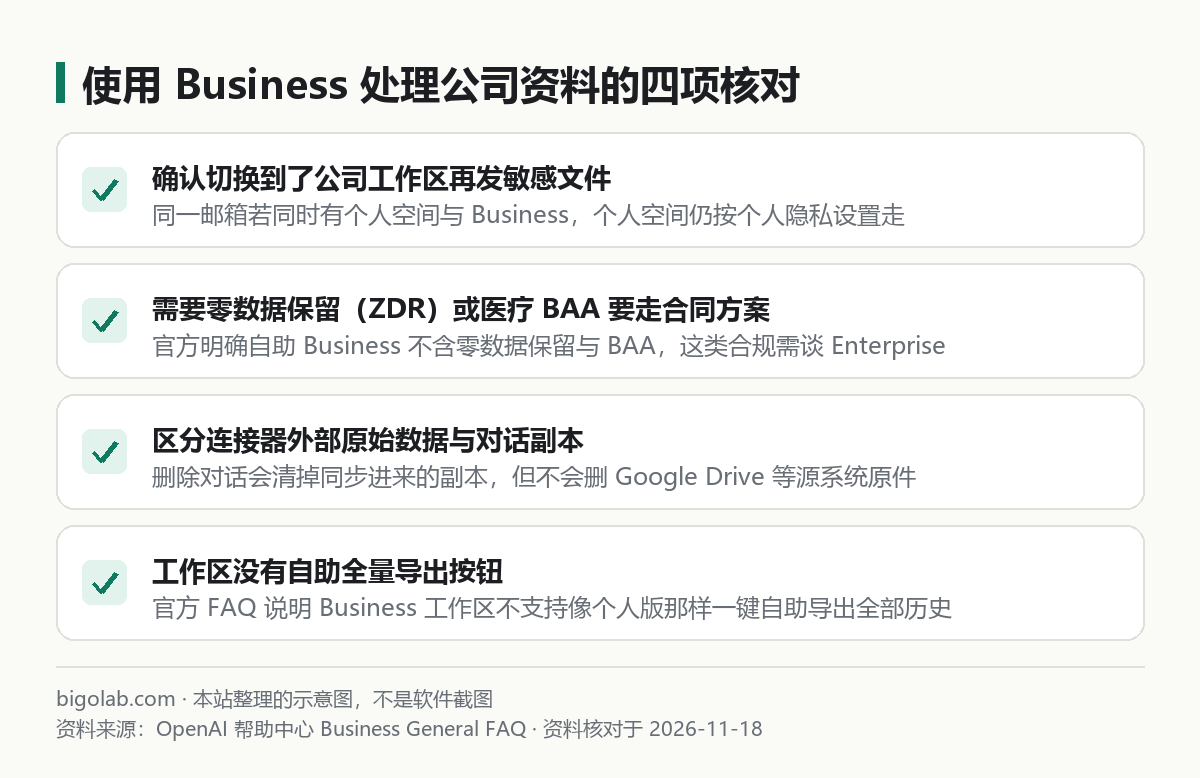
图:本站根据 OpenAI 帮助中心:ChatGPT Business General FAQ 整理的示意图
三、使用前必须看清的四处限制(别把个人空间混进来)
把敏感工作资料喂给 ChatGPT 之前,务必逐条核对以下四个常见盲区:
- 盲区一:发消息前没切工作区。 如果你的邮箱既保留了个人工作区,又加入了公司的 Business 工作区,留在「个人空间」里发出的文件遵守的是个人消费者条款,不受公司 Business 免训练条款保护。每次上传内部资料前,先瞄一眼左下角工作区名称对不对。
- 盲区二:把个人工作区永久合并进公司。 接受邀请时若选择了「合并(Merge)」个人空间,你原先的个人聊天和自定义 GPT 就会不可逆地转入公司组织的控制之下。
- 盲区三:自助 Business 没有一键全量导出。 官方 FAQ 明确写明,Business 工作区不支持个人版那种自助打包导出全部聊天记录的功能(个人版导出方法见 ChatGPT 导出聊天记录教程)。
- 盲区四:特殊监管行业要求。 如果贵司受严格金融、医疗监管,必须签商业伙伴协议(BAA)、要求服务器端零数据保留(ZDR)、指定美国或欧盟数据驻留(Data residency),或者需要通过 Compliance API 拉取审计日志,自助 Business 均不包含,需联系官方销售改签 Enterprise(对比见 ChatGPT 企业版 Enterprise 和团队版 Business 有什么区别)。
常见问题
问:Business 工作区里成员自己建的自定义 GPT,里面的知识库文件会被拿去训练吗?
答:不会。放在 Business 工作区内的自定义 GPT 及其上传的知识库文件同样属于工作区业务数据,适用默认不训练承诺。
问:用 API Key 调接口的数据也归 ChatGPT Business 管吗?
答:两套账户独立计费和管理,但 OpenAI 对 Platform API 同样默认不拿 API 请求数据训练模型(除非组织管理员主动勾选数据共享计划)。
问:开启 SAML 单点登录能进一步加强工作区数据安全吗?
答:可以。Business 支持配置 SAML SSO 与强制多因素认证(MFA),员工离职在公司统一身份系统里停用账号后就无法再登录工作区。
相关教程
- ChatGPT Business 和 Plus 区别
- ChatGPT Business 管理员控制台怎么用
- ChatGPT 企业版 Enterprise 和团队版 Business 有什么区别
- Codex 怎么删除对话、清理任务
- ChatGPT 导出聊天记录教程
参考资料
- OpenAI 官方:Business data privacy, security, and compliance — https://openai.com/business-data/
- OpenAI 帮助中心:ChatGPT Business overview — https://help.openai.com/en/articles/8792828-chatgpt-business-overview
- OpenAI 帮助中心:ChatGPT Business General FAQ — https://help.openai.com/en/articles/8542115-chatgpt-business-general-faq
0 条评论
还没有评论,来抢沙发~