
本文根据 Codex 官方沙盒文档、云端联网文档和《Prompting》整理,资料核对于 2026-11-05。关于爬虫合规的部分是本站的一般性建议,不是官方规定,也不是法律意见。配图为本站整理的示意图,不是软件截图。本站(bigolab.com)不是 OpenAI 官方网站。安装与配置见 /guides/codex-getting-started。
适用于谁
- 想自己抓取公开网页上的数据(价格、公告、文章列表)做整理分析的人;
- 已经有一批抓下来的数据,想让 Codex 帮忙清洗、去重、整理成表格的人;
- 担心“爬虫会不会违规、会不会被封”的人。
结论先说
- 先确认能不能抓,再谈怎么写。 看目标网站的服务条款和
robots.txt,有开放接口(API)或可下载的数据就优先用那个。这一步是本站的建议,官方文档没有讲。 - 脚本要克制。 限速、设置明确的访问间隔、失败重试有上限、不绕过登录和验证、不抓个人隐私信息。
- 先小范围试跑。 先抓一页、再抓十页,确认结构和数据没问题再扩大。
- 保存原始数据,清洗另存一份。 网页改版后你还能重新清洗,不用重抓。
- 注意 Codex 的网络限制。 本地沙盒会限制网络访问,需要时会询问你;云端环境联网默认可以关闭,开放联网有风险,官方建议尽量限制。
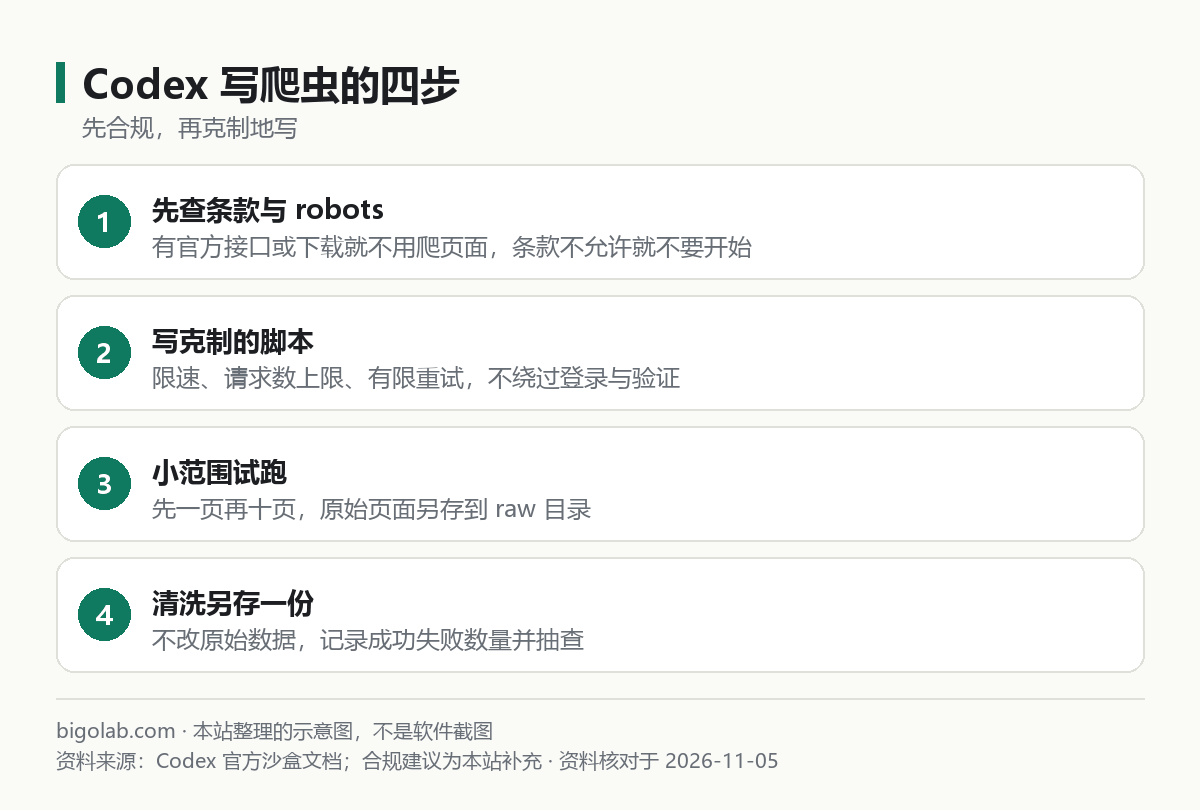
图:本站根据 Codex 官方沙盒文档和本站建议整理的示意图
一、动手前的合规自查
下面是本站的一般性建议,不是 OpenAI 的规定,也不是法律意见:
- 服务条款:很多网站的条款里写明了是否允许自动化访问和数据再利用,没看过就不要开始;
- robots.txt:在网站域名后加
/robots.txt可以看到站点对爬虫的访问说明,应该遵守; - 有没有官方接口:有 API 或数据下载就不要去抓页面;
- 数据性质:个人信息、需要登录才能看的内容、有版权的内容,不要批量抓取和再发布;
- 访问强度:别给对方服务器造成压力,限速、避开高峰;
- 用途:只用于自己的分析和学习,不要用来做对网站有害的事情。
用 AI 写爬虫不会改变这些责任,决定抓什么、怎么用的人是你。
二、Codex 的网络限制,你要知道
- 本地:官方沙盒文档说,默认的
workspace-write模式可以在工作区内读写、运行常规本地命令;需要越过沙盒边界时(比如网络访问被拦截),按你的审批策略询问。审批时官方建议选能让任务继续的最窄范围。danger-full-access会去掉文件和网络边界,只在你确实想让它完全自由时使用。详见 /guides/codex-permissions-sandbox。 - 云端:官方云端联网文档(页面标注为 Legacy 版)说,代理联网按环境配置,可以完全关闭;开启后可以用域名白名单和允许的 HTTP 方法来限制,甚至只允许
GET、HEAD、OPTIONS。 - 提示词注入:官方在该页提醒,开放联网可能因提示词注入导致敏感数据泄露或不安全的改动,所以只让 Codex 访问可信资源,并尽量限制联网。
这对写爬虫的意义是:让 Codex 写脚本,和让 Codex 自己去抓网页,是两件事。 前者只需要读写文件,风险小;后者要放开联网,风险大。建议让它写好脚本,你检查过之后自己在本机运行。
三、4 段可以直接复制的提示词
方括号里是要你自己填的内容。
1. 先评估,不写代码
我想从 [网站名称 / 网址] 获取 [具体数据,例如商品名称和价格],用于 [个人分析]。
请先不要写代码,帮我评估:
1. 这个网站有没有官方接口或可下载的数据,能不能不用爬页面;
2. 我应该去哪里查看它的服务条款和 robots.txt,要注意哪些条款;
3. 如果只能爬页面,怎么做才算克制(限速、数量上限、只抓公开页面)。
你不能替我判断是否合法,只列出我需要自己核对的事项。
2. 写一个克制的抓取脚本
请用 [Python] 写一个脚本,抓取 [目标页面类型] 的 [字段列表],要求:
- 每次请求之间至少间隔 [2] 秒,总请求数上限 [50],失败最多重试 [2] 次;
- 设置明确的 User-Agent,并写上联系方式的占位 [your-email];
- 遵守 robots.txt,不处理登录、验证码和反爬措施,遇到就停止并报告;
- 原始响应保存到 raw/ 目录,一页一个文件,已下载过的不重复请求;
- 只写脚本,先不要运行。写完告诉我怎么在本机运行、先用哪个参数小范围试跑。
3. 清洗已有数据
raw/ 目录里是已经下载的网页。请写脚本把它们整理成 CSV:
- 字段:[字段列表],缺失值留空,不要补 0;
- 去掉重复记录,保留来源网页文件名作为一列,方便我回头核对;
- 无法解析的文件单独列出,不要悄悄跳过;
- 不修改 raw/ 里的任何文件。
最后告诉我:处理了多少个文件、成功多少、失败多少,以及抽查方法。
4. 网页改版后修复
之前能用的脚本现在报错了,网站可能改版。报错如下:
[粘贴完整报错]
请先对比 raw/ 里新旧页面的结构差异,说明哪些选择器失效;再提出最小的修改。
不要增加请求频率,也不要尝试绕过任何访问限制。
清洗数据时的核对方法,和 /guides/codex-clean-csv-excel-batch-data 一致:看行数账、随机抽查、确认空白没有变成 0。
四、几个容易出问题的地方
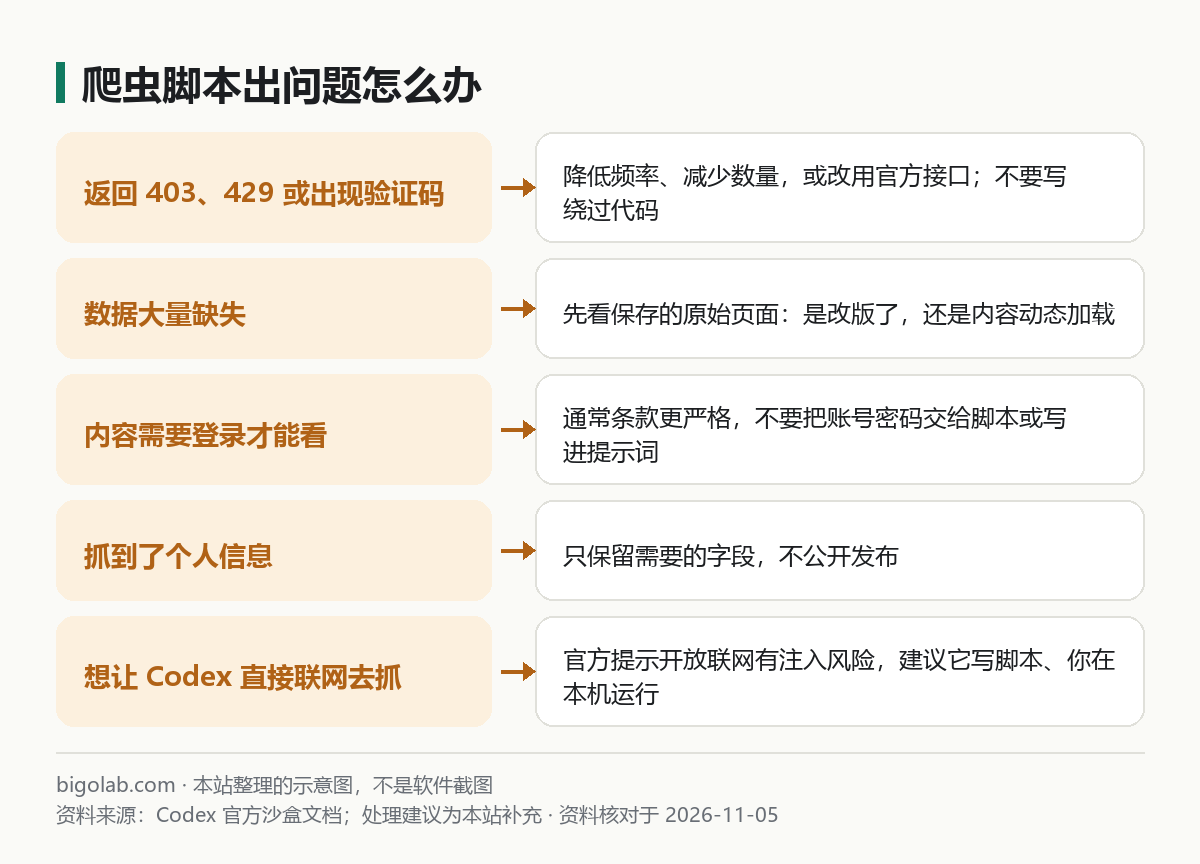
图:本站根据 Codex 官方沙盒文档和本站建议整理的示意图
- 返回 403、429 或验证码:说明对方在限制自动访问。降低频率、减少数量,或者换用官方接口;不要让 Codex 去写绕过验证的代码;
- 数据大量缺失:先看保存的原始页面,是网页改版了,还是内容是脚本动态加载出来的,再决定怎么改;
- 内容需要登录:需要登录的内容通常有更严格的条款,别把账号密码交给脚本,也别写进提示词,见 /guides/ai-privacy-data-safety-checklist;
- 抓下来的数据里有个人信息:只保留你需要的字段,不要公开发布。
常见问题
Q:Codex 会拒绝写爬虫吗?
官方文档没有说明这一点,是否拒绝取决于具体请求。无论它写不写,合规责任都在你。
Q:可以让它直接联网去抓吗?
不建议。按官方提示,开放联网存在提示词注入的风险。让它写脚本,你检查后在本机运行更稳妥。
Q:额度够不够?
写脚本消耗不大,反复调试会增加。Codex 随 ChatGPT 套餐提供,额度以官方页面为准,需要更多额度可以看看 /chongzhi/chatgpt-plus 里的说明。
参考资料
- Codex 官方文档:Sandbox — https://learn.chatgpt.com/docs/sandboxing
- Codex 官方文档:Internet access(Legacy cloud)— https://learn.chatgpt.com/docs/cloud/internet-access
- Codex 官方文档:Prompting — https://learn.chatgpt.com/docs/prompting
0 条评论
还没有评论,来抢沙发~