
本文根据 Codex / ChatGPT 官方用例《Clean and prepare messy data》《Consolidate spreadsheets》和《Prompting》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是软件截图。本站(bigolab.com)不是 OpenAI 官方网站。安装与配置见 /guides/codex-getting-started,本文只讲怎么交代数据任务。
适用于谁
- 手里有一份系统导出的 CSV 或表格,日期格式不统一、金额带货币符号、有重复行,想整理成能直接用的版本的人;
- 每月要把几份导出合成一份报表的人;
- 不想自己写公式、写脚本,但又担心“一整理就把原始数据弄坏”的人。
结论先说
- 官方的核心做法:让它清洗一份副本,原文件保持不变。 官方用例明确写了“write a cleaned copy while keeping the original file unchanged”。
- 把你已经看到的问题逐条写出来,再说清想要什么结果(清洗后的 CSV、一个新的表格页,还是可以直接上传的文件)。
- 让它附一份简短的数据质量说明:改了什么、删了什么、哪些行拿不准。用之前先打开清洗后的文件和这份说明。
- 合并多份表格时,先说清连接键,并要求对不上的记录单独列出来复查,不要让它猜、不要让它悄悄合并有冲突的记录。
- 清洗结果要自己抽样核对,官方没有保证结果一定正确。
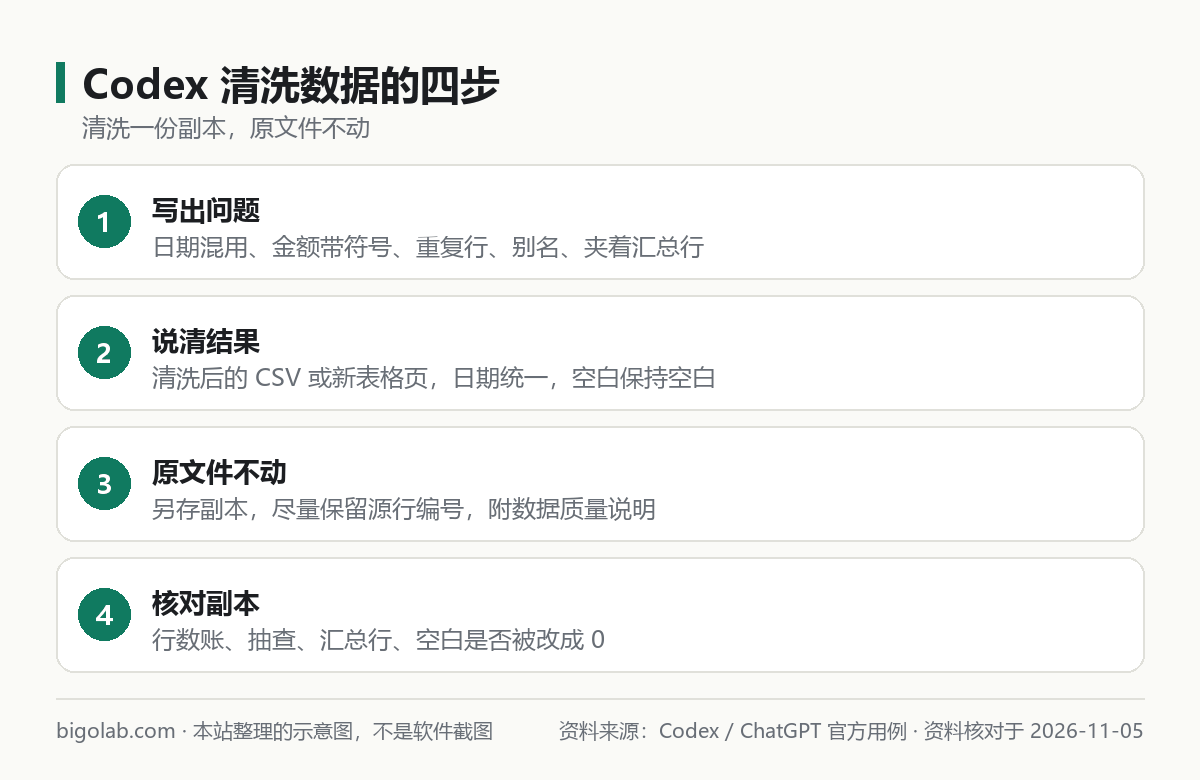
图:本站根据 官方用例《Clean and prepare messy data》 整理的示意图
一、先把文件和问题准备好
官方用例的用法很简单:把文件拖进去,或者在提示词里用 @ 点名,例如 @customer-export.csv。然后做三件事:
- 描述你已经看到的问题。 官方示例列了几类常见问题:日期在两种写法之间混用、金额里有货币符号、逗号和空白单元格、重复导出造成的重复客户行、同一个地区或类别有多种写法、混进来的粘贴汇总行。
- 说清想要的结果:清洗后的 CSV、表格里新增一页,或可直接上传到别的系统的文件。
- 说明边界:原文件不动、空白金额保持空白(不要补成 0)、尽量保留源行编号以便回头对照。
官方《Prompting》也提到,大任务可以按“目标、背景、输出、边界”来组织提示词,只写有用的部分,不必每项都填。数据清洗正好适合这个结构:目标是干净的副本,背景是文件和问题清单,输出是文件格式加质量说明,边界是原文件不动。
如果你的 Codex 在命令行或 IDE 里运行,文件要放在它能访问的工作目录里。它能读写哪些目录由沙盒和审批设置决定,见 /guides/codex-permissions-sandbox。
二、4 段可以直接复制的提示词
方括号里是要你自己填的内容。
1. 清洗一份导出文件
请清洗 @[文件名]。
我已经发现的问题:
- 日期混用了 [MM/DD/YYYY] 和 [YYYY-MM-DD] 两种写法
- 金额列里有货币符号、千分位逗号和空白单元格
- 有几行客户记录是重复导出造成的
- [地区 / 类别] 有多种叫法
- 数据中间夹着粘贴进来的汇总行
我要的结果:
- 另存为一份清洗后的 CSV,原文件保持不变
- 日期统一为 [YYYY-MM-DD]
- 空白金额保持空白,不要补 0
- 尽量保留原始行编号
- 再给我一份简短的数据质量说明:改了什么、删了多少行、哪些行你不确定
2. 先只看、不改:摸清数据有什么问题
我还不清楚 @[文件名] 里有哪些问题。请先只读不改:
1. 列出每一列的含义和你推测的数据类型;
2. 找出格式不一致、重复、缺失、明显异常的值,各给 3 个例子和所在行号;
3. 告诉我清洗时有哪些地方需要我做决定(比如重复行保留哪一条)。
先不要生成任何文件。
3. 合并多份导出
请把 @[文件一]、@[文件二]、@[文件三] 合并成一个表格。
- 用 [客户编号] 作为连接键,重复记录的处理规则是:[保留最新一条]
- 计算 [每个客户本月合计金额],并和 @[目标文件] 里的目标对比
- 单独做一页“复查”:列出对不上的键和没能合并的记录
- 另外写一页“说明”:假设、口径和下次刷新的步骤
不要编造连接键,不要悄悄合并有冲突的记录,保留原始导出文件不动。
4. 模拟下次刷新
假设下个月我换上新的导出文件,请检查这套流程:
- 哪些输入可以直接替换而不用改流程;
- 哪些公式、连接和图表会正确更新;
- 有没有重复或对不上的键;
- 哪些假设没有写进说明;
- 哪些步骤还需要人工判断。
不要覆盖源文件,也不要改变业务口径。
第 3、4 段的思路来自官方《Consolidate spreadsheets》用例:先把连接键、重复规则、口径说清,再让它把有问题的记录隔离出来,最后测试一次下次刷新。
三、清洗完之后怎么核对
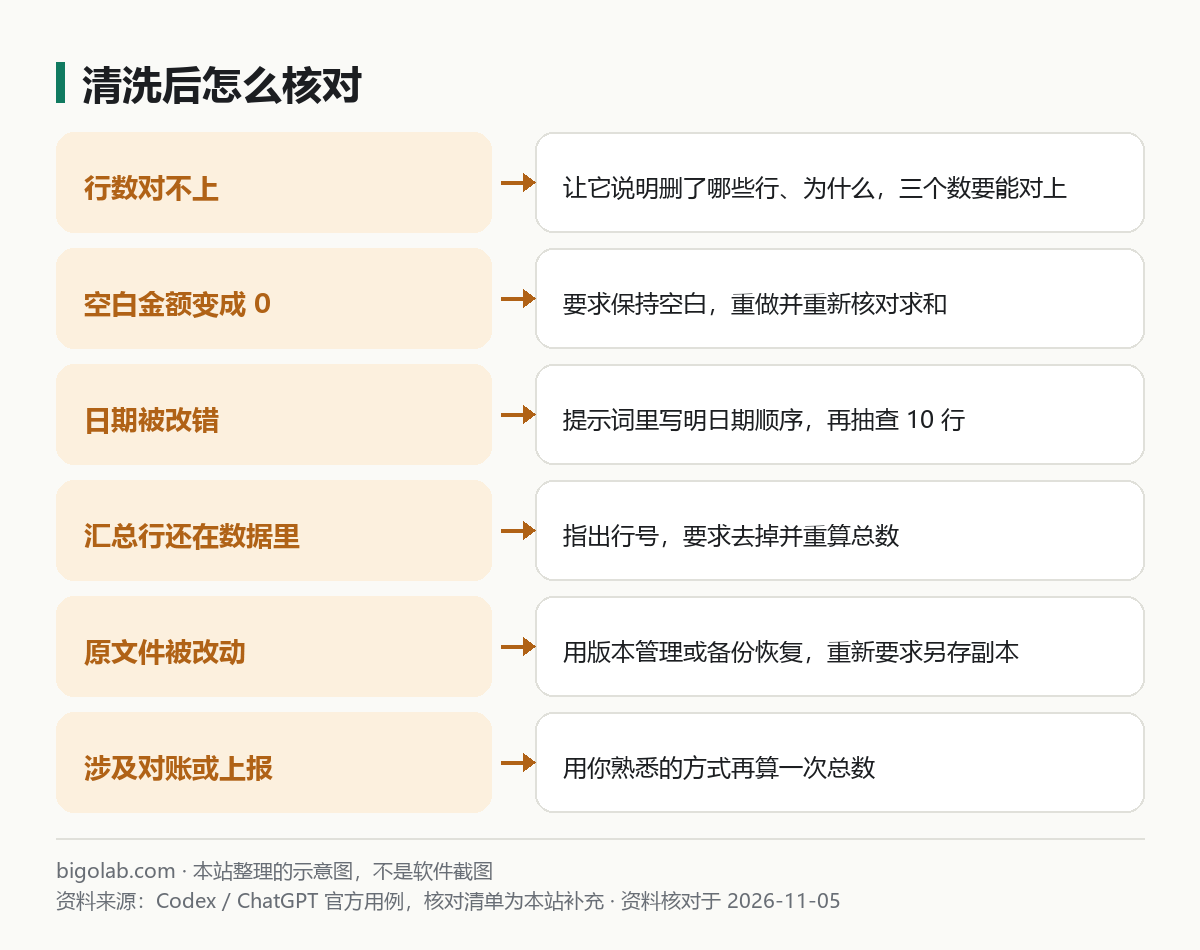
图:本站根据 官方用例《Clean and prepare messy data》 整理的示意图
官方建议是:先打开清洗后的文件和聊天里的数据质量说明,再用于下游。下面是本站补充的核对清单,不是官方清单:
- 行数账:原文件多少行、清洗后多少行、删了多少行,三个数要对得上,说明里要有解释;
- 随机抽查:随便挑 10 行,和原文件逐项对比,尤其是日期和金额;
- 汇总行:混进数据里的合计行是否都去掉了,没有被当成普通数据算进总数;
- 空白与零:空白金额没有被改成 0,否则求和、平均值都会变;
- 原文件:确认原文件的修改时间没变,必要时对比一下文件大小;
- 重要数据:财务、对账、要上报的数据,清洗后用你熟悉的方式再算一次总数。
发现问题就把具体的行号和现象发给它,让它说明原因再改,不要只说“有错”。
四、几个容易踩的点
- 不要把含身份证号、手机号、银行账号的原始文件直接交出去。 先脱敏或只取需要的列,检查清单见 /guides/ai-privacy-data-safety-checklist;
- 日期的歧义要你来裁决。
03/04/2026是 3 月 4 日还是 4 月 3 日,文件本身可能判断不出来,提示词里要写明; - 一次只处理一类问题,先去重、再统一格式、最后合并,每一步都核对,比一次性“全部搞定”更可靠;
- 把常用规则存起来。 同类文件每月都要清洗的话,可以把规则写进 AGENTS.md,见 /guides/codex-agents-md-how-it-reads。
如果你更习惯在 ChatGPT 网页里直接传表格分析,可参考 /guides/chatgpt-excel-data-analysis。
常见问题
Q:它说清洗好了,但数字和我手算的不一样?
把两边的差异、涉及的行和你的算法告诉它,要求它先说明差异的来源,再改。不要在没弄清口径之前反复让它“再算一遍”。
Q:文件很大怎么办?
先让它读取表头和前几十行,确认结构,再分步处理。官方没有给出文件大小上限,实际限制以当前版本为准。
Q:需要多少额度?
Codex 随 ChatGPT 套餐提供,额度以官方页面为准。数据任务如果来回修改次数多,消耗会更大,需要更多额度可以看看 /chongzhi/chatgpt-plus 里的说明。
参考资料
- Codex / ChatGPT 官方用例:Clean and prepare messy data — https://learn.chatgpt.com/use-cases/clean-messy-data
- Codex / ChatGPT 官方用例:Consolidate spreadsheets — https://learn.chatgpt.com/use-cases/consolidate-spreadsheets
- Codex / ChatGPT 官方文档:Prompting — https://learn.chatgpt.com/docs/prompting
0 条评论
还没有评论,来抢沙发~