
結論先說
- 全員預設開啟,代碼裏不用加任何緩存開關:DeepSeek 的上下文硬碟緩存自動對每次請求生效,只要後續請求的開頭完整複用了已落盤的前綴,重複部分就直接走緩存拉取。
- 命中單價遠低於未命中,疊加閒時還能再省:按官方價格頁對照,以 Flash 空閒時段為例,緩存命中輸入為 0.02 元 / 百萬 token,而未命中輸入為 1 元 / 百萬 token(價格變動見 DeepSeek 價格調整時間線與當前價格)。
- 看有沒有省到錢,查返回體
usage裏的兩個字段:prompt_cache_hit_tokens是本次輸入命中的 token 數,prompt_cache_miss_tokens是未命中的 token 數。 - 同文檔換不同問題,通常要從第三次請求起才命中:受 Sliding Window Attention 機制影響,前兩次請求
A + B與A + C完成後,系統才會提取出公共前綴A單獨落盤,第三次發A + D時開始穩定命中。 - 緩存不保證百分百命中,也不會鎖死輸出內容:系統屬於「盡力而為」,閒置數小時至數天後自動清空;緩存只複用輸入前綴計算,模型輸出照常實時推理並受
temperature影響。 - 主力模型訂閱與帳號配套入口:跑通 MCP 工具鏈與多文件智能體編碼依賴穩定的底層大模型配額,國內免境外卡自助開通可見本站 Claude Code 訂閱頁、ChatGPT Plus 充值頁 與 AI 會員充值總覽。
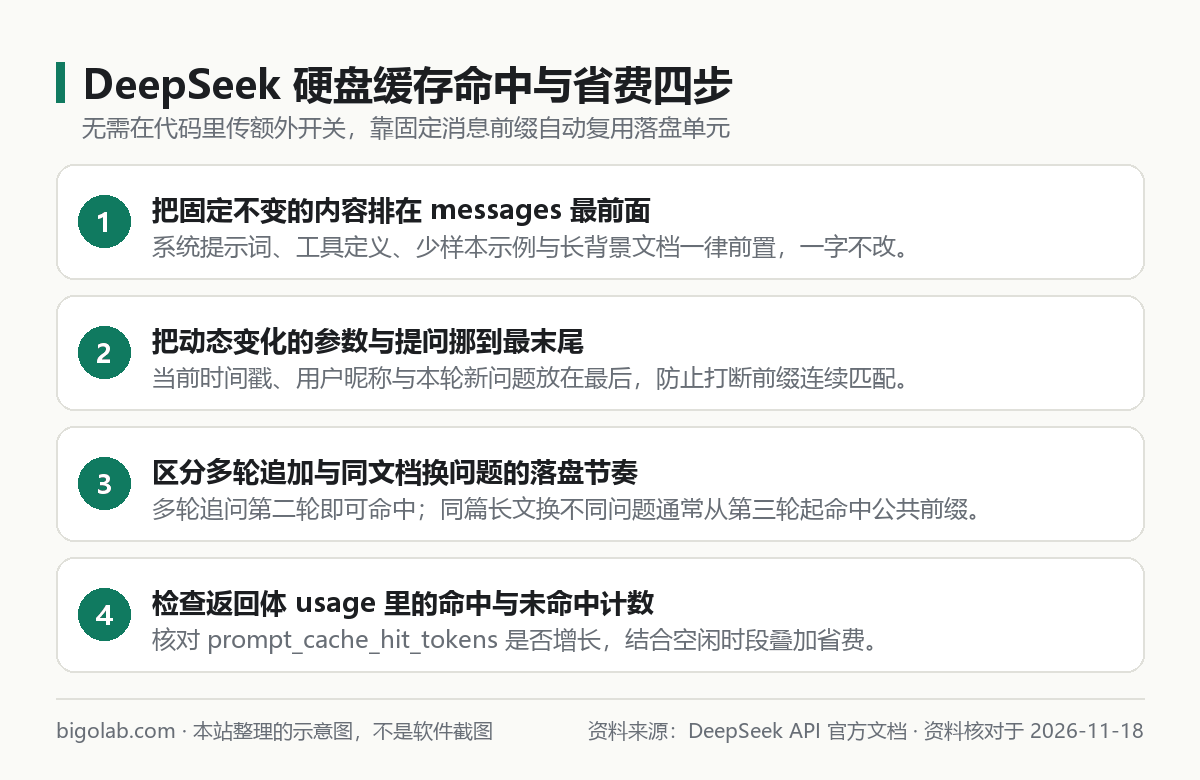
圖:本站根據 DeepSeek API 文檔:上下文硬碟緩存 整理的示意圖
本文根據 DeepSeek API 官方文檔《上下文硬碟緩存》與《模型 & 價格》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 DeepSeek 官方網站。
適用於誰
- 在調 DeepSeek API 處理長文檔問答、多輪對話或智能體工具循環,想把輸入賬單壓下來的開發者;
- 搜「deepseek api 緩存 命中」「prompt_cache_hit_tokens 一直是 0 怎麼辦」的人;
- 想弄清為什麼同一篇長文換第二個問題沒命中、到第三個問題才開始命中的人。
開放平台充值、餘額查詢與發票開具流程,先看 DeepSeek API 開放平台怎麼充值和查用量。
一、怎麼查看 prompt_cache_hit_tokens 與計費效果
正常調用 /chat/completions 接口後,直接打印響應裏的 usage 對象就能核實命中比例:
python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com",
)

resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "你是一位嚴謹的技術文檔審校助手,請只依據用戶提供的原文作答。"},
        {"role": "user", "content": "(這裏放數萬字的固定參考規範文本)\n\n問題:請列出第三章提到的接口超時要求。"},
    ],
)

print("命中緩存 tokens:", resp.usage.prompt_cache_hit_tokens)
print("未命中 tokens:", resp.usage.prompt_cache_miss_tokens)帳單結算時,本次請求的輸入費用拆成「prompt_cache_hit_tokens × 緩存命中單價 + prompt_cache_miss_tokens × 緩存未命中單價」兩部分計算。關於上下文窗口上限的更多說明,可參考 DeepSeek 上下文長度與最大輸出是多少。
二、搞懂「緩存前綴單元」的三種落盤時機
為什麼有時候明明開頭一樣卻沒命中?官方文檔專門解釋了在 Sliding Window Attention 架構下,後續請求必須完整匹配某一個已寫入硬碟的「緩存前綴單元」才能命中。系統會在三個時機把前綴切出來落盤:
- 請求結束位置落盤(天然適配多輪對話):每次請求的用戶輸入結尾和模型回覆結尾各生成一個單元。第一輪發
A + B,第二輪帶着歷史記錄發A + B + C,第二輪剛好完整包含第一輪的結束單元,第二輪就能直接命中; - 公共前綴檢測落盤(長文檔反覆換問題必看):假設
A是一篇五萬字合同,第一輪問總結(A + B),第二輪換個問題問違約責任(A + C)。注意第二輪不會命中,因為A + C沒有完整匹配第一輪落盤的A + B;但系統在兩輪結束後會識別出公共部分A並把它單獨落盤成新單元,從第三輪(A + D)開始後續所有新問題都能命中A; - 按固定 token 間隔落盤:面對超長輸入或超長輸出時,系統會每隔固定數量的 token 截取一次前綴單元,防止長文本因遲遲沒到結尾而完全無法複用。
如果你還同時在用需要顯式標記斷點的緩存機制,可對比閱讀 Claude 提示詞緩存(Prompt Caching)入門。
三、讓命中率最大化的固定前綴寫法與未命中排查
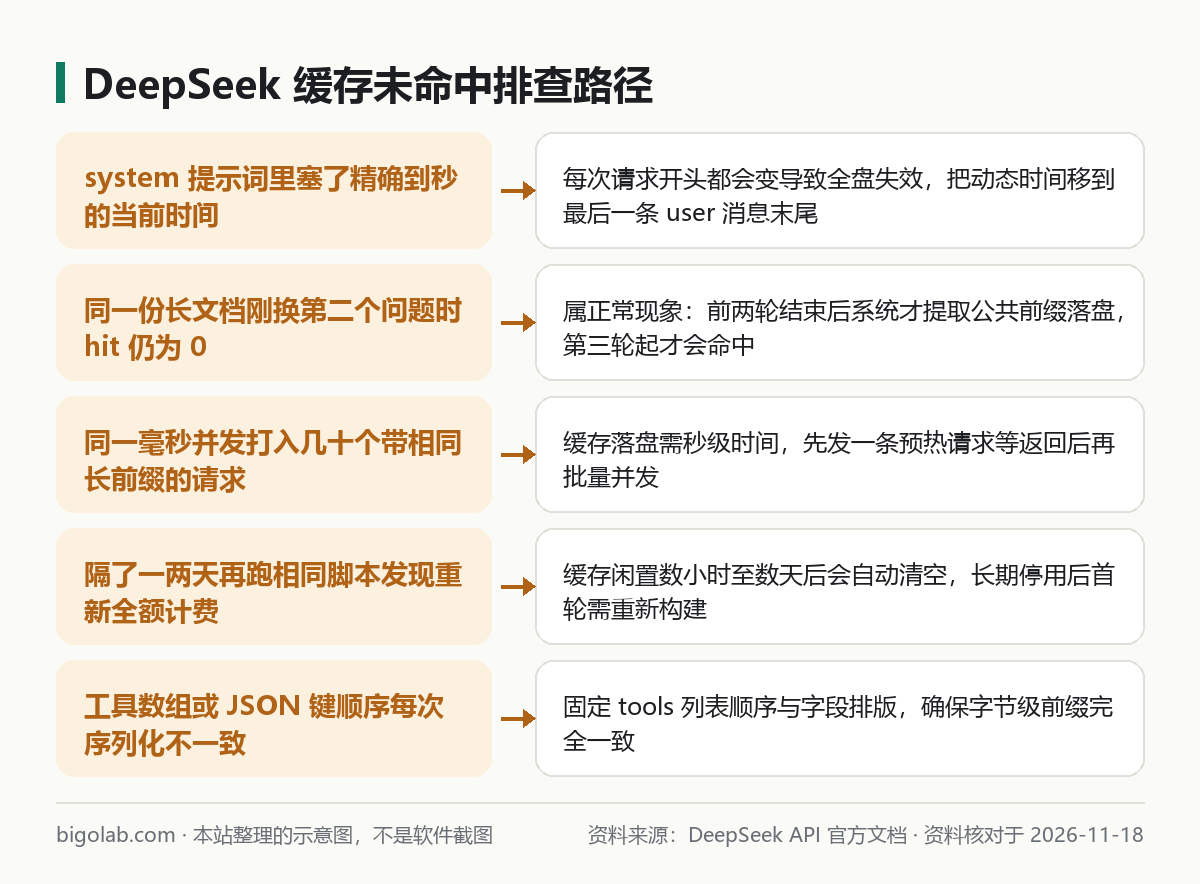
圖:本站根據 DeepSeek API 文檔:上下文硬碟緩存 整理的示意圖
寫業務代碼拼接 messages 時,遵守「靜態全放前、動態全放後」四條鐵律,並在不命中時按順序排查:
- 嚴禁在
system開頭塞動態時間或隨機請求號:哪怕在第一行寫一句「當前時間 14:05:01」,下一秒變成14:05:02,從那個字往後的幾萬 token 就全部失去前綴連續性。動態資訊一律挪到最後一條user消息末尾; - 固定
tools數組與 JSON 序列化鍵序:如果每次用字典無序生成工具列表或示例 JSON,底層拼出來的文本順序一變就會斷掉前綴匹配; - 大批量並發前先發 1 到 2 條預熱請求:官方說明緩存構建落盤耗時為秒級。如果一上來同一毫秒並發發出 50 個相同長文檔請求,此時硬碟裏還沒落盤完成,這 50 條都會算未命中;先跑完前兩條讓公共前綴落盤,再放開並發最省錢;
- 留意閒置過期與盡力而為邊界:緩存長時間不用(一般為幾個小時到幾天)會自動回收清空,隔天重跑任務時首輪重新計入
miss屬於正常現象。
日常開發中如果需要同時訂閱海外主流大模型做生成效果對比,也可以在本站查看 AI 會員充值總覽 或了解 ChatGPT Plus 充值。
常見問題
問:命中硬碟緩存後,同樣的提問是不是每次都返回一模一樣的死板答案?
答:不會。官方寫明硬碟緩存只匹配到用戶輸入的前綴部分,模型的回答依然通過實時計算推理生成,照常受 temperature 等採樣參數控制。
問:單輪一次性跑完的批處理腳本,每篇文檔都不一樣,能靠緩存省錢嗎?
答:如果每條請求只有短短几十字相同的 system 提示詞、正文全是不同文檔,緩存能省的部分非常有限;這類離線任務更適合放到北京時間空閒時段跑,直接享受峰谷半價。
問:用兼容 Anthropic 格式的端點調用 DeepSeek 也有緩存嗎?
答:底層同樣享受預設自動緩存,具體兼容字段差異可對照官方兼容接口說明查看。
問:配置好開發環境後,國內沒有外幣卡怎麼開通 Claude 或 ChatGPT 編程訂閱?
答:可在 本站充值中心 自助選購卡密開通 Claude Code(Pro / Max) 或 ChatGPT Plus / Pro,全程無需交出帳號密碼,支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁為準。
相關教學
- DeepSeek 為什麼漲價:官方三次價格調整的時間線、官方說明與現在的價格
- DeepSeek API 開放平台怎麼充值、怎麼查餘額和用量:官方常見問題逐項整理
- DeepSeek 上下文長度與最大輸出是多少:1M 上下文、384K 輸出,超限會怎樣
- Claude 提示詞緩存(Prompt Caching)入門:緩存時間、價格倍率與命中率
參考資料
- DeepSeek API 文檔:上下文硬碟緩存 — https://api-docs.deepseek.com/zh-cn/guides/kv_cache
- DeepSeek API 文檔:模型 & 價格 — https://api-docs.deepseek.com/zh-cn/quick_start/pricing
0 條評論
還沒有評論,來搶沙發~