
結論先說
- 文件系統隱喻 + 客戶端自有存儲:啟用
memory_20250818工具後,Claude 會把/memories當成它的專屬長期筆記本進行讀寫,而底層到底存成本地文件、PostgreSQL 記錄還是雲端對象存儲,完全由你的後端代碼決定。 - 開局自動先查記憶,無需手寫冗長提示詞:只要掛載了該工具,服務端會自動向模型注入標準系統指引,讓它在處理任務前先檢查
/memories目錄有沒有歷史記錄,並在習得關鍵偏好或階段性結論時主動更新文件。 - 內置六個標準子命令:客戶端只需按約定實現
view、create、str_replace、insert、delete和rename六個分支,並通過tool_result返回文本反饋。 - 安全第一條是防目錄穿越:客戶端必須強制校驗所有目標路徑落在當前用戶的隔離
/memories根目錄內,攔截一切..或符號連結跳出行為。 - 國內免卡開通與帳號服務入口:自有帳號免上號自助開通可見本站 Claude Pro 充值頁 與 Claude Max 充值頁;缺可用帳號或遇身份核驗可查看 Claude 註冊說明 與 Claude KYC 認證協助。
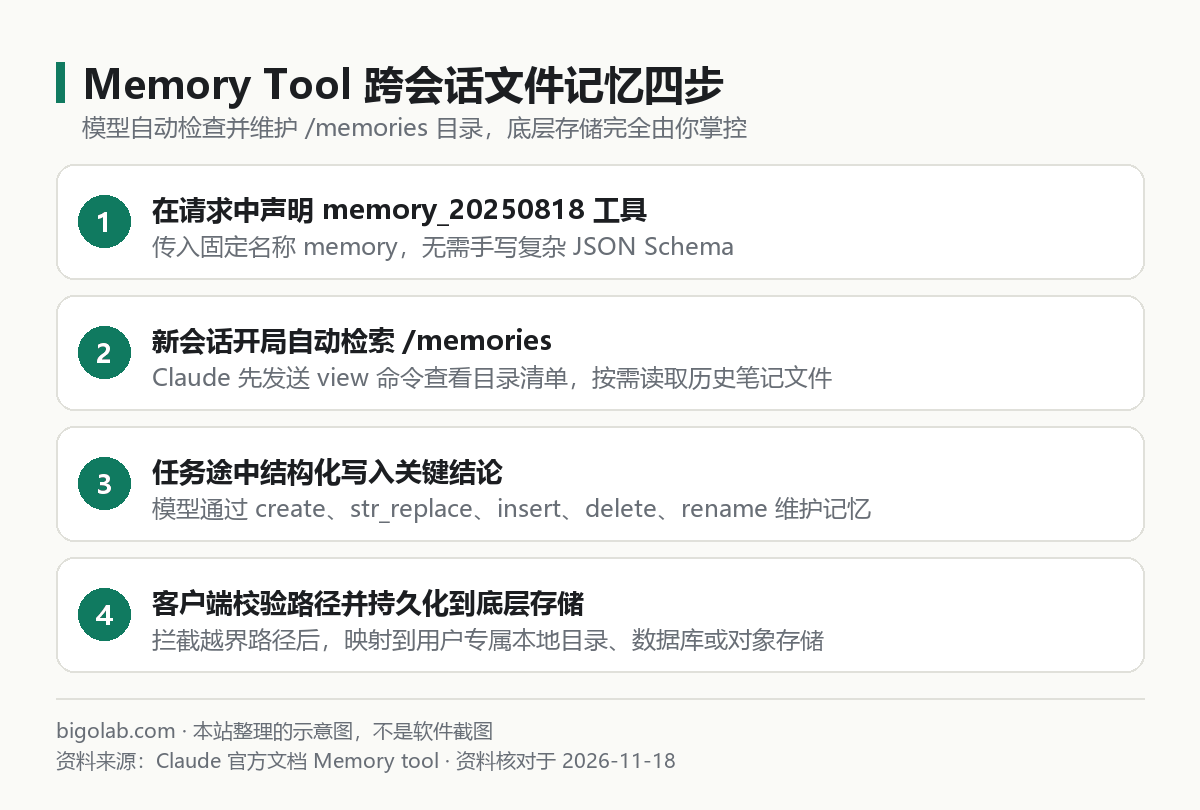
圖:本站根據 Claude 官方文檔:Memory tool 整理的示意圖
本文根據 Claude 開發者平台官方文檔《Memory tool》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 搜「claude api memory tool」「memory_20250818 怎麼用」,想給自研客服、助理或研發智能體加上跨會話長期記憶的開發者;
- 不想一上來就搭一套笨重的向量檢索(RAG)管線,希望讓模型像記 Markdown 筆記一樣自己增刪改查結構化記憶的人;
- 需要把用戶記憶完全留在自有數據庫或內網存儲裏以滿足數據合規要求的團隊。
如果你只是在 claude.ai 網頁版裏使用官方現成的個人對話記憶功能,請直接看 /guides/claude-memory。
一、最小請求寫法與 /memories 目錄約定
在 Messages API 請求裏掛載記憶工具非常簡潔,type 填 memory_20250818,name 固定填 memory(若搭配服務端上下文管理策略使用,可在 SDK 的 betas 參數中一併帶上 context-management-2025-06-27):
python
import anthropic

client = anthropic.Anthropic()

response = client.beta.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    tools=[
        {
            "type": "memory_20250818",
            "name": "memory",
        }
    ],
    messages=[
        {"role": "user", "content": "繼續幫我跟進上週的接口重構方案,記得按我習慣的測試框架寫。"}
    ],
    betas=["context-management-2025-06-27"],
)

for block in response.content:
    if block.type == "tool_use" and block.name == "memory":
        print(block.input)
發出這條請求後,模型第一反應通常是產出一個 tool_use 塊:{"command": "view", "path": "/memories"}。
這裏的 /memories 是模型視角下的邏輯虛擬根目錄,絕不是讓你真的去寫宿主伺服器操作系統的根分區 /memories。在多用戶 Web 應用裏,標準做法是在後端把它映射成 ./storage/users/{user_id}/memories/ 或數據庫裏的 (user_id, virtual_path, content) 行記錄。對模型而言它始終在操作乾淨的 /memories/preferences.md,而不同租戶的數據在物理層徹底隔離。
二、客戶端六個子命令的實現規格
和普通工具調用一樣(基礎循環見 /guides/claude-tool-use-basics),收到 name == "memory" 的調用後,你的後端需要根據 input["command"] 分發處理並返回純文本結果:
| 子命令 | 關鍵輸入參數 | 客戶端應執行的動作與返回格式 |
|---|---|---|
view | path、可選 view_range | 若是目錄,列出其下文件名與子目錄;若是文件,返回帶行號的文件內容(支持按起止行號截取) |
create | path、file_text | 在指定虛擬路徑新建或覆蓋記憶文件,成功後返回創建確認提示 |
str_replace | path、old_str、new_str | 在目標記憶文件中查找唯一匹配的 old_str 並替換為 new_str;匹配不到或多處匹配時返回 is_error: True |
insert | path、insert_line、new_str | 在第 insert_line 行之後插入新段落(0 表示插在首行前) |
delete | path | 刪除已過期的單個記憶文件或子目錄,防止舊結論干擾後續任務 |
rename | old_path、new_path | 重命名或移動記憶文件,便於模型整理目錄分類 |
如果你想讓模型只記某幾類特定資訊(例如「只記客戶的編碼規範與數據庫連接約定,不記閒聊」),可以在請求的 system 提示詞裏補充兩句業務層面的記錄準則,它會與內置的 /memories 操作習慣疊加生效。
三、路徑安全校驗與防污染清單
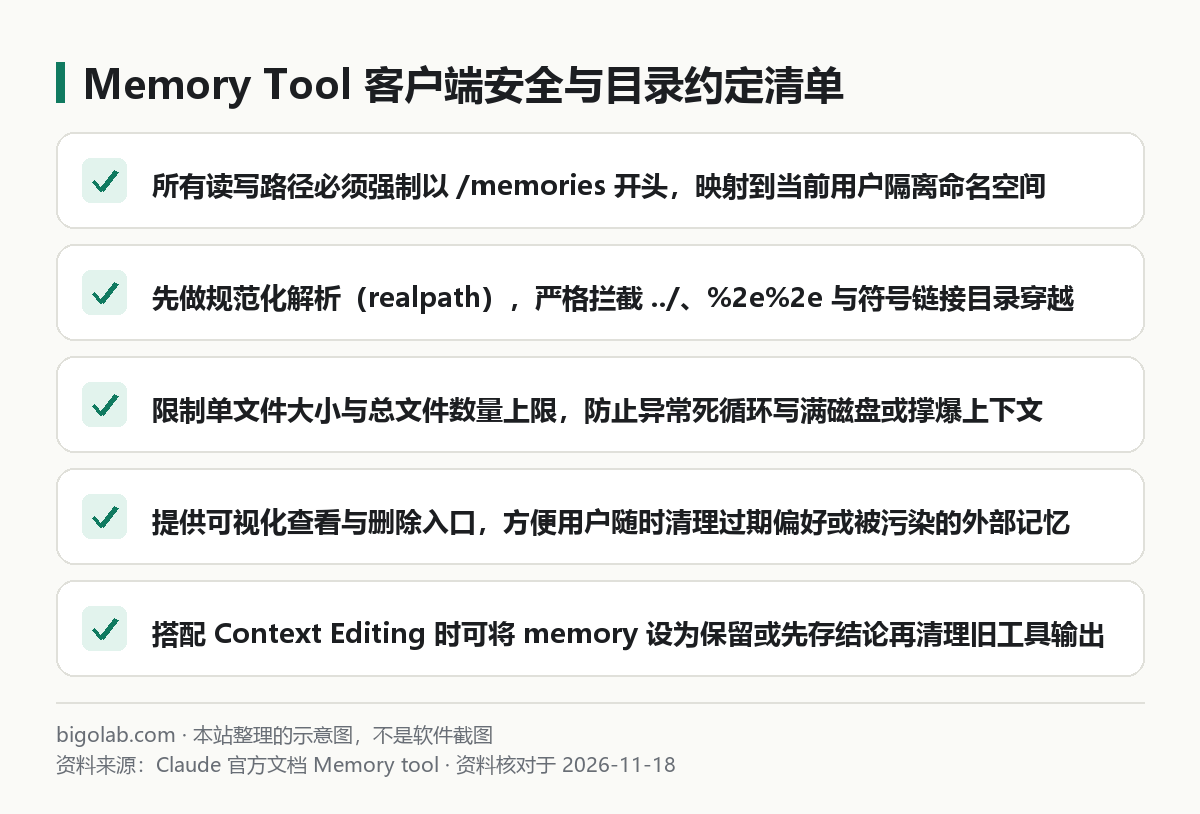
圖:本站根據 Claude 官方文檔:Memory tool 整理的示意圖
因為記憶文件一旦寫入就會在未來的新會話裏被模型自動讀回,官方文檔特別提醒開發者在客戶端做好四道防護:
- 嚴格校驗虛擬前綴與真實路徑:先檢查傳入的
path(以及rename裏的old_path和new_path)是否以/memories開頭;拼成宿主機物理路徑後再調Path.resolve(),確認解析後的絕對路徑確實位於該用戶專屬目錄之下,直接拒絕../、URL 編碼%2e%2e和軟連結越界:
python
from pathlib import Path

def resolve_safe_memory_path(user_root: Path, virtual_path: str) -> Path:
    if not virtual_path.startswith("/memories"):
        raise ValueError("Path must start with /memories")
    rel = virtual_path[len("/memories"):].lstrip("/")
    target = (user_root / rel).resolve()
    root_resolved = user_root.resolve()
    if target != root_resolved and root_resolved not in target.parents:
        raise ValueError("Path traversal blocked")
return target- 設單文件體積與總配額上限:限制單個記憶文件不超過幾十 KB、每個用戶目錄總大小受控,避免異常循環把大段原始日誌原封不動塞進
/memories; - 防範跨會話提示詞注入固化:如果智能體同時接入了聯網抓取(見 /guides/claude-api-web-search-tool)或讀取不受信任的外部電郵,惡意頁面可能誘導模型把違規指令寫進記憶文件長期潛伏。建議在前端給用戶提供「查看並編輯記憶文件」的透明面板;
- 現成開發框架選型:如果你是圍繞本地代碼倉庫做開發輔助,其實無需自己實現這套存儲層——官方命令行工具已經內置了項目指令與自動記憶機制(詳見 /guides/claude-code-getting-started),日常個人開發直接搭配 Claude Pro 訂閱 或 Claude Code 充值方案 即可開箱使用。
常見問題
問:用了 Memory Tool 之後,當前會話的上下文窗口會自動變小嗎?
答:不會直接縮小當前輪次的對話歷史。記憶工具解決的是「把關鍵結論安全存到會話外部」以及「跨會話複用」;想把當前長對話裏已經讀完的舊工具輸出清掉省 token,需要配合 Context Editing(上下文編輯)一起使用。
問:底層不想寫磁盤文件,存在關係型數據庫裏可以嗎?
答:完全可以。Claude 只關心發出的 view、create、str_replace 等命令能不能收到符合文件目錄邏輯的文本響應,後端用數據庫表模擬路徑樹反而更方便做多實例橫向擴容與備份。
問:為什麼有時新開對話模型沒有讀取某個子文件夾裏的筆記?
答:模型開局通常先 view 頂層 /memories 目錄列表,再挑文件名相關的打開細讀。建議通過系統提示詞引導模型起直觀的文件名(如 api_conventions.md),或維護一份簡短的 /memories/index.md 索引。
問:人在國內沒有外幣信用卡,怎麼訂閱或升級 Claude 付費套餐?
答:可在本站 AI 會員充值總覽頁 選擇 Claude Pro 自助充值 或 Claude Max 充值,付款後即時發卡密、24 小時自助兌換且可開具增值稅發票;實時價格與售後邊界(含封號不質保)以商品頁當天展示為準。
相關教學
- Claude 記憶功能怎麼用:開啟、查看、導入與導出記憶
- Claude Tool Use(工具調用 / Function Calling)入門:定義工具與返回 tool_result
- Claude API 聯網搜尋工具(web search tool)怎麼用
- Claude Code 中文入門教學(2026):安裝、登入、第一個任務、常用命令
參考資料
- Claude 開發者平台文檔:Memory tool — https://platform.claude.com/docs/en/agents-and-tools/tool-use/memory-tool
0 條評論
還沒有評論,來搶沙發~