
結論先說
- 預設絕不用於訓練模型:OpenAI 官方明確承諾,不會使用 ChatGPT Business 工作區中的業務數據(包括提示詞輸入、上載文件和模型輸出)來訓練或改進 OpenAI 模型。
- 數據歸屬權歸客戶組織:在法律允許的範圍內,你的組織保留對輸入內容和模型輸出內容的擁有權與控制權。
- 傳輸與存儲全程加密:數據在靜態存儲時採用 AES-256 加密,在網絡傳輸過程中採用 TLS 1.2 及以上標準加密(涵蓋 Business 下的 ChatGPT、Work 與 Codex)。
- 成員對話預設彼此隔離:每位成員有獨立的聊天與本地 Codex 歷史,除非成員主動共享連結或項目,否則工作區所有者和管理員預設看不到私人對話。
- 認清自助版的合規上限:自助 Business 不提供零數據保留(Zero Data Retention)、醫療行業 BAA 協議或自定義數據駐留地區,有這類硬要求需走 Enterprise 合同方案。
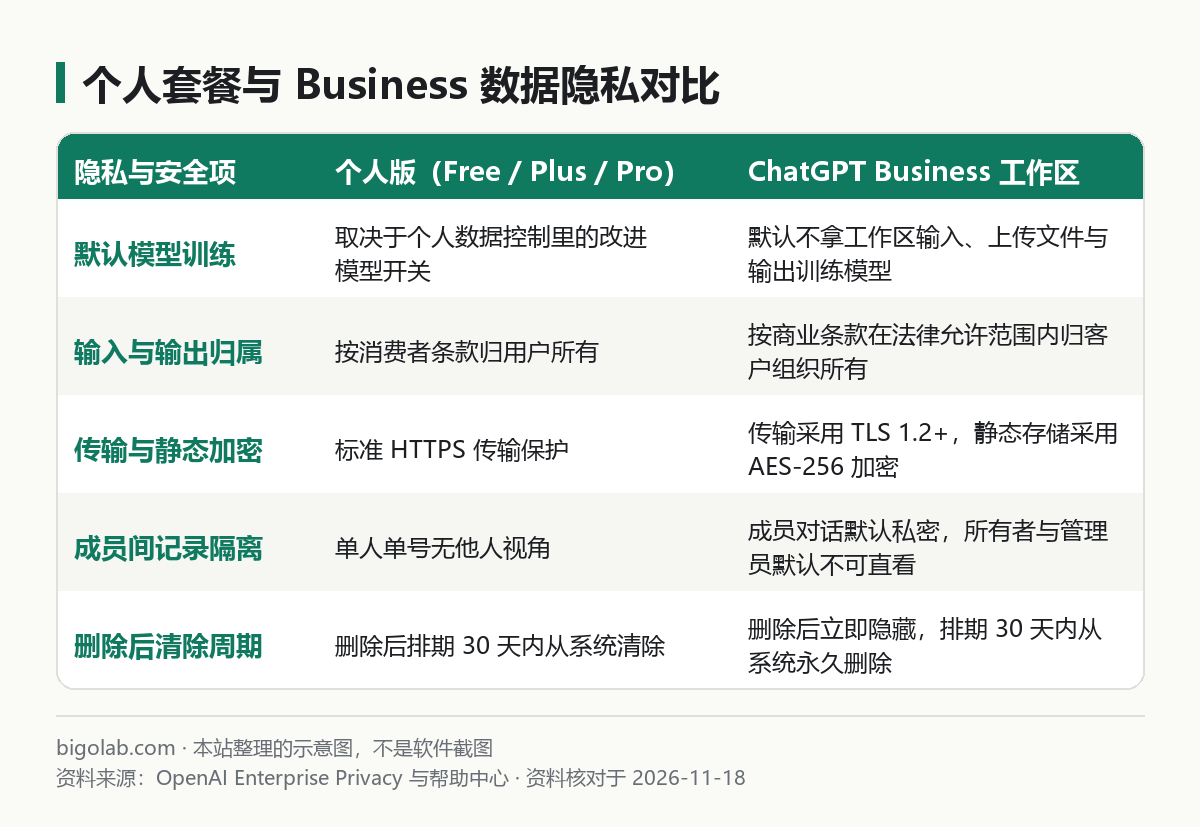
圖:本站根據 OpenAI Business Data 頁面 與幫助中心整理的示意圖
本文根據 OpenAI 官方商業數據私隱頁面(openai.com/business-data/)及幫助中心《ChatGPT Business overview》《ChatGPT Business: General FAQ》整理,資料核對於 2026-11-18。本文僅供資訊核對參考,不能代替律師的合規審查意見。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 OpenAI 官方網站。
適用於誰
- 公司準備採購團隊帳號,IT 或安全負責人追問「發進去的原始碼和業務報表會不會被拿去訓練下一代大模型」的人;
- 擔心同事或老闆能在後台直接翻看自己工作區聊天記錄的團隊成員;
- 需要核對加密標準、對話刪除清除週期,以及自助 Business 到底能不能籤 BAA 或零數據保留的人。
一、官方對「不用於訓練」的準確口徑
在個人版(Free、Plus、Pro)裏,對話會不會用於改進模型,取決於用戶自己有沒有去設定裏關掉「為所有人改進模型」開關(兩檔套餐的完整對比見 ChatGPT Business 和 Plus 區別)。
而在 ChatGPT Business(以及 Enterprise、Edu)工作區中,免訓練是組織級出廠預設規則,不需要員工逐個去點開關:
- 你在網頁和桌面端發出的文字、上載的表格與文檔、模型生成的回答,預設都不進入模型訓練池;
- 在同一 Business 工作區下使用 ChatGPT Work 與 Codex 處理代碼倉庫時,官方安全文檔同樣寫明受涵蓋服務處理的業務數據在傳輸與靜態存儲中均受加密保護,且預設不用於訓練 OpenAI 模型。
需要為公司或研發團隊開通具備預設免訓練承諾的工作區,可查看本站 ChatGPT Business 團隊版定製。
二、內部可見性、保留期限與刪除規則
除了防外部模型訓練,團隊內部也很關心「誰能看、留多久、怎麼刪」:
- 內部私隱邊界:官方概覽頁寫明,預設情況下工作區所有者(Owner)和管理員(Admin)無法在後台直接調閱普通成員的私人聊天和 Codex 會話歷史(角色權限表見 ChatGPT Business 管理員控制檯怎麼用)。只有被放進共享項目或主動分享的 GPT、對話,對應範圍內的同事才看得見。
- 保留與刪除週期:未刪除的對話會保留在工作區帳號內供成員隨時檢索。當成員手動刪除一條對話後,它會立刻從歷史介面消失,並排期在 30 天內從 OpenAI 系統中永久清除(除非因法律義務或安全濫用調查必須依法留存)。Codex 本地與雲端會話的歸檔刪除細節見 Codex 怎麼刪除對話、清理任務。
- 連接器數據的區別:如果成員在對話中連接過 Google Drive、電郵或日曆,刪除該對話會一併清掉留存在對話裏的同步數據副本,但不會改動網盤或電郵裏的原始文件;只點「歸檔」不點「刪除」則會繼續保留。
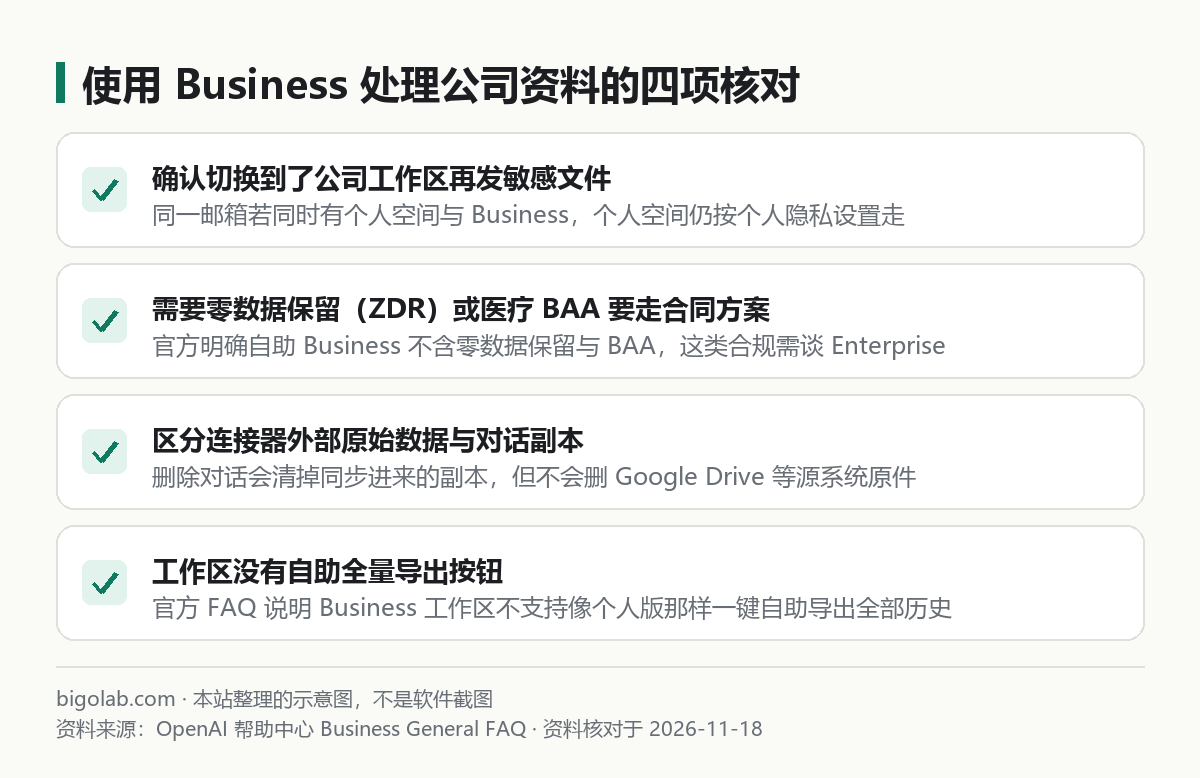
圖:本站根據 OpenAI 幫助中心:ChatGPT Business General FAQ 整理的示意圖
三、使用前必須看清的四處限制(別把個人空間混進來)
把敏感工作資料餵給 ChatGPT 之前,務必逐條核對以下四個常見盲區:
- 盲區一:發消息前沒切工作區。 如果你的電郵既保留了個人工作區,又加入了公司的 Business 工作區,留在「個人空間」裏發出的文件遵守的是個人消費者條款,不受公司 Business 免訓練條款保護。每次上載內部資料前,先瞄一眼左下角工作區名稱對不對。
- 盲區二:把個人工作區永久合併進公司。 接受邀請時若選擇了「合併(Merge)」個人空間,你原先的個人聊天和自定義 GPT 就會不可逆地轉入公司組織的控制之下。
- 盲區三:自助 Business 沒有一鍵全量導出。 官方 FAQ 明確寫明,Business 工作區不支持個人版那種自助打包導出全部聊天記錄的功能(個人版導出方法見 ChatGPT 導出聊天記錄教學)。
- 盲區四:特殊監管行業要求。 如果貴司受嚴格金融、醫療監管,必須籤商業夥伴協議(BAA)、要求伺服器端零數據保留(ZDR)、指定美國或歐盟數據駐留(Data residency),或者需要通過 Compliance API 拉取審計日誌,自助 Business 均不包含,需聯絡官方銷售改簽 Enterprise(對比見 ChatGPT 企業版 Enterprise 和團隊版 Business 有什麼區別)。
常見問題
問:Business 工作區裏成員自己建的自定義 GPT,裏面的知識庫文件會被拿去訓練嗎?
答:不會。放在 Business 工作區內的自定義 GPT 及其上載的知識庫文件同樣屬於工作區業務數據,適用預設不訓練承諾。
問:用 API Key 調接口的數據也歸 ChatGPT Business 管嗎?
答:兩套帳戶獨立計費和管理,但 OpenAI 對 Platform API 同樣預設不拿 API 請求數據訓練模型(除非組織管理員主動勾選數據共享計劃)。
問:開啟 SAML 單點登入能進一步加強工作區數據安全嗎?
答:可以。Business 支持配置 SAML SSO 與強制多因素認證(MFA),員工離職在公司統一身份系統裏停用帳號後就無法再登入工作區。
相關教學
- ChatGPT Business 和 Plus 區別
- ChatGPT Business 管理員控制檯怎麼用
- ChatGPT 企業版 Enterprise 和團隊版 Business 有什麼區別
- Codex 怎麼刪除對話、清理任務
- ChatGPT 導出聊天記錄教學
參考資料
- OpenAI 官方:Business data privacy, security, and compliance — https://openai.com/business-data/
- OpenAI 幫助中心:ChatGPT Business overview — https://help.openai.com/en/articles/8792828-chatgpt-business-overview
- OpenAI 幫助中心:ChatGPT Business General FAQ — https://help.openai.com/en/articles/8542115-chatgpt-business-general-faq
0 條評論
還沒有評論,來搶沙發~