
结论先说
- Responses API 通过
reasoning对象统一控制思考深度与摘要。核心字段为effort(常用low、medium、high,默认medium)与summary(可选auto、concise、detailed)。 - 内部推理 Token 不直接暴露原文,但按输出 Token 单价计费。可在返回结果的
usage.output_tokens_details.reasoning_tokens中精确查看本轮消耗的思考量。 max_output_tokens管的是「推理 + 可见回答」的总和。若上限设得太小,模型在内部思考阶段就会耗光配额,导致可见文本为空且status变为incomplete。- 获取
summary思考摘要无需额外付费。但部分前沿推理模型要求先在 OpenAI Platform 后台完成组织身份验证(Organization Verification)才能开启摘要返回。 - 想免写代码直接交互体验高阶推理模型,国内无外币卡用户可在本站自助开通 ChatGPT Plus 或高配额 ChatGPT Pro,企业研发团队可了解 ChatGPT Business 团队定制。
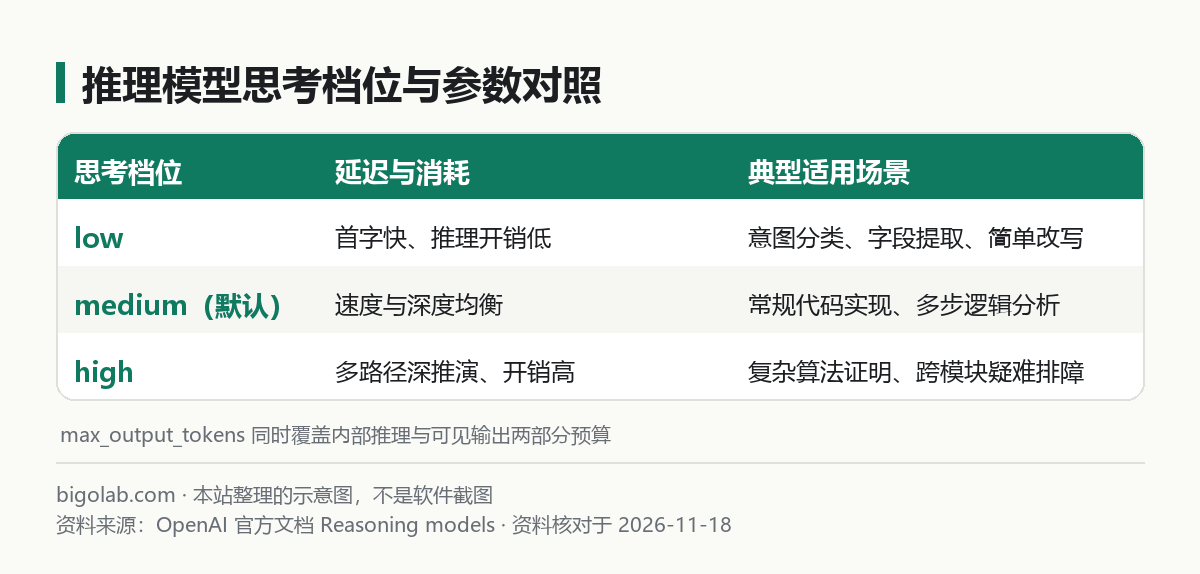
图:本站根据 OpenAI 官方文档:Reasoning models 整理的示意图
本文根据 OpenAI API 官方文档《Reasoning models》《Responses API Reference》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 在代码里调用 OpenAI 推理模型,想按任务难度平衡延迟、准确度与 Token 账单的开发者;
- 希望在前端界面展示模型「正在思考什么」,需要拉取
reasoning.summary思考摘要的人; - 遇到 API 返回 HTTP 200 但正文为空、
status显示incomplete的排查者。
一、effort 思考强度档位与两套接口写法
OpenAI 新版开发首选 Responses API(与旧接口差异见 /guides/openai-responses-api)。effort 各档位定位如下:
| 档位取值 | 思考深度与耗时 | 适用任务场景 |
|---|---|---|
low | 简短推理,首字响应快、消耗少 | 意图路由、结构化抽取、明确语法改写 |
medium(默认) | 速度与深度均衡 | 常规业务代码编写、多步逻辑问答、文档审查 |
high | 深度多路径推演,推理 Token 占比高 | 复杂算法证明、跨模块疑难排障、架构方案设计 |
注:部分新版 GPT 系列模型还支持更轻量的档位(以具体模型参考页为准);在交互终端 Codex CLI 里切换同款思考强度的做法见 /guides/codex-switch-model-reasoning-effort。若仍在维护旧版 Chat Completions 接口,对应顶层参数名为 reasoning_effort="medium"。
二、调用示例:同时读取思考摘要与正文并防截断
下面用官方 Python SDK 演示传入 reasoning 参数、预留 max_output_tokens 预算,并检查 incomplete 状态:
python
from openai import OpenAI

client = OpenAI()

resp = client.responses.create(
    model="o4-mini",
    input="请排查高并发下数据库连接池耗尽的三类常见根因,并给出连接超时配置建议。",
    reasoning=dict(effort="medium", summary="auto"),
    max_output_tokens=16000,
)

if resp.status == "incomplete":
    print("输出被截断,原因:", resp.incomplete_details.reason)

for item in resp.output:
    if item.type == "reasoning":
        for s in item.summary:
            print("[思考摘要]", s.text)

print("[正式回答]\n", resp.output_text)
print("推理消耗 Token:", resp.usage.output_tokens_details.reasoning_tokens)流式传输(stream=True)时,同样可以监听摘要增量与正文增量事件,流式基础写法参考 /guides/openai-api-streaming。
订阅与账号准备提示:调试复杂推理提示词前,很多开发者会先在网页端或 Codex 里对比不同思考档位的效果。若缺少境外支付卡,可在本站自助选购 ChatGPT Plus 会员 或大额度的 ChatGPT Pro 充值,免交账号密码即可完成卡密兑换。
三、输出为空或半截中断的排错决策
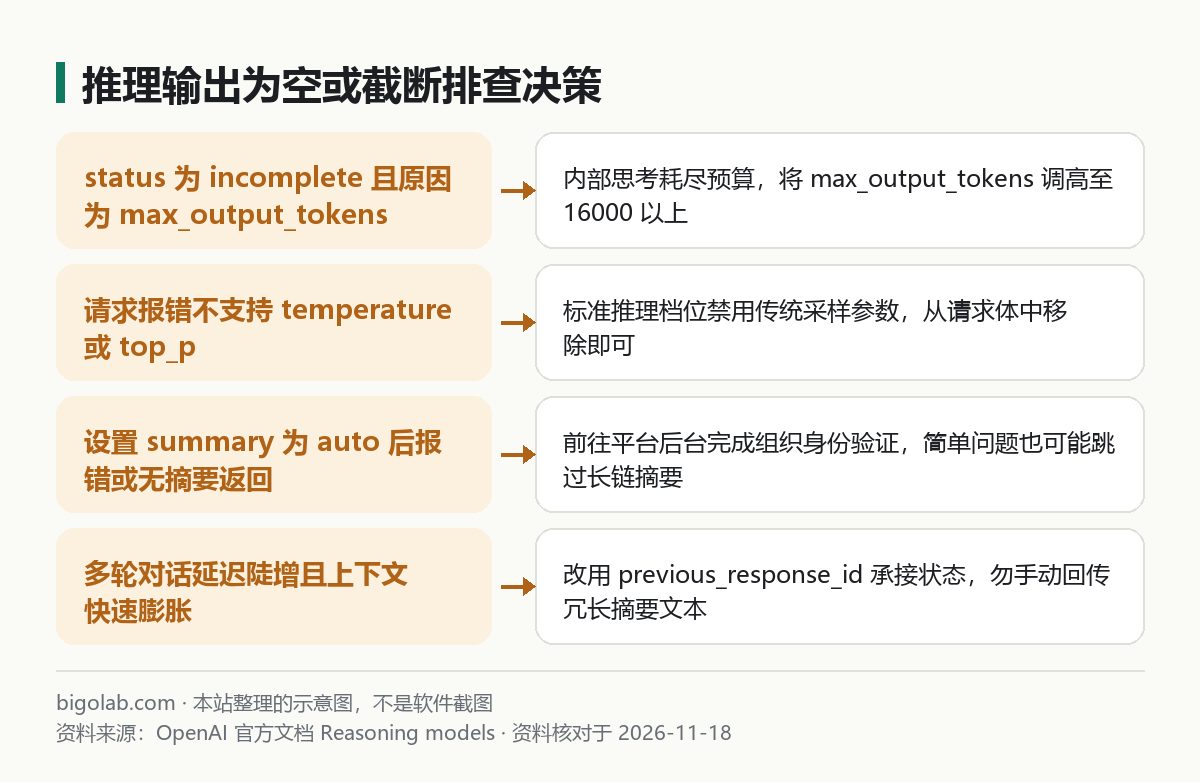
图:本站根据 OpenAI 官方文档:Reasoning models 整理的示意图
resp.output_text为空字符串且status == "incomplete":查看resp.incomplete_details.reason,若为max_output_tokens,说明你把上限(例如1024)设得太低,全被内部推理吃掉了。官方建议调试期预留至少16000至25000的上限,没用完的额度不会扣费(计费标准见 /guides/openai-api-price-official-table)。- 传了
temperature或top_p报 400 错误:标准推理模型(或在非零推理档位下)固定不支持采样温度、presence_penalty等传统采样参数,删掉即可恢复正常。 - 请求
summary="auto"报权限错误或返回空数组:登录 OpenAI Platform 进入组织设置(Settings > Organization > General)核查是否已完成组织认证;极简问题未触发长链思考时,summary数组也可能为空。 - 流式渲染时首字等待偏久:高档位(
high)推理可能需要十余秒才开始吐出第一段正文。若产品界面对白屏敏感,建议开启summary="auto"并监听流式推理摘要增量事件,先把阶段性思考摘要实时呈现在折叠面板里,能明显改善用户等待体验。 - 批量离线任务优先搭配缓存与批处理:推理模型同样享受输入提示词缓存(Prompt Caching)与 Batch API 折扣,固定不变的系统规则与参考资料应放在输入最前端以提高缓存命中率。
常见问题
问:把 max_output_tokens 设成 25000 会不会每次都按两万五千个 Token 扣钱?
答:不会。max_output_tokens 只是安全上限刹车,实际账单只按本轮真实生成的「推理 Token + 可见输出 Token」数量结算。
问:多轮对话时要不要把上一轮的思考摘要拼回 input 传给下一轮?
答:不需要手动拼摘要文本。使用 Responses API 时直接传入 previous_response_id=resp.id,服务端会自动承接上下文与必要的推理状态。
问:国内没有外币卡,或者公司需要开增值税发票报销,怎么开通 ChatGPT 会员配合开发?
答:可通过本站 AI 会员充值总览 选购 ChatGPT Plus 或 ChatGPT Pro,支持支付宝、微信支付与 AlipayHK,支持卡密自助兑换与企业定制,并可开具增值税发票。实时价格以页面显示为准;售后遵循掉订阅按剩余天数折退、封号不在质保范围的规则。
相关教程
- OpenAI Responses API 是什么:和 Chat Completions 的区别
- OpenAI API 价格表与长上下文计费说明
- OpenAI API 流式输出(streaming)怎么写
- Codex 怎么切换模型和思考强度
参考资料
- OpenAI API 官方文档:Reasoning models — https://platform.openai.com/docs/guides/reasoning
- OpenAI API 官方文档:Responses API Reference — https://platform.openai.com/docs/api-reference/responses
0 条评论
还没有评论,来抢沙发~