
结论先说
- OpenAI 提供两套原生语音对话路线:回合制 HTTP(
gpt-audio)与全双工流式(Realtime API)。前者像微信发语音条,复用普通 REST 后端即可接入;后者像打电话,走 WebRTC 或 WebSocket 支持边听边说和随时打断。 gpt-audio一次请求同时返回语音字节流与配套文字稿。只需将modalities设为["text", "audio"]并指定audio音色与编码格式,无需自己串联三段独立接口。- 流式与非流式支持的音频格式不同。一次性非流式返回可直接要
wav或mp3;开启stream=True低延迟边收边播时,输出格式需指定为无头部的pcm16。 - 若业务完全不需要情绪感知,拆成「转写 + 文本模型 + TTS」往往更省成本。纯文字链路便于中间审核与检索落库。
- 想先在手机或电脑端体验官方原生实时语音效果,国内缺少境外银行卡的用户可在本站自助开通 ChatGPT Plus 或高配额 ChatGPT Pro,企业团队可咨询 ChatGPT Business 团队定制。
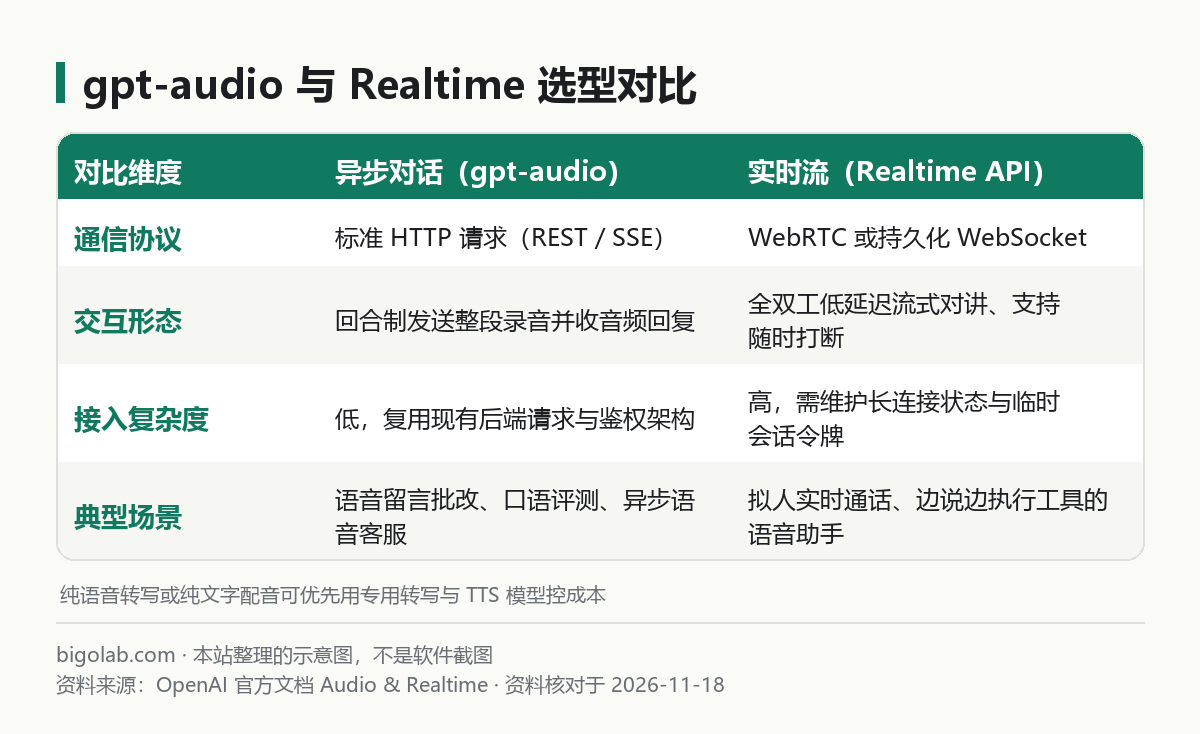
图:本站根据 OpenAI 官方文档:Audio and speech 整理的示意图
本文根据 OpenAI API 官方文档《Audio and speech》《Realtime API》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 想在小程序、App 或网页里做「按住说话发语音、AI 语音加文字回消息」功能,纠结选 HTTP 接口还是 WebSocket 实时流的开发者;
- 希望模型直接感知用户录音里的语气、停顿与情绪,而不是先转纯文字丢掉声音细节的人;
- 调用
gpt-audio系列模型时遇到流式音频格式报错或多轮历史拼装失败的排查者。
一、三种官方音频方案怎么选
结合站内已整理的转写配音(见 /guides/openai-api-speech-to-text-text-to-speech)与实时会话(见 /guides/openai-api-realtime),选型对照如下:
| 方案名称 | 网络协议 | 核心优势 | 适用产品形态 |
|---|---|---|---|
gpt-audio 异步对话 | 标准 HTTP / SSE | 接入简单,原生听懂语调并同步出音字 | 口语发音纠错、异步语音留言问答、绘本伴读 |
| Realtime API | WebRTC / WebSocket | 毫秒级双向对讲、内置语音活动检测与打断 | 实时口语陪练、车载语音副驾、电话客服机器人 |
| 转写 + 文本 + TTS 串联 | 标准 HTTP | 中间文本可人工干预修改,单价容易精细拆分 | 会议纪要(参考 /guides/chatgpt-audio-transcription)、长文章朗读 |
只要你的交互界面有明确的「松开发送」动作、不需要用户在 AI 说话中途插嘴打断,优先用 gpt-audio 可以省去维护长连接网关的运维负担。
二、gpt-audio 音频输入与输出 Python 示例
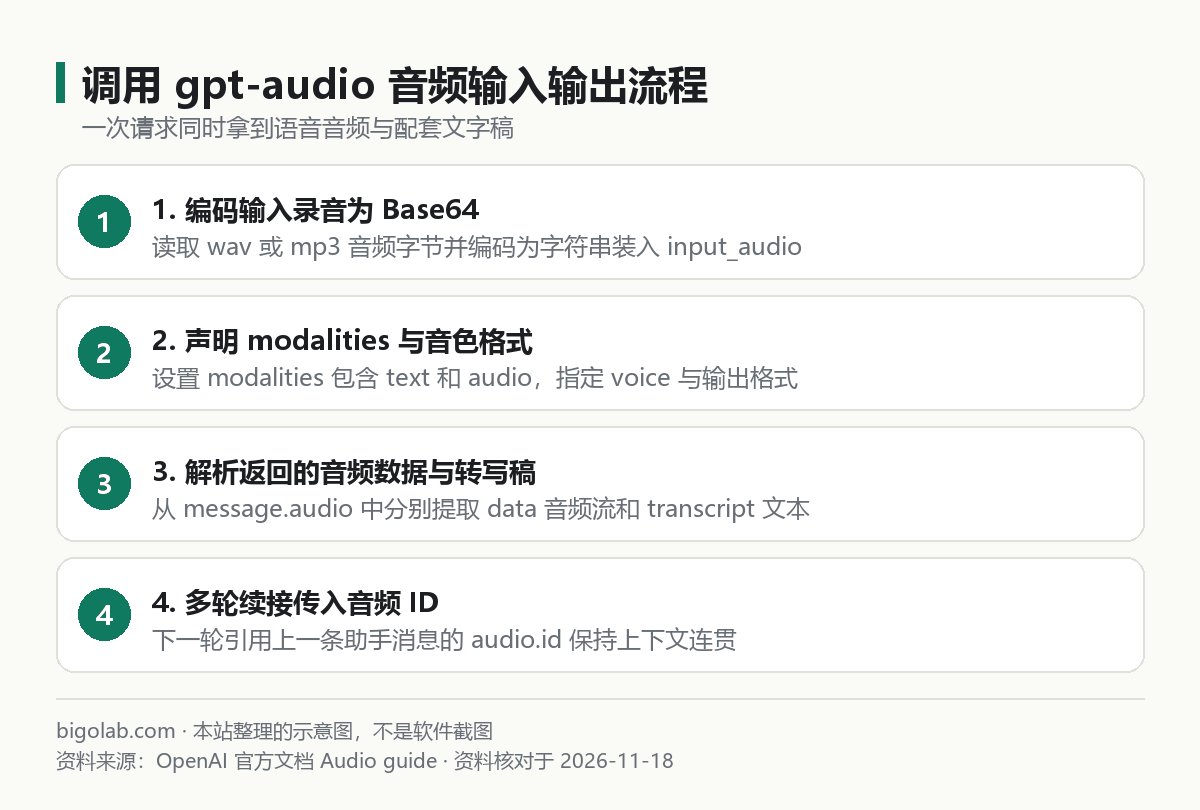
图:本站根据 OpenAI 官方文档:Audio and speech 整理的示意图
下面演示将本地用户提问录音 .wav 编码后传给 gpt-audio,并把模型回复的语音存盘、文字打印出来:
python
import base64
from pathlib import Path
from openai import OpenAI

client = OpenAI()

raw_audio = Path("question.wav").read_bytes()
b64_input = base64.b64encode(raw_audio).decode("utf-8")

resp = client.chat.completions.create(
    model="gpt-audio",
    modalities=["text", "audio"],
    audio=dict(voice="alloy", format="wav"),
    messages=[
        dict(
            role="user",
            content=[
                dict(type="text", text="请听这段英语口语录音,用中文指出语法和重音问题并示范正确读法。"),
                dict(type="input_audio", input_audio=dict(data=b64_input, format="wav")),
            ],
        )
    ],
)

msg = resp.choices[0].message
print("文字转写稿:", msg.audio.transcript)
Path("reply.wav").write_bytes(base64.b64decode(msg.audio.data))
print("本轮音频标识:", msg.audio.id)
若只需要「听录音回纯文字」(比如客服录音质检打分),把 modalities 改为 ["text"] 并去掉顶层 audio 参数即可,省去音频输出 Token 开销(价格规则见 /guides/openai-api-price-official-table)。
订阅与账号准备提示:音频 Token 单价显著高于纯文本 Token,个人日常练口语或做外语模拟面试直接用官方客户端语音模式更划算。国内用户可在本站开通 ChatGPT Plus 会员 或更高配额的 ChatGPT Pro 充值,支持卡密自助兑换。
三、多轮上下文续接与常见报错注意事项
- 多轮对话传
audio.id而非重传整段 Base64:进行第二轮追问时,把上一轮助手消息按dict(role="assistant", audio=dict(id=msg.audio.id))追加进messages数组即可(服务端缓存的音频引用有存活时限,过期后可回退为传transcript文本)。 - 开启流式
stream=True报格式不支持:流式分块传输无法提前写入wav文件头的总长度字节,因此官方规定流式下audio.format必须填pcm16,客户端按采样率直接送入声卡缓冲区播放。 - 输入音频格式限制:
input_audio.format目前主要接受wav与mp3;如果前端手机浏览器录出的是webm或m4a,需先在服务端用ffmpeg转封装后再编码传入。
常见问题
问:gpt-audio 支持在对话中途调用外部函数(Function Calling)吗?
答:支持。和常规文本对话一样传入 tools 定义即可;当模型判定需要查天气或查订单时,会先返回 tool_calls,你回传工具执行结果后,它再用自然语音把查询结果播报出来。
问:有哪些官方内置音色(voice)可以选?
答:官方提供 alloy、ash、ballad、coral、echo、sage、shimmer、verse 等多款预设音色,具体可用音色列表以官方文档当天展示为准,建议在业务里固定同一款音色保持人设一致。
问:国内没有外币卡,或者公司需要开增值税发票报销,怎么开通官方 ChatGPT 订阅体验高级语音?
答:可通过本站 AI 会员充值总览 选购 ChatGPT Plus 或 ChatGPT Pro,支持支付宝、微信支付及 AlipayHK,支持卡密自助兑换与企业定制,并可开具增值税发票。实时价格以页面显示为准;售后遵循掉订阅按剩余天数折退、封号不在质保范围的规则。
相关教程
- OpenAI API 语音转文字和文字转语音怎么调
- OpenAI Realtime API 是什么:WebRTC 与 WebSocket 会话
- ChatGPT 音频转文字:上传录音生成文字稿
- OpenAI API 价格表与计费说明
参考资料
- OpenAI API 官方文档:Audio and speech — https://platform.openai.com/docs/guides/audio
- OpenAI API 官方文档:Realtime API — https://platform.openai.com/docs/guides/realtime
0 条评论
还没有评论,来抢沙发~