
结论先说
- 额度掉得快,核心原因是「上下文滚雪球 + 高推理隐藏 Token + 高速倍率」三重叠加。Codex 并不是按「发了几条消息」固定扣次,而是按实际消耗的 Token 综合核算;每一轮新提问都会把历史聊天与前几轮粘贴的整屏报错日志重新送进模型,高推理档位的内部思考链也全部计入用量。
- 先调「模型档位」与「推理强度」立竿见影。改字段、写常规单测、补文档这类确定性任务,没必要常驻旗舰模型配
high/xhigh推理;平时默认设为中等或轻量模型加low/medium强度,遇到跨模块架构重构再临时拉高。 - 非紧急上线别常开 Fast / Ultrafast 加速模式。高速推理模式调用高优算力通道,会显著加快配额折算消耗;日常编码切回标准速度模式,省下来的额度最直观。
- 养成「一件事一个会话」习惯,长对话及时
/compact或/new。不要在同一个窗口里从周一聊到周五,也不要让测试命令吐出上万行完整日志塞满上下文。 - 如果你日常就是全天候重度编码,省流之外更适合直接匹配更高配额套餐。国内缺少外币卡的用户可在本站自助开通 ChatGPT Plus 或直接升级高配额 ChatGPT Pro,团队多人研发可了解 ChatGPT Business 团队定制。
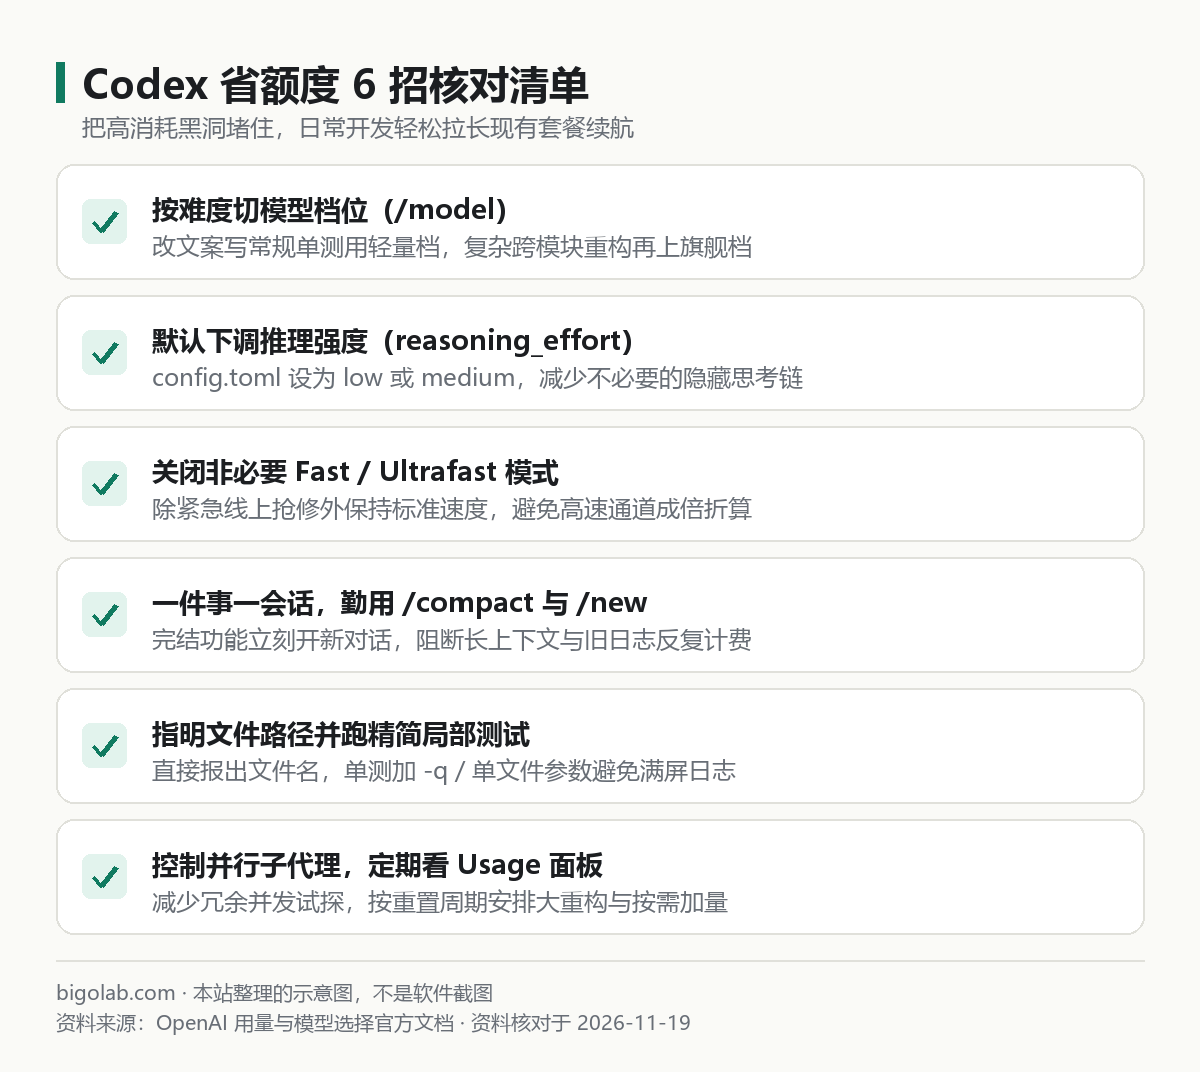
图:本站根据 OpenAI 帮助中心:Using Codex with your ChatGPT plan 与用量文档整理的示意图
本文根据 OpenAI 帮助中心《Using Codex with your ChatGPT plan》《Paid weekly Work and Codex rate limit resets》《Managing usage in Work and Codex》及 Codex 官方模型与速度配置文档整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 平时用 ChatGPT Plus 或 Pro 跑 Codex CLI / 桌面端,经常才开发两三个小时就触发 5 小时滚动限额或周限额的开发者;
- 不清楚为什么问了没几句简单问题、额度条就掉了一大截,想摸清隐藏消耗项的用户;
- 希望在尽量不牺牲代码质量的前提下,把现有订阅额度拉长用足两倍以上的人。
一、先看清为什么同样写代码,有人额度掉得快三倍
OpenAI 官方用量文档指出,Codex 的周期额度由多维因素共同决定:输入上下文体积、模型输出与隐藏思考链长度、所选模型与速度档位,以及是否开启了多并发子代理。以下三种习惯是最常见的「隐形偷跑黑洞」:
- 黑洞 1:拿高强度推理干杂活。开着
high或xhigh让它改一个按钮文案、重命名两个变量,模型内部会生成数千个隐藏推理 Token 反复验证,实际输出只有五行,扣掉的额度却堪比一次中型重构。 - 黑洞 2:一条超长会话撑满上下文。比如在会话第 2 轮让它跑了一次全量构建,日志吐了 3000 行;之后你在同一窗口继续问 20 轮小问题,这 3000 行垃圾日志和几十轮历史 Diff 会被反复携带计费。关于超大上下文窗口的利弊可对照 /guides/codex-app-context-window-1m-setting。
- 黑洞 3:常开高速模式 + 同时起多个子代理。高速模式叠加多路并发子任务,短时间内会把 5 小时滑动窗口直接打穿,迅速触发限流报错(若已遇 429 限流可看 /guides/codex-exceeded-retry-limit-429-too-many-requests)。
二、把额度省出一倍以上的 6 招实操
结合官方模型、速度与配置选项,本站建议将以下 6 招落地成日常固定动作:
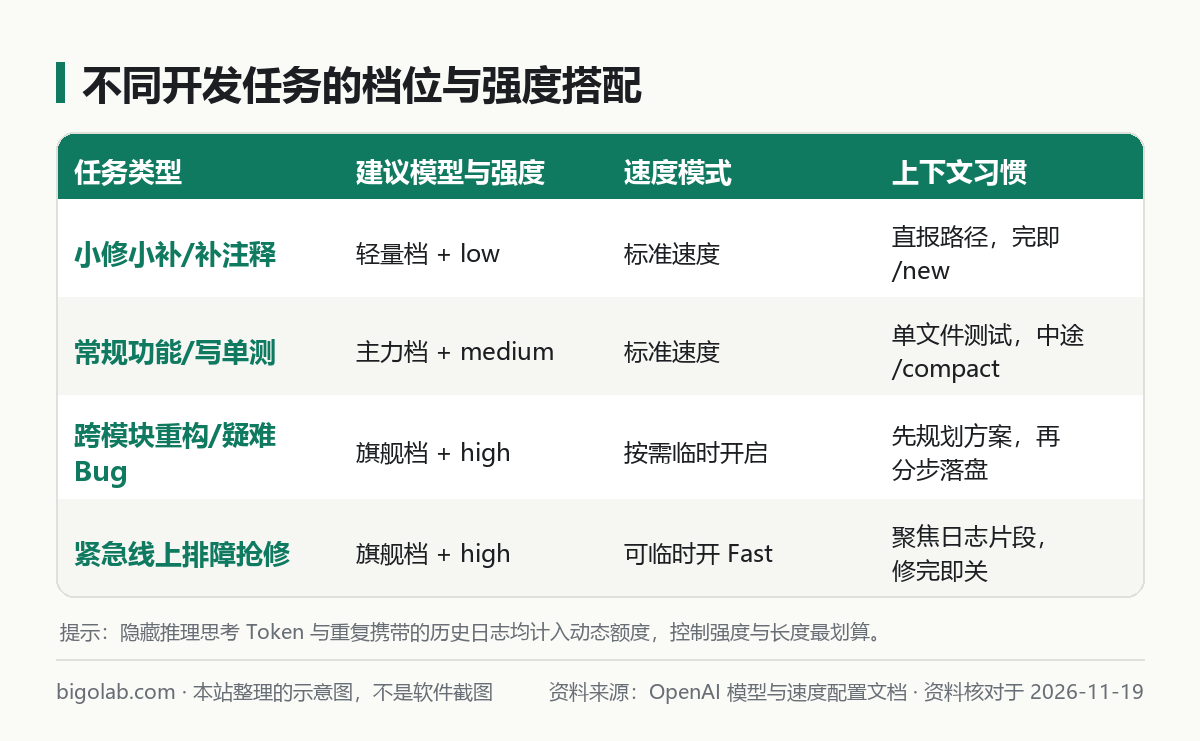
图:本站根据 OpenAI 官方文档:Model selection 与速度说明整理的搭配示意图
第 1 招:按任务复杂度动态切模型档位
在 CLI 中随时输入 /model(或在桌面端输入框下方下拉切换),做到「简单活交轻量档、硬骨头交旗舰档」。也可以把日常主力档位直接写进 ~/.codex/config.toml 作为省流默认值,完整切换方式可看 /guides/codex-switch-model-reasoning-effort。
第 2 招:把默认推理强度降到 low 或 medium
在 ~/.codex/config.toml 中显式设定默认推理强度,避免每次启动都吃满高推理档位:
toml
# 日常编码默认保持中等推理,兼顾准确度与配额消耗
model_reasoning_effort = "medium"
遇到确实棘手的并发死锁、复杂 SQL 调优或全链路设计时,再在单次命令里临时拉高:
bash
codex -c model_reasoning_effort=high
第 3 招:关闭非必要 Fast / Ultrafast 加速模式
Fast / Ultrafast 模式的价值在于缩短交互等待延迟,但会加快配额消耗速率。在桌面端设置或 CLI 配置里检查当前速度模式,除紧急线上救火或演示场景外,日常开发保持标准速度(Standard),把省出来的 Token 预算留给真正需要深度思考的轮次。
第 4 招:善用 /compact 压缩,换任务立刻 /new
不要舍不得清对话。当一个子功能已经完成、测试通过并提交 Git 后,直接敲 /new 开启空白会话,让上下文归零;如果单个大任务做到一半上下文明显变沉,先敲 /compact 把前面几十轮探索日志浓缩成精简摘要再继续。常用斜杠命令速查见 /guides/codex-cli-commands-cheatsheet。
第 5 招:精准投喂路径与精简命令输出(本站建议)
- 提问直接报出目标文件路径:写「修改
src/services/order.ts中的calcDiscount函数」比写「帮我找一下订单折扣计算逻辑并改掉」能省下模型四五轮全仓grep和读无关文件的消耗。 - 单测与报错输出加安静参数:要求 Codex 优先跑单文件精简模式(如
pytest tests/test_order.py -q --tb=short或pnpm vitest run src/order.test.ts),不要动辄跑全仓测试把几千行通过日志塞进上下文。
第 6 招:节制并行子代理,善用用量面板监控节奏
开启多路并行子代理或云端批量任务前,先确认是否真有必要同时试探多种方案;平时养成在 Settings → Usage 或 CLI /status 里看一眼剩余额度与重置时间的习惯,合理错开高频重度任务。关于周期重置机制与额度构成详解,请对照 /guides/codex-usage-limits。
排障与订阅提示:如果你的工作流本身就是全天高频用 Codex 改大型项目、跑并发任务,单靠省流仍会感到 Plus 额度捉襟见肘。建议直接按需选择 ChatGPT Pro 5x iOS 可覆盖档 或更高裕度的 ChatGPT Pro 20x iOS 可覆盖档;新账号首次手机验证受阻也可参考 Codex 注册手机验证服务。
三、真的触达上限了怎么办:补充 Credits 与升级决策
当本周确实赶上版本发版、连省流 6 招都压不住用量时,有两个合规出口可选:
- 临时偶发缺口:个人套餐用户可了解官方灵活加量点数(Credits)机制,应对单周突击峰值,详见 /guides/chatgpt-credits-extra-usage-what-is-how-to-buy。
- 长期高频刚需:如果几乎每周都在撞限额红线,长期零散加购反而划不来,直接切到高配额 Pro 套餐或团队版更省心,无需每次干活都盯着进度条算着省。
常见问题
问:我把推理强度从 high 降到 medium,代码质量会明显变差吗?
答:对于需求清晰、接口明确、改动范围在 1 到 5 个文件内的日常开发,medium 与 high 的一次通过率差距很小,但速度更快且额度消耗明显更低。真正需要把 high / xhigh 拉满的,是需求模糊的跨模块重构、疑难底层 Bug 排查和复杂并发设计。
问:是不是对话越短越省,那我把 AGENTS.md 写得很长会不会每轮都扣很多额度?
答:会的。AGENTS.md 每次启动会话都会作为基础指令注入上下文;如果根目录规则文件动辄贴入上万字过时文档,每轮都会白白吃掉大量输入 Token。保持根目录 AGENTS.md 精炼在几百字核心命令与约定内,既省额度又能提高指令遵循度。
问:国内没有外币卡,或者 Plus 额度不够想升级 Pro / 团队版怎么办理?
答:可前往本站 AI 会员充值总览 按需选购 ChatGPT Plus(含 Plus iOS 可覆盖版)或高配额 ChatGPT Pro,团队多人研发亦可选择企业定制方案。支持支付宝、微信支付及 AlipayHK,提供免交密码卡密自助兑换并支持开具增值税发票,价格以商品页实时展示为准;售后遵循掉订阅按剩余天数折退、封号不在质保范围的说明。
相关教程
- Codex 额度上限与重置规则完全解读
- Codex 怎么切换模型与调节推理强度
- ChatGPT / Codex Credits 灵活加量额度是什么及怎么买
- Codex 报 exceeded retry limit / 429 限流怎么办
- Codex 桌面端 1M 超长上下文设置与使用注意
参考资料
- OpenAI 帮助中心:Using Codex with your ChatGPT plan — https://help.openai.com/en/articles/11369540-using-codex-with-your-chatgpt-plan
- OpenAI 帮助中心:Paid weekly Work and Codex rate limit resets — https://help.openai.com/en/articles/20001507-paid-weekly-work-and-codex-rate-limit-resets
- OpenAI 帮助中心:Managing usage with GPT-6 Astra in Work and Codex — https://help.openai.com/en/articles/20001516-managing-usage-with-gpt-6-astra-in-work-and-codex
- OpenAI ChatGPT Learn:Model selection — https://learn.chatgpt.com/docs/model-selection
- OpenAI ChatGPT Learn:Speed configuration — https://learn.chatgpt.com/docs/agent-configuration/speed
0 条评论
还没有评论,来抢沙发~