
结论先说
- Plan Mode(规划模式)的核心价值是「只读勘察 + 输出方案 + 人工拍板」。在交互终端里输入
/plan或按Shift + Tab即可切换,模型会先检索仓库并输出结构化实施蓝图,不会在方向未确认前擅自改写源码。 - 若会话里找不到
/plan,先检查特性开关。在~/.codex/config.toml的[features]段确认开启collaboration_modes = true并重启 CLI,即可解锁规划协作模式。 model_verbosity管「说多细」,model_reasoning_effort管「想多深」。前者提供low、medium、high三档控制回复文字详略,后者控制推理投入深度,两者可独立组合,不要混为一谈。- 规划阶段调高详略度与推理深度,执行阶段切回精简档最省心。通过
config.toml的[profiles]或命令行-c临时覆盖,既能把架构风险讲透,又能在批量改代码时省去冗余解释。 - 开启高推理强度叠加高详略度方案评审会消耗更多上下文额度。国内无外币银行卡的用户,可在本站自助开通 ChatGPT Plus 或高配额的 ChatGPT Pro,团队协作可了解 ChatGPT Business 团队定制。
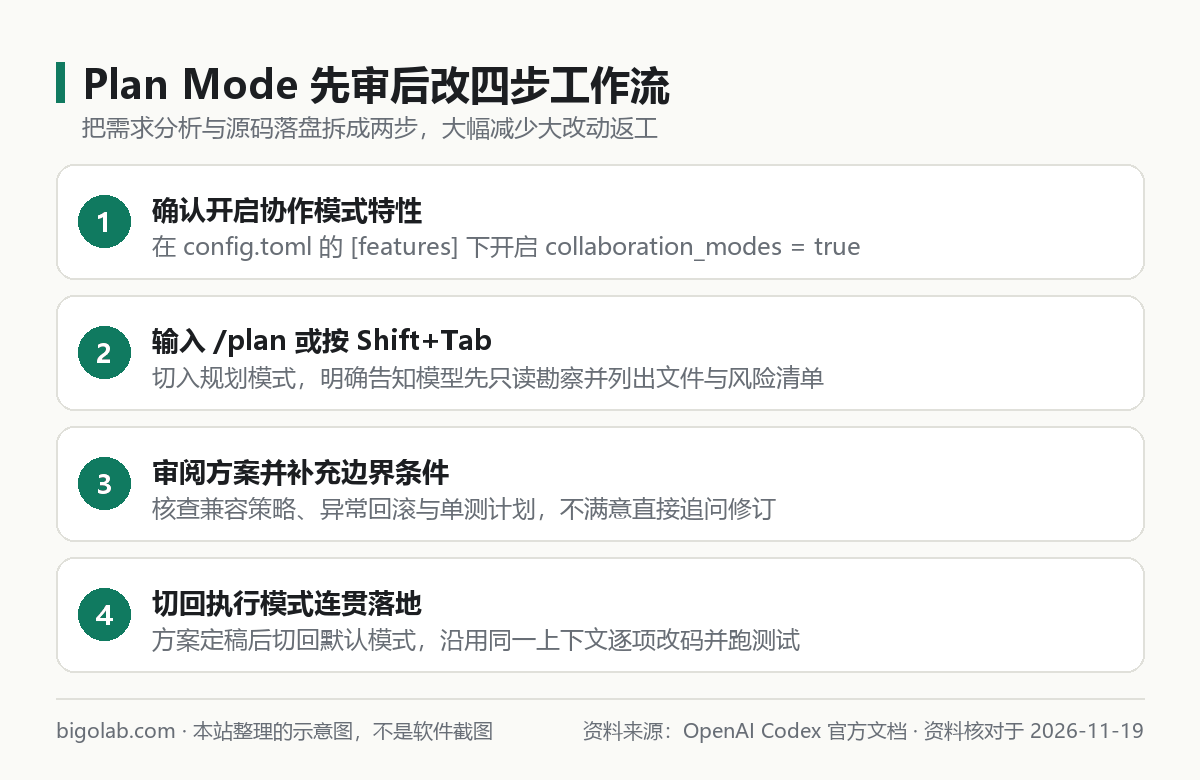
图:本站根据 OpenAI Codex 官方文档:Slash commands 整理的示意图
本文根据 OpenAI Codex 官方文档《Config reference》《Model selection》《Slash commands》整理,资料核对于 2026-11-19。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 遇到跨模块重构、数据库迁移或接口升级时,希望 Codex 先给出完整改动清单经人工审定后再动代码的开发者;
- 觉得模型平时回复解释太长、刷屏占视野,或者写方案时又太简略看不清风险边界的 Codex CLI 用户;
- 希望把「深度设计阶段」与「快速执行阶段」做成可一键切换的配置档以兼顾质量与额度的工程师。
一、开启并使用 Plan Mode:先审方案再动手改代码
直接让代理「把支付回调重构一下」,模型往往立刻开始修改七八个文件,等改到一半才发现它理解错了状态机流转,返工成本极高。换成 Plan Mode 后,开发节奏会变成可控的四步闭环:
1. 确认特性开关(如默认未启用)
打开 ~/.codex/config.toml(配置结构说明见 /guides/codex-config-toml-complete-guide),确认包含以下段落:
toml
[features]
collaboration_modes = true
2. 在交互会话中进入规划模式
启动 codex 后,在输入框直接键入 /plan,或按下 Shift + Tab 切换到 Plan Mode(更多快捷键与斜杠命令见 /guides/codex-cli-commands-cheatsheet)。
输入需求时,建议顺手明确希望方案里包含的检查维度,例如:
text
请先梳理订单状态从待支付到已退款的现有调用链,给出涉及修改的文件列表、数据兼容风险与单测补充计划,先不要修改文件。
3. 审核、追问并切换回执行模式
Codex 会先只读浏览仓库,在专门的规划视图中列出分步方案;若发现某一步遗漏了灰度兼容或幂等校验,直接继续在规划模式下追问修正。确认方案无误后,再切回默认执行模式让它按核定好的清单逐项落盘并跑通测试。
二、model_verbosity 回复详略度设置与三档选型
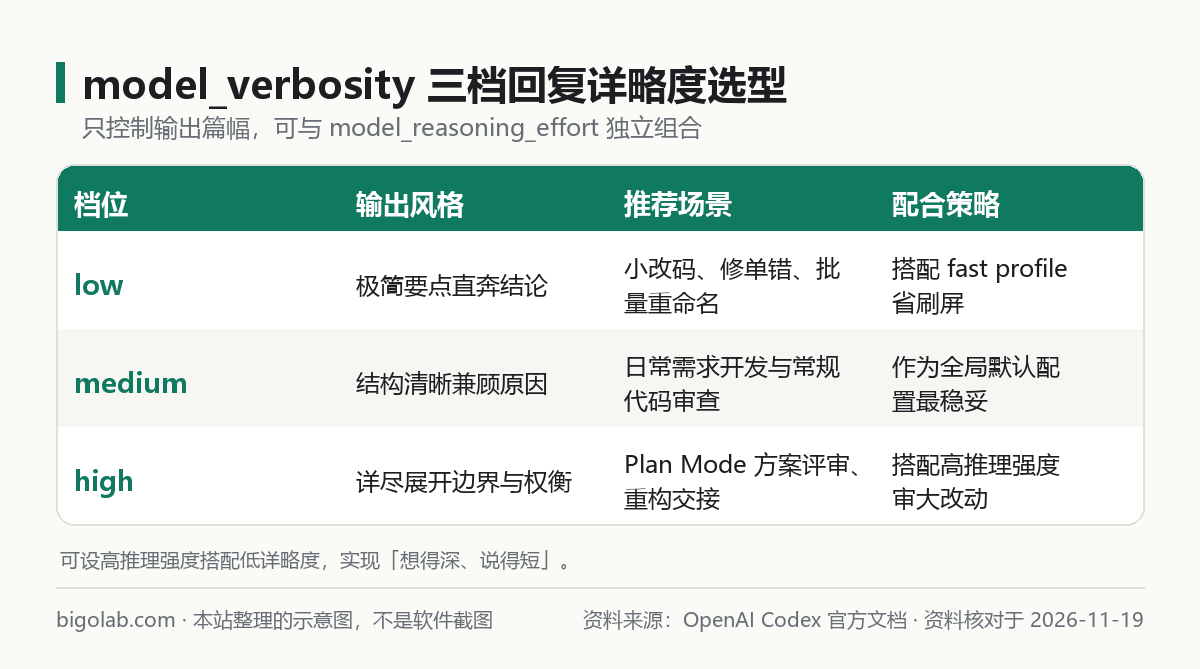
图:本站根据 OpenAI Codex 官方文档:Config reference 整理的示意图
在支持的 GPT 系列模型中,model_verbosity 专门决定模型回复的展开程度。把它和 model_reasoning_effort(切换方式见 /guides/codex-switch-model-reasoning-effort)区分开来,配置会清晰很多:
| 配置档位 | 回复文字风格 | 典型适用场景 | 额度与阅读成本 |
|---|---|---|---|
low | 极简要点,只给结论与变更摘要 | 批量机械修改、修小报错、终端窄屏速览 | 输出最短,响应快且省额度 |
medium | 平衡清晰,附带关键原因与核对项 | 日常功能开发、常规代码审查与单测编写 | 默认均衡选择,适合多数任务 |
high | 详尽展开,写清权衡、边界与影响面 | 架构评审、Plan Mode 方案定稿、交接文档 | 输出篇幅长,建议按需开启 |
1. 全局配置与单次临时覆盖
在 ~/.codex/config.toml 顶层可直接设定日常默认档位:
toml
model_verbosity = "medium"
model_reasoning_effort = "medium"
如果平时保持精简,只在本次做重要架构评审时想让模型写得更细致,启动时用 -c 临时提升即可:
bash
codex -c model_verbosity="high" -c model_reasoning_effort="high"
在运行中的交互会话里,切入 Plan Mode 后也可以通过 /model 单独调整规划阶段的推理投入,避免和日常执行阶段互相牵制。
订阅与账号准备提示:在 Plan Mode 里用高推理深度配合model_verbosity = "high"连续推演大型仓库,单轮消耗会明显高于普通改码(配额规则见 /guides/codex-usage-limits)。若 Plus 档在方案设计密集期容易限速,可在本站升级 ChatGPT Pro 充值 或选用 ChatGPT Pro 5x iOS 可覆盖档;新注册账号若遇到手机短信验证受阻,可查看 Codex 注册手机验证服务。
三、本站建议:用双 Profile 分离「审方案」与「快执行」
如果每天既要做复杂技术方案又要改大量常规前端或脚本代码,反复手动敲 -c 参数很繁琐。本站建议在 ~/.codex/config.toml 里建两组配置档,按场景一键切换:
toml
# 默认走均衡配置
model_verbosity = "medium"
model_reasoning_effort = "medium"

[profiles.plan]
model_verbosity = "high"
model_reasoning_effort = "high"

[profiles.fast]
model_verbosity = "low"
model_reasoning_effort = "low"- 做跨模块设计、排疑难并发 Bug 时,运行
codex --profile plan,进入后按Shift + Tab进 Plan Mode,把边界条件与回滚方案全部审透; - 方案敲定后做常规样式微调、补注释或简单重命名时,运行
codex --profile fast,回复直奔结果不刷屏,也能把额度留给真正难的决策环节。
常见问题
问:把 model_verbosity 调成 low,会让 Codex 写出来的代码质量变差吗?
答:不会直接等同于降低思考深度。model_verbosity 主要压缩模型对外解释和叙述的篇幅,真正决定深层推理投入的是 model_reasoning_effort。你完全可以配置 model_reasoning_effort = "high" 搭配 model_verbosity = "low",让它想得深但说得短。
问:在 Plan Mode 里审完方案后,需要把整段方案复制出来重开会话吗?
答:不需要。在同一会话内从 Plan Mode 切回执行模式后,刚刚审核定稿的计划仍在当前上下文中,直接回复「按上述方案开始实施」即可连贯落地,避免上下文断层。
问:国内没有外币信用卡,或者研发团队需要开增值税发票报销,怎么开通能稳定跑高推理档与 Plan Mode 的订阅?
答:可通过本站 AI 会员充值总览 办理 ChatGPT Plus 卡密自助兑换 或高配额 ChatGPT Pro,多人研发团队可直接选择 ChatGPT Business 团队定制。支持支付宝、微信支付与 AlipayHK 付款,无需提供账号密码,可开具增值税发票;实时价格以商品页为准,售后遵循掉订阅按剩余天数折退、封号不在质保范围的规则。
相关教程
参考资料
- OpenAI Codex 官方文档:Config reference — https://learn.chatgpt.com/docs/config-file/config-reference
- OpenAI Codex 官方文档:Model selection — https://learn.chatgpt.com/docs/model-selection
- OpenAI Codex 官方文档:Slash commands — https://learn.chatgpt.com/docs/cli/slash-commands
0 条评论
还没有评论,来抢沙发~