
结论先说
- Predicted Outputs 通过传入已知原文草稿大幅缩短输出等待时间。当模型最终输出有七八成以上内容与输入草稿一致时,在请求中附带
prediction参数可让服务端并行验证匹配片段,显著降低首字与总响应延迟。 - 仅适合「大段保留、局部微调」场景,不适合重写或从零生成。如果模型实际输出推翻了大部分预测文本,不仅无法提速,还会产生额外账单。
- 被拒绝的预测 Token 同样按输出单价收费。响应里的
usage.completion_tokens_details会披露accepted_prediction_tokens与rejected_prediction_tokens,后者会计入计费总额。 - 存在明确的参数互斥边界。开启
prediction时不能同时挂载函数调用(tools)、不能开启音频输出、n不能大于 1,也不能把presence_penalty或frequency_penalty设为正数。 - 开发调试之余若需直接使用官方客户端交互改代码,国内缺少境外信用卡的用户可在本站自助开通 ChatGPT Plus 或高配额 ChatGPT Pro,团队协作可了解 ChatGPT Business 团队定制。
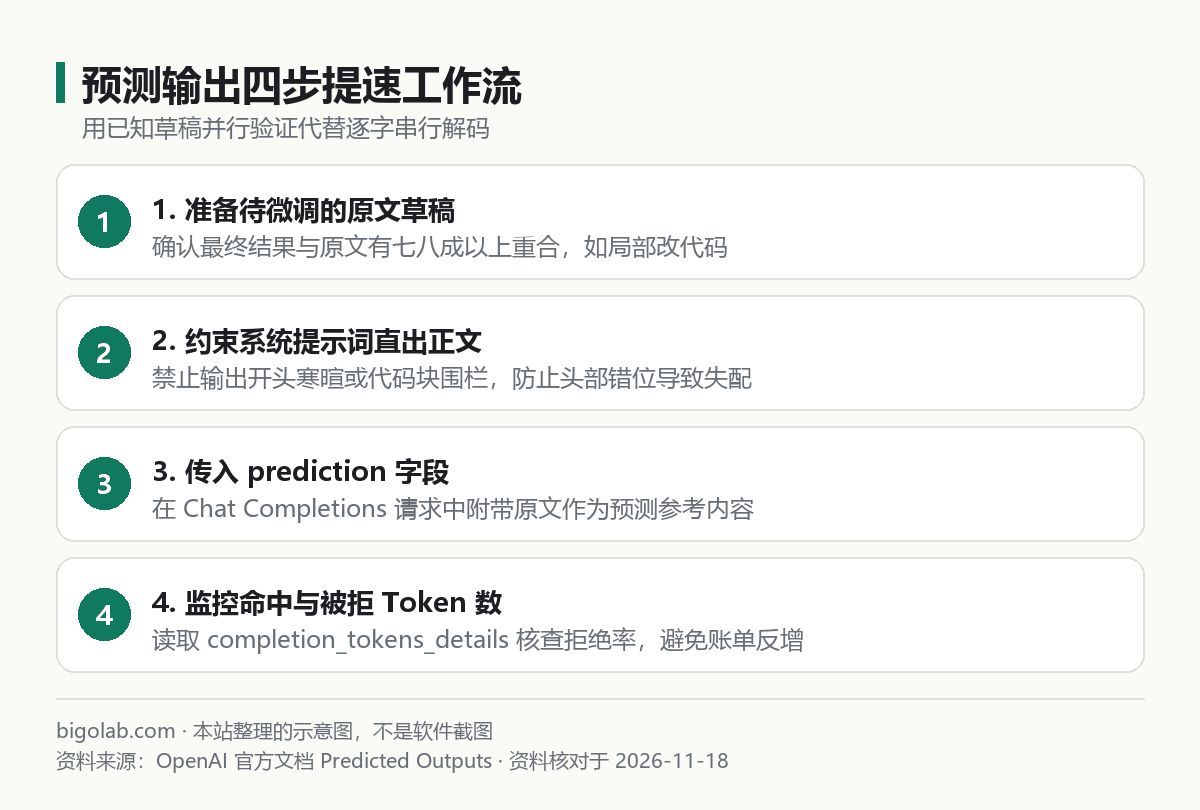
图:本站根据 OpenAI 官方文档:Predicted Outputs 整理的示意图
本文根据 OpenAI API 官方文档《Predicted Outputs》《Chat Completions API Reference》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。
适用于谁
- 开发 AI 代码编辑器、「一键应用修改(Apply)」或公文微调功能,需要把几百行旧文件改几行后完整返回,但嫌默认逐字生成太慢的开发者;
- 想搞懂
prediction参数为什么能提速、又在什么情况下反而会多扣 Token 费用的工程负责人; - 调用接口传入
prediction后遇到 400 参数冲突报错的排查者。
一、工作原理与 Python 调用代码示例
在传统代码重构调用中,即便 300 行文件只改 2 行变量名,模型仍需从第 1 行串行解码到第 300 行。按官方《Predicted Outputs》文档,在 Chat Completions 接口(与新版接口关系见 /guides/openai-responses-api)中把原文件全文传给 prediction 字段即可启用投机解码加速:
python
from openai import OpenAI

client = OpenAI()

original_code = """class OrderService:
    def __init__(self, repo):
        self.repo = repo

    def find_by_uid(self, uid: str):
        return self.repo.get(uid)
"""

prompt = "把方法名 find_by_uid 改为 get_order_by_id,其余逻辑与格式保持原样,只返回完整代码正文不要包裹代码块围栏。"

resp = client.chat.completions.create(
    model="gpt-4o",
    messages=[
        dict(role="user", content=prompt),
        dict(role="user", content=original_code),
    ],
    prediction=dict(type="content", content=original_code),
)

print(resp.choices[0].message.content)
details = resp.usage.completion_tokens_details
print("命中预测 Token:", details.accepted_prediction_tokens)
print("拒绝预测 Token:", details.rejected_prediction_tokens)配合流式输出(stream=True,写法见 /guides/openai-api-streaming)时,前端打字机渲染会出现明显的成片跃进效果。注意提示词中应明确要求「只输出修改后的完整文件内容,不要添加寒暄解释和 Markdown 代码块围栏」,否则开头多出的闲聊文字会导致整段预测错位失效。
订阅与账号准备提示:若你不做底层 API 二次开发,只希望在本地仓库直接享受低延迟自动改文件体验,开通订阅直接使用 Codex CLI 更省心。国内用户可在本站选购 ChatGPT Plus 会员 或升级 ChatGPT Pro 充值,支持免交密码自助兑换。
二、计费账本与适用边界决策
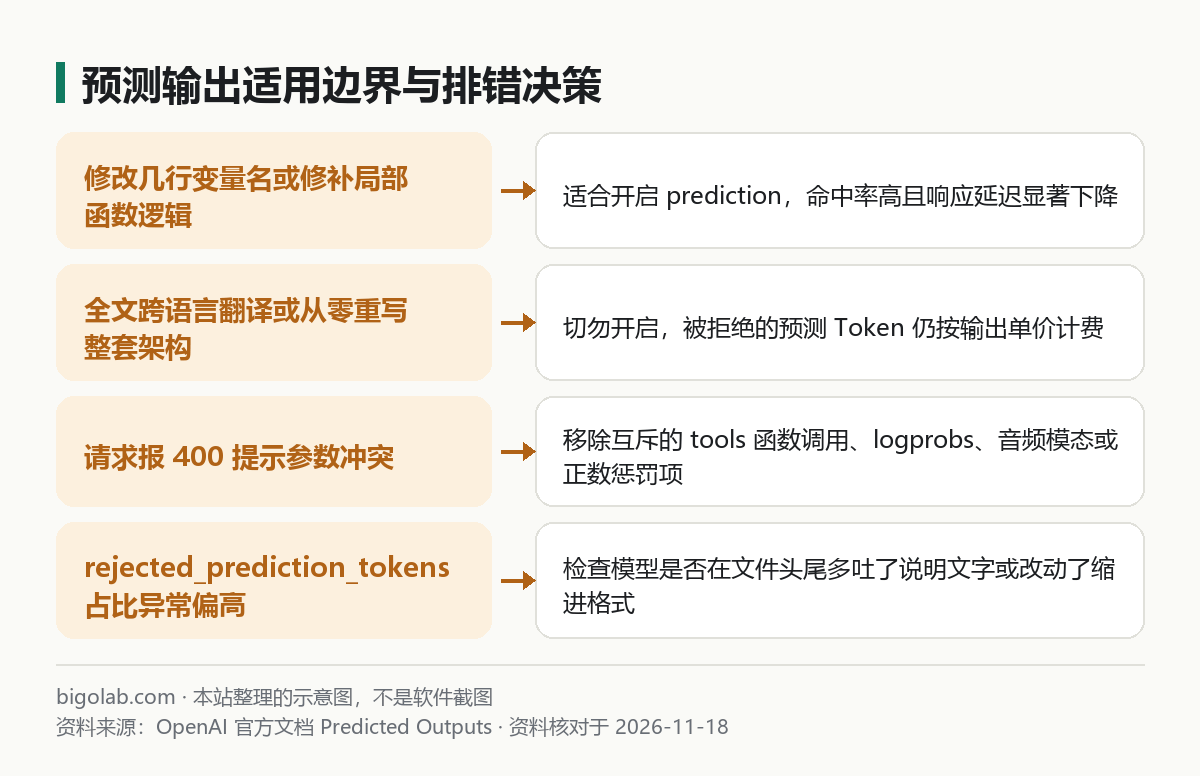
图:本站根据 OpenAI 官方文档:Predicted Outputs 整理的示意图
上线前务必在监控日志里核查拒绝率(价格表见 /guides/openai-api-price-official-table),按以下四条规则取舍:
| 检查维度 | 官方规则与工程影响 | 实操应对建议 |
|---|---|---|
| 改动幅度 | 改动越小,命中率越高、加速越显著;大幅改写会导致大量预测被拒并计费 | 仅用于局部补丁应用、拼写修正、字段重命名,全文翻译或重写切勿开启 |
| 开头多余文本 | 模型若先输出一句「好的,修改如下:」,后续预测更容易失配 | 系统提示词写死直接以原文件首行开头返回,不输出解释 |
| 工具调用冲突 | 与 tools / tool_choice 同时传会直接报 400 错误 | 先在上一轮用函数调用(见 /guides/openai-api-function-calling)定好修改方案,最后一轮落盘改写再单独带 prediction |
| 模型支持范围 | 面向非推理型主力对话模型开放(如 gpt-4o、gpt-4.1 系列),推理模型不支持 | 切换模型前先查官方文档的支持表 |
常见问题
问:为什么我加了 prediction 后,账单上的 completion_tokens 反而比实际字数多出一截?
答:因为模型在验证草稿时推翻了部分不匹配的预测片段,这部分 rejected_prediction_tokens 同样计入输出用量。检查提示词是否导致模型在头部多吐了说明文字或改动了缩进风格。
问:只让模型返回 Unified Diff 补丁不是比传全文加 prediction 更省钱吗?
答:纯算 Token 数确实 Diff 更少,但通用模型手写行号偏移的 Diff 容易贴片失败;「全文返回 + prediction」以接近普通生成的费用换取了零贴片报错和极低延迟,是很多 IDE「快速应用修改」层的常用折中方案。
问:国内没有外币卡,或者公司财务要求开具增值税发票,怎么订阅官方会员辅助研发?
答:可通过本站 AI 会员充值总览 选购 ChatGPT Plus 或 ChatGPT Pro,支持支付宝、微信支付及 AlipayHK 结算,提供卡密自助兑换与企业定制,并支持开具增值税发票。实时价格以页面显示为准;售后遵循掉订阅按剩余天数折退、封号不在质保范围的规则。
相关教程
- OpenAI API 流式输出(streaming)怎么写
- OpenAI API 函数调用(function calling)怎么写
- OpenAI API 价格表与计费说明
- OpenAI Responses API 与 Chat Completions 区别
参考资料
- OpenAI API 官方文档:Predicted Outputs — https://platform.openai.com/docs/guides/predicted-outputs
- OpenAI API 官方文档:Chat Completions Reference — https://platform.openai.com/docs/api-reference/chat/create
0 条评论
还没有评论,来抢沙发~