OpenAI API 报 context_length_exceeded 与输出半截中断怎么防:服务端 truncation: "auto" 与窗口预算控制

多轮对话越聊越长突然报 400 context_length_exceeded,或者 JSON 生成到一半断掉?本文按官方文档讲清 Responses API 的 truncation: auto 自动裁剪机制与输出预算控制做法。

NNathaniel bigo··原创首发·AI 辅助撰写
9 分钟读完
资料核对于 2026-11-18 · 依据官方文档与公开资料整理 其他 账号

结论先说

  1. 先分清是「输入超窗」还是「输出触顶」。请求直接报 400 context_length_exceeded,说明输入消息加历史超出了模型总上下文窗口;请求返回 200 但文字或 JSON 卡在半截,则是单次生成撞到了 max_output_tokens 上限。
  2. Responses API 提供服务端自动裁剪参数 truncation: "auto"。默认值为 "disabled"(超限即报错);设为 "auto" 后,若总长度超出窗口,服务端会保留顶层系统指令与最新消息,自动从对话中部丢弃最早的历史输入项。
  3. 绝对不能丢失的核心规则必须放进 instructions 字段。放在普通早期对话轮次里的背景说明,在触发 auto 裁剪时可能被优先剔除。
  4. 严谨审计与全量抽取任务应保持 "disabled"。合同审查、财报核算等不允许静默漏读段落的场景,一旦超长应显式报错并改走分块汇总,切勿让服务端静默删减内容。
  5. 个人日常处理超长文档或代码库时若需更高上下文额度,国内无外币卡用户可在本站自助开通 ChatGPT Plus 或高配额 ChatGPT Pro,企业协作可咨询 ChatGPT Business 团队定制。
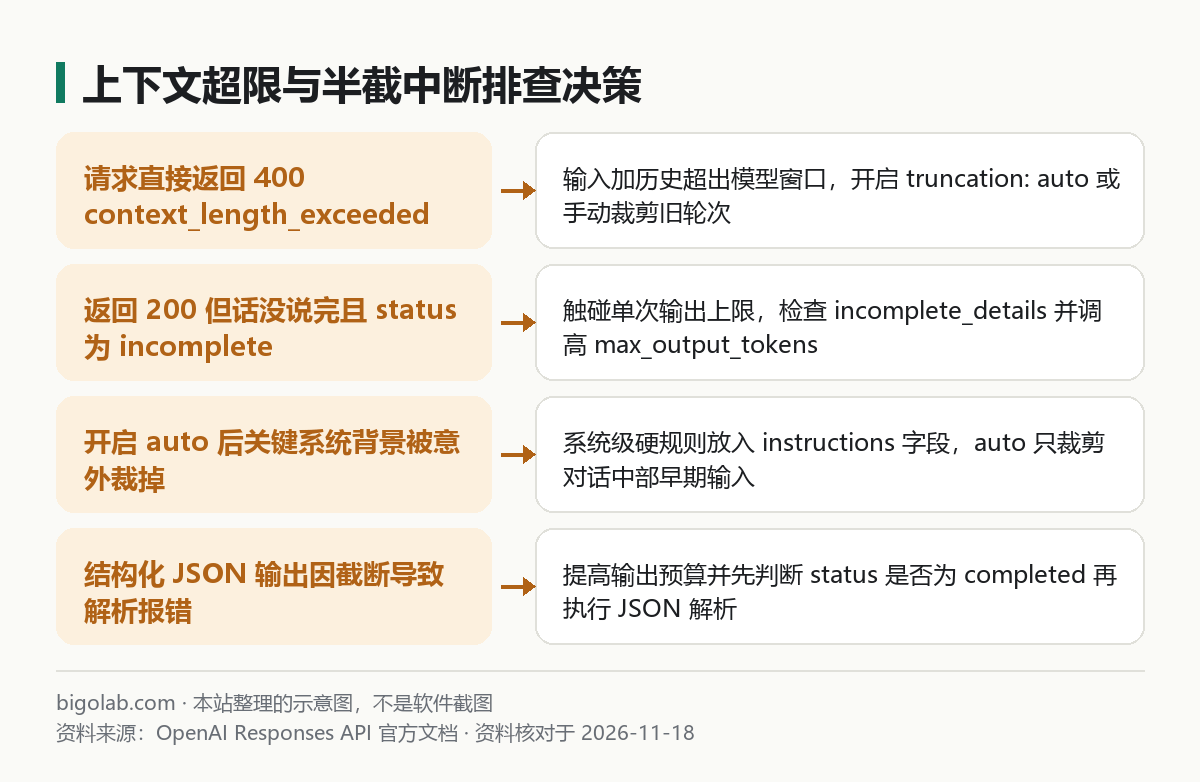
上下文超限与半截中断排查决策

图:本站根据 OpenAI Responses API 官方参考文档 整理的示意图

本文根据 OpenAI API 官方文档《Create a model response Reference》《Error codes》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 OpenAI 官方网站。

适用于谁

  • 在多轮客服机器人、Agent 工具循环或长文档问答里遇到 HTTP 400 context_length_exceeded 报错的后端开发者;
  • 搞不清「输入撑爆上下文窗口报错」与「输出撞到 max_output_tokens 半截中断」两种故障边界的人;
  • 想用 Responses API 原生 truncation: "auto" 省去手写滑动窗口裁剪逻辑的工程师。

一、truncation 两种模式与截断类型对照

在 Responses API 中(接口基础见 /guides/openai-responses-api,常见错误码总览见 /guides/openai-api-error-codes),服务端对窗口边界的处理逻辑如下:
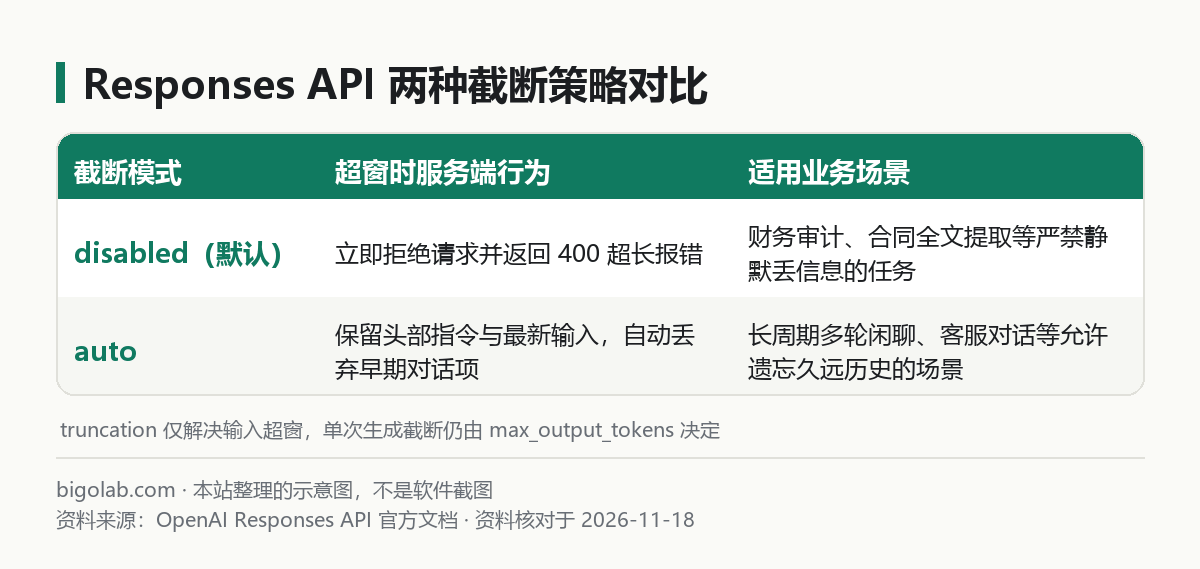
Responses API 两种截断策略对比

图:本站根据 OpenAI Responses API 官方参考文档 整理的示意图

故障现象触发条件对应控制参数与修复手段
HTTP 400 context_length_exceeded输入提示词 + 多轮历史 + 预留空间超出模型总窗口多轮对话开 truncation="auto",或对旧轮次做摘要压缩
HTTP 200 但 status == "incomplete"生成过程耗尽了单次允许的 max_output_tokens检查 incomplete_details.reason,调高 max_output_tokens 或分步生成
结构化 JSON 解析报语法截断错未检查完成状态就直接对半截输出跑 json.loads解析前先校验 resp.status == "completed"(详见 /guides/openai-api-structured-outputs)

二、Python 实战代码:开启服务端自动裁剪与截断兜底检查

搭配 previous_response_id 做多轮有状态对话时,加上 truncation="auto" 即可防止聊到几十轮后突然炸 400 错误:

python
from openai import OpenAI

client = OpenAI()

resp = client.responses.create(
    model="gpt-4.1",
    instructions="你是技术支持助手,回答务必控制在 300 字以内,严禁编造不存在的命令。",
    input="用户上传了最新一段报错栈,请结合前文继续给出排查命令。",
    previous_response_id="resp_abc123xyz",
    truncation="auto",
    max_output_tokens=4096,
)

if resp.status == "incomplete":
    reason = resp.incomplete_details.reason if resp.incomplete_details else "unknown"
    raise RuntimeError(f"响应未完整结束,触发限制:{reason}")

print(resp.output_text)
print("本轮输入 Token:", resp.usage.input_tokens)
订阅与账号准备提示:长上下文多轮对话在未命中缓存时每轮都会重复计入历史输入 Token(价格计算见 /guides/openai-api-price-official-table)。若你日常办公需要高频上传长文档反复追问,开通包月会员往往比按量烧 API 更可控;国内用户可在本站选购 ChatGPT Plus 会员 或升级 ChatGPT Pro 充值。

三、控制窗口预算的三条工程实践

  1. 限制单次工具返回体积:在 Agent 循环里,context_length_exceeded 最常见的元凶不是用户打字太多,而是某一次数据库查询或网页抓取工具一次性塞回了十几万字符的原始 HTML。务必在工具层对返回文本做长度截断(例如上限 8000 字符并附带省略提示)。
  2. 区分静态前缀与动态变量保住缓存命中:truncation="auto" 发生裁剪时会改变历史序列前缀,可能导致后续请求暂时失去提示词缓存折扣;对于超长对话,每隔 15 至 20 轮主动用小模型把旧历史浓缩成一段摘要开启新会话链,成本更平稳。
  3. 仍在用旧版 Chat Completions 接口怎么办:旧版 /v1/chat/completions 没有服务端 truncation="auto" 参数,只能由业务代码用 tiktoken 预估各条消息 Token 数并在客户端自行弹出旧消息,或平滑迁移至 Responses API。

常见问题

问:开了 truncation: "auto" 后,单条输入本身就超过模型最大上下文窗口还能救回来吗?

答:不能。auto 是按对话历史里的「输入项(Items)」粒度从中部剔除旧轮次;如果你单次塞进去的一整篇几百万字文本本身就大于模型总窗口,依然会返回 400 超长错误,这种情况必须先做文档切片检索(RAG)或分段摘要。

问:怎么知道某一轮请求有没有实际触发自动裁剪?

答:可以对比预期累计的历史 Token 数与本次响应 resp.usage.input_tokens 的回落幅度,或在平台后台日志面板核查实际进入模型上下文的消息条目列表。

问:国内没有外币卡,或者公司财务要求开具增值税发票,怎么订阅长窗口官方会员?

答:可通过本站 AI 会员充值总览 选购 ChatGPT Plus 或 ChatGPT Pro,支持支付宝、微信支付及 AlipayHK,支持卡密自助兑换与企业定制,并可开具增值税发票。实时价格以页面显示为准;售后遵循掉订阅按剩余天数折退、封号不在质保范围的规则。

相关教程

参考资料

  • OpenAI API 官方文档:Create a model response — https://platform.openai.com/docs/api-reference/responses/create
  • OpenAI API 官方文档:Error codes — https://platform.openai.com/docs/guides/error-codes

Nathaniel 的更多内容

  1. 01

    独立开发者用 ChatGPT + Codex 跑通产品全流程:市场验证、PRD、原型到代码上线复盘清单

    单人做独立产品最容易陷入「闭门写两个月代码上线零用户」或「AI 写到一半目录越改越崩」。本文整理「ChatGPT 负责市场验证、PRD 与复盘 + Codex 负责工程实现与测试」的五阶段双轨流程,附起手提示词与 7 项上线复盘清单。

    ChatGPTCodex0
  2. 02

    用 ChatGPT 批量生成规范文件命名规则、整理混乱目录树与合并零散发票抬头清单脚本

    面对满桌面的「新建文件夹」「最终版2」和上百张零散电子发票,手工改名抄台账耗时又容易漏重。本文分享先脱敏取样、再用 ChatGPT 生成带预演和回滚日志的本地 Python 脚本,离线安全完成目录整理与发票抬头合并去重的实战流程。

    ChatGPT0
  3. 03

    用 ChatGPT 做海外邮件营销(EDM)受众分层文案、A/B 主题行测试与防进垃圾箱自检

    做海外独立站或出海 SaaS 邮件营销(EDM),最怕千人一面群发被直接送进垃圾箱。本文结合 Gmail/Yahoo 批量发件人规范,梳理用 ChatGPT 设计受众分层文案、批量生成 A/B 主题行矩阵并开展发前垃圾词与合规自检的实战提示词。

    ChatGPT0
  4. 04

    用 ChatGPT 写 Notion Formula 2.0 公式、Obsidian Dataview 查询与 Airtable 自动化脚本

    给 Notion 数据库写多条件 Formula 2.0 公式、给 Obsidian 写 Dataview 动态看板,或在 Airtable 里写自动化脚本,经常因为一个小括号或类型不匹配报错半天。本文整理三大工具的通用上下文喂料规范与三套直接可复制的生成提示词。

    ChatGPT其他 AI 工具0
  5. 05

    用 ChatGPT 处理复杂 JSON / YAML / XML 字段映射、格式转换与校验规则编写实战

    对接第三方 API、迁移 Kubernetes 配置或解析政企 XML 报文时,手工对照几百行嵌套字段既慢又容易漏掉空值与类型边界。本文整理用 ChatGPT 完成字段映射表梳理、生成确定性转换脚本以及编写 JSON Schema / Pydantic / XSD 校验规则的实战流。

    ChatGPT其他 AI 工具0
  6. 06

    用 ChatGPT 准备本科/硕士毕业论文答辩:提炼答辩 PPT 结构、模拟导师犀利追问与 3 分钟自述稿

    毕业论文写完后,要在 3–5 分钟内讲清研究价值并顶住答辩评委的连环追问并不轻松。本文整理在严格遵守高校学术规范的前提下,用 ChatGPT 提炼答辩 PPT 结构、打磨 3 分钟口语自述稿并开展模拟导师犀利追问的排练流程与提示词。

    ChatGPT0

同模型

  1. 01

    从免费试水到全职写码:Codex 个人开发者月度额度规划与 Plus / Pro 5x / Pro 20x 升级时机指南

    个人开发者用 Codex 写代码,怎么判断自己该留在 Plus、买 Credits 点数兜底,还是升级 Pro 5x(官方 Pro 100)或 Pro 20x(官方 Pro 200)?本文基于官方定价规则与 /status 预警信号,给出清晰月度额度规划。

    ChatGPTCodex0
  2. 02

    小微研发团队在 ChatGPT Business 与 Pro 之间怎么配 Codex 席位最省钱:角色分层与额度测算

    5 到 20 人的小微研发团队采购 Codex,全员上高配太贵、全员买基础档又天天卡 5 小时限流?本文对照官方 Business(Standard / Premium)与 Pro 规则,给出按角色分层的席位搭配与预算测算框架。

    ChatGPTCodex0
  3. 03

    ChatGPT + Codex 联合开发 SaaS MVP 实战:先写 PRD 与架构图再落库写代码

    直接让 AI 一口气从零写完 SaaS 往往表结构混乱、功能返工。本文拆解 ChatGPT 写 PRD 与架构图、落盘仓库文档与 AGENTS.md、再由 Codex 分片落库与测试验收的完整闭环。

    ChatGPTCodex0
  4. 04

    ChatGPT 智能交互界面(Intelligent UI)怎么触发和用好:表单、计算器、图表与对比卡片实战

    同样是用 GPT-6,为什么别人的 ChatGPT 能直接弹出带滑块的计算器、交互图表和对比卡片,你的却只回一大段纯文字?本文依据 OpenAI GPT-6 官方文档讲清触发前提、4 类高命中提问模板,以及不出交互界面时的排查方法。

    ChatGPT0
  5. 05

    买 ChatGPT Pro 5x 还是 Pro 20x 怎么按月度用量自测:Codex 并发与深度研究频次估算对照

    犹豫买 ChatGPT Pro 5x(官方 Pro 100)还是 Pro 20x(官方 Pro 200)?本文对照官方最新档位规则,用 Codex 并发任务、Fast 模式消耗倍率和深度研究频次三项指标帮你做月度用量自测。

    ChatGPTCodex0
  6. 06

    Codex 额度消耗太快怎么省:模型档位切换、推理强度降级、关闭非必要 Fast 模式与控上下文 6 招

    刚写半天代码就提示 Codex 触达周期限额?本文从 Token 计费原理拆解消耗黑洞,给出模型降档、推理强度调优、关闭非必要高速模式与控上下文的 6 招省额度方案。

    ChatGPTCodex0

同产品的其他教程

  1. 01

    用 ChatGPT 整理家庭装修预算明细、隐蔽工程验收清单与主材优缺点对比表实战

    第一次装修面对几十页施工报价单、密密麻麻的水电防水隐蔽项目与五花八门的主材参数,极易踩坑增项。本文梳理用 ChatGPT 审查装修报价漏项、生成带公式的预算明细表、定制工地隐蔽工程验收单与主材对比表的实战提示词。

    ChatGPT0
  2. 02

    用 ChatGPT 做费曼学习法读书共读:反向追问检验自己是否真读懂专业书籍与整理书单笔记

    读完一本专业硬书常感觉「合上书就忘」,直接让 AI 概括全书又容易产生懂了的错觉。本文介绍用 ChatGPT 结合 Study Mode 与费曼学习法做反向追问共读,通过通俗复述、挑刺盲区到沉淀书单卡片的完整流程与提示词。

    ChatGPT0
  3. 03

    用 ChatGPT 做外贸产品多语种目录、展会邀约与客户跟进节奏表(附脱敏与本地化提示词)

    做外贸展会与海外推广时,手工翻译十几款产品目录费时且容易留下一堆中式英文,展后客户跟进也常缺节奏。本文梳理用 ChatGPT 先脱敏建术语库、再批量产出多语种目录、展前邀约函与展后 21 天跟进节奏表的实战流程与提示词。

    ChatGPT0
  4. 04

    用 ChatGPT 写高质量技术专栏文章、开源项目 Release Notes 与版本更新日志实战

    让 AI 直接凭空写技术文章容易满篇空洞套话,直接甩 Git 记录写更新日志又常常漏掉破坏性变更。本文整理用 ChatGPT 结合真实代码片段、压测数据与 PR 摘要,高效产出深度技术专栏、GitHub Release Notes 与 CHANGELOG 的实战工作流。

    ChatGPT0
  5. 05

    用 ChatGPT 做产品用户访谈纪要编码、提炼高频痛点需求池与 RICE 优先级打分实战

    手头攒了十几份用户访谈逐字稿,手工贴便利贴归纳痛点耗时又容易带入主观偏见。本文分享用 ChatGPT 完成脱敏检查、逐份开放式编码、跨样本聚类高频痛点并搭建 RICE 优先级打分表的 5 步实战流,附可直接复制的三段核心提示词。

    ChatGPT0
  6. 06

    ChatGPT 网页版上传超过 10 个文件或回形针附件按钮变灰怎么办:打包合并与配额限制排查

    在 ChatGPT 网页版批量分析文档时,常遇到一次选超 10 个文件被拦截或输入框回形针按钮变灰。本文依据 OpenAI 文件上传与存储说明,梳理 6 类常见报错的分流排查法,提供 ZIP 打包、本地合并与 Projects 复用方案及可直接复制的解包提示词。

    ChatGPT0

0 条评论

登录 后参与评论

还没有评论,来抢沙发~