
結論先說
- Context Editing(上下文編輯)負責「定點清舊垃圾」:在請求到達模型前,由服務端自動把早期臃腫的
tool_result(如幾千行的舊文件讀取、舊搜尋結果)或舊輪次的thinking思考塊替換成輕量佔位,客戶端本地仍可保留完整原始日誌。 - Compaction(服務端壓縮)負責「整段濃縮歷史」:當多輪長對話整體逼近窗口閾值時,服務端自動把早期對話輪次壓縮成一段高保真摘要塊(
compactionblock),讓單次任務能跨越單窗口限制持續跑下去。 - 兩者不是二選一,而是分層配合:日常工具密集循環先靠 Context Editing 削掉水分,再搭配 Memory Tool 把關鍵事實落盤,最後用 Compaction 給超長會話兜底。
- 注意和提示詞緩存(Prompt Caching)算總帳:每次修改早期歷史都會讓改動點之後的緩存失效重算,務必合理設定單次最小清理量(如
clear_at_least),攢夠一批再集中清理。 - 國內免卡開通與帳號服務入口:自有帳號免上號自助開通可見本站 Claude Pro 充值頁 與 Claude Max 充值頁;缺可用帳號或遇身份核驗可查看 Claude 註冊說明 與 Claude KYC 認證協助。
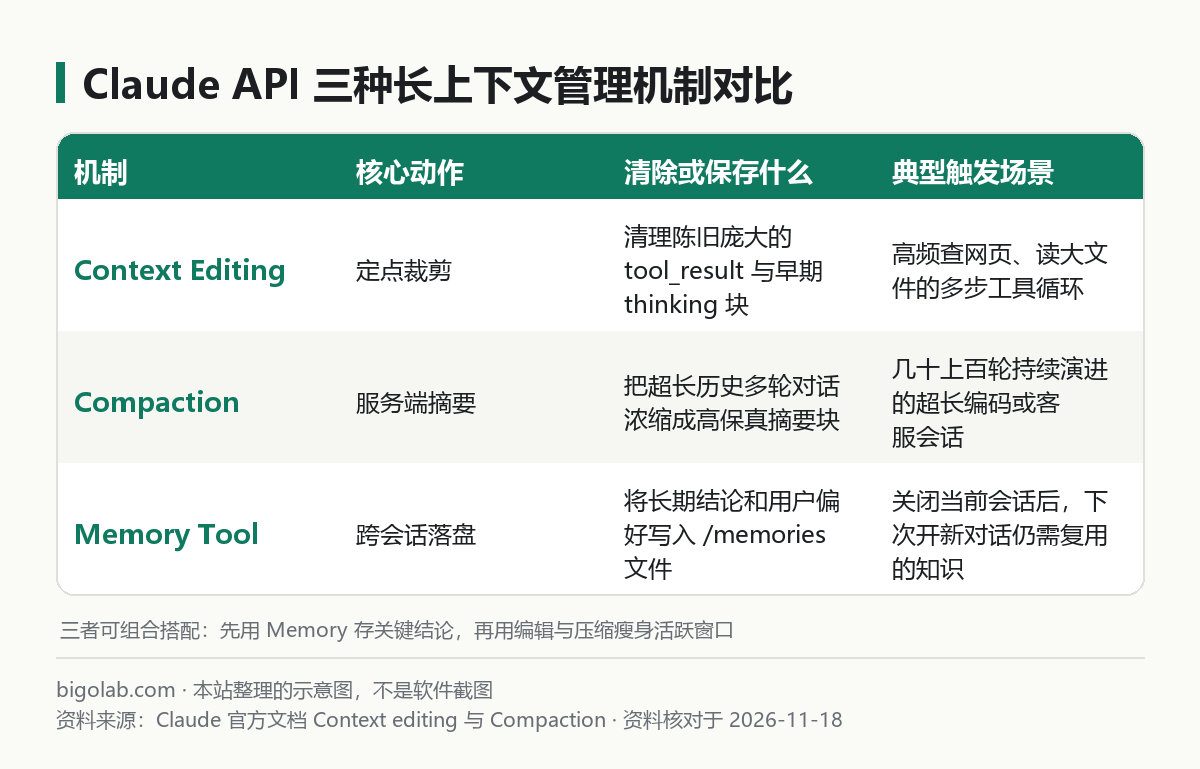
圖:本站根據 Claude 官方文檔:Context editing 與 Compaction 整理的示意圖
本文根據 Claude 開發者平台官方文檔《Context editing》《Compaction》整理,資料核對於 2026-11-18。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 搜「claude api context editing」「claude api compaction 壓縮」,發現智能體跑二三十輪後輸入 token 帳單翻倍或報超出窗口上限(400 / 413)的開發者;
- 不想在自己後端手寫容易丟上下文的截斷和摘要拼接邏輯,希望直接用 Anthropic 服務端原生瘦身參數的人;
- 開啟了擴展思考(Extended thinking)與網頁搜尋、文件讀取後,想弄清什麼時候該「定點清垃圾」、什麼時候該「整段做摘要」的架構師。
如果你是在本地用官方命令行編程工具遇到上下文滿了,可以直接看終端裏的現成命令指南 /guides/claude-code-context-compact;本文專講後端開發者調用 Messages API 時的服務端控制方案。
一、Context Editing:自動清理陳舊工具結果與思考塊
在長週期搜尋或寫代碼循環裏,最佔地方的往往不是用戶說的那幾句話,而是十輪前早就消化完的原始網頁正文、終端構建日誌以及歷史推理過程(擴展思考基礎用法見 /guides/claude-api-extended-thinking)。
通過傳入請求頭 context-management-2025-06-27 並配置 context_management.edits,可以讓服務端按規則自動裁剪這兩類膨脹源:
clear_tool_uses_20250919:當輸入 token 達到觸發閾值時,從最老的輪次開始清理tool_result的大段內容(保留調用發生過的結構佔位),同時原樣保留最近幾輪的工具輸出供當前推理使用,還可通過exclude_tools排除像"memory"這類不希望被清掉的工具;clear_thinking_20251015:清理更早歷史輪次裏的thinking塊,只保留最近幾個助手回合的思考內容以維持推理連貫度。
按官方文檔整理的 Python SDK 配置示例:
python
import anthropic

client = anthropic.Anthropic()

response = client.beta.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    betas=["context-management-2025-06-27"],
    tools=[{"type": "web_search_20250305", "name": "web_search"}],
    context_management={
        "edits": [
            {
                "type": "clear_thinking_20251015",
            },
            {
                "type": "clear_tool_uses_20250919",
                "clear_at_least": {"type": "input_tokens", "value": 10000},
            },
        ]
    },
    messages=conversation_history,
)
需要同時啟用兩條策略時,按官方規範應把 clear_thinking_20251015 排在 clear_tool_uses_20250919 前面。響應返回後,你可以從 response.context_management 元數據字段裏直接讀出本次一共替你清掉了多少輸入 token。
二、Server-side Compaction:跨窗口超長會話的服務端摘要
即便清掉了大體積工具結果,如果一段代碼重構或複雜排障來回聊了上百輪,純對話本身也會逼近上下文天花板,還會引發「中間資訊遺忘(Context rot)」。服務端壓縮(Compaction)把過去要靠開發者自己寫副提示詞做總結的髒活搬到了 API 內部,常見有兩種調用姿勢:
- 按閾值自動觸發壓縮:在
context_management.edits中配置壓縮策略(如compact_20260112並攜帶對應 Beta 標識),設定輸入 token 觸發線(例如達到 10 萬或 15 萬 token 時啟動)。一旦越線,服務端先生成濃縮摘要塊再繼續回答本輪問題; - 按需主動觸發壓縮(On-demand):攜帶
compact-2026-09-04等對應 Beta 頭並在請求中顯式傳入compaction參數(如{"type": "summarize"}),由你的業務代碼在階段性任務交接點主動發起一次乾淨的歸檔壓縮。
python
# 將上一輪含 compaction 塊的完整 response.content 追加回歷史即可
conversation_history.append({
    "role": "assistant",
    "content": response.content,
})
它的多輪銜接非常省心:當服務端完成一次壓縮後,返回的 response.content 中會包含一個專門的 compaction 內容塊。你下一輪只需要照常把 response.content 追加回 messages 數組發出去,API 服務端收到後會自動忽略該 compaction 塊之前的所有舊消息,直接從這段摘要往後讀。
Claude 會員充值與成品號提示:國內銀行卡在結帳頁被拒時,可通過本站支付寶、微信支付或 AlipayHK 獲取 iOS 訂閱卡密自助開通 Claude Pro 或高配額 Claude Max(全程無需上號交密碼);需要現成帳號可了解 Claude Pro 成品號 與 Claude Max 5x 成品號(注:Anthropic 消費者條款禁止共享轉讓帳號且違規可終止無退款,成品號均明確標註不質保封號)。
三、長循環省錢與防失憶實戰選型
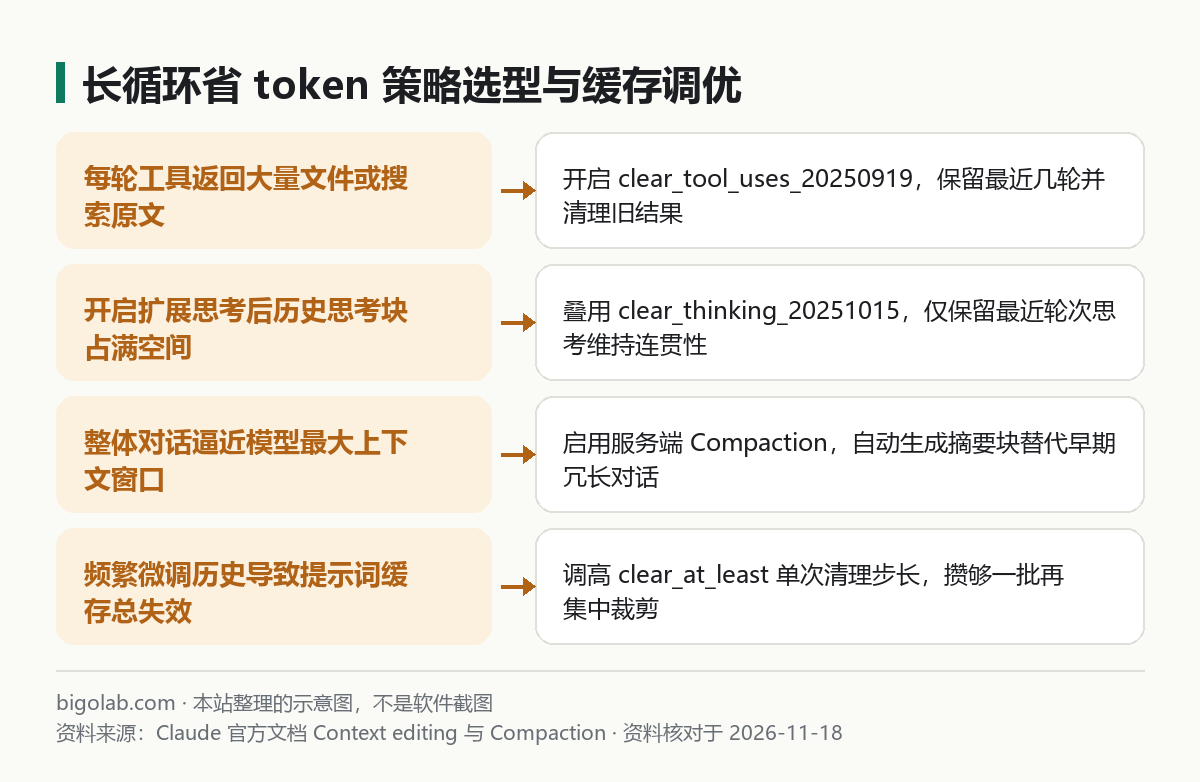
圖:本站根據 Claude 官方文檔:Context editing 與 Compaction 整理的示意圖
想既省錢又不讓模型丟掉關鍵業務約束,建議照着下面三條工程經驗落地:
- 避免每輪擠牙膏式清理破壞緩存:如果每多幾百個 token 就刪一條舊消息,歷史消息前綴每一輪都在變,反而吃不到 90% 折扣的緩存讀取價。設好
clear_at_least(例如每次至少清掉上萬 token),平時靠緩存低價複用,攢大了再一次性裁剪,總帳最划算(發請求前預估體積可用 /guides/claude-api-count-tokens); - 清之前先提醒模型記筆記:當同時掛載記憶工具時,服務端會在接近清理閾值前提醒模型把重要發現寫進
/memories文件,這樣舊的原始搜尋頁被清掉也不會丟結論; - 個人終端開發直接用現成自動壓縮:如果你不是在寫企業後端服務,而是自己日常寫代碼怕按量 API 帳單失控,直接用內置了自動壓縮與閒置壓縮機制的 Claude Code(參考 /guides/claude-code-idle-compaction-long-conversation-away)配合固定月費的 Claude Max 訂閱充值 會省心得多。
常見問題
問:開啟 Context Editing 後,我客戶端自己儲存的 conversation_history 數組會被改掉嗎?
答:不會。裁剪動作只發生在 Anthropic 服務端當次推理管線內部,你本地維護的原始對話數組完好無損,仍然可以原樣落庫留作審計或前端回放。
問:服務端生成 Compaction 摘要本身要收 token 費嗎?
答:要按標準模型費率計費。觸發壓縮的那一輪,服務端需要讀取待壓縮的歷史消息並生成摘要文本,這部分消耗會體現在返回結果的 usage 統計(含迭代明細)裏,但換來的是後續幾十輪每次都少付十幾萬輸入 token。
問:報 400 錯誤提示不識別 context_management 字段怎麼辦?
答:先檢查兩處:一是確認走的是 client.beta.messages.create 並正確傳入了對應的 betas 列表;二是核對當前調用的模型型號是否在官方文檔頂部的支持名單內(通常要求較新的 Sonnet / Opus 4.x 及 5.x 系列模型,報錯排查見 /guides/claude-api-error-codes)。
問:人在國內沒有外幣信用卡,怎麼訂閱或升級 Claude 付費套餐?
答:可在本站 AI 會員充值總覽頁 選擇 Claude Pro 自助充值 或 Claude Max 充值,付款後即時發卡密、24 小時自助兌換且可開具增值稅發票;實時價格與售後邊界(含封號不質保)以商品頁當天展示為準。
相關教學
- Claude API 擴展思考(extended thinking)參數怎麼設
- Claude API token 計數(count tokens)怎麼用:發請求前先量,再估算費用
- Claude Code 上下文滿了怎麼辦:/compact、/clear 與省 token 技巧
- Claude Code 離開一小時回來對話被壓縮了:Idle compaction 是什麼
- Claude API 報錯 400 / 401 / 403 / 413 / 500 怎麼排查
參考資料
- Claude 開發者平台文檔:Context editing — https://platform.claude.com/docs/en/build-with-claude/context-editing
- Claude 開發者平台文檔:Compaction — https://platform.claude.com/docs/en/build-with-claude/compaction
0 條評論
還沒有評論,來搶沙發~