
本文根據 Codex 官方沙盒文檔、雲端聯網文檔和《Prompting》整理,資料核對於 2026-11-05。關於爬蟲合規的部分是本站的一般性建議,不是官方規定,也不是法律意見。配圖為本站整理的示意圖,不是軟件截圖。本站(bigolab.com)不是 OpenAI 官方網站。安裝與配置見 /guides/codex-getting-started。
適用於誰
- 想自己抓取公開網頁上的數據(價格、公告、文章列表)做整理分析的人;
- 已經有一批抓下來的數據,想讓 Codex 幫忙清洗、去重、整理成表格的人;
- 擔心“爬蟲會不會違規、會不會被封”的人。
結論先說
- 先確認能不能抓,再談怎麼寫。 看目標網站的服務條款和
robots.txt,有開放接口(API)或可下載的數據就優先用那個。這一步是本站的建議,官方文檔沒有講。 - 腳本要剋制。 限速、設定明確的訪問間隔、失敗重試有上限、不繞過登入和驗證、不抓個人私隱資訊。
- 先小範圍試跑。 先抓一頁、再抓十頁,確認結構和數據沒問題再擴大。
- 儲存原始數據,清洗另存一份。 網頁改版後你還能重新清洗,不用重抓。
- 注意 Codex 的網絡限制。 本地沙盒會限制網絡訪問,需要時會詢問你;雲端環境聯網預設可以關閉,開放聯網有風險,官方建議盡量限制。
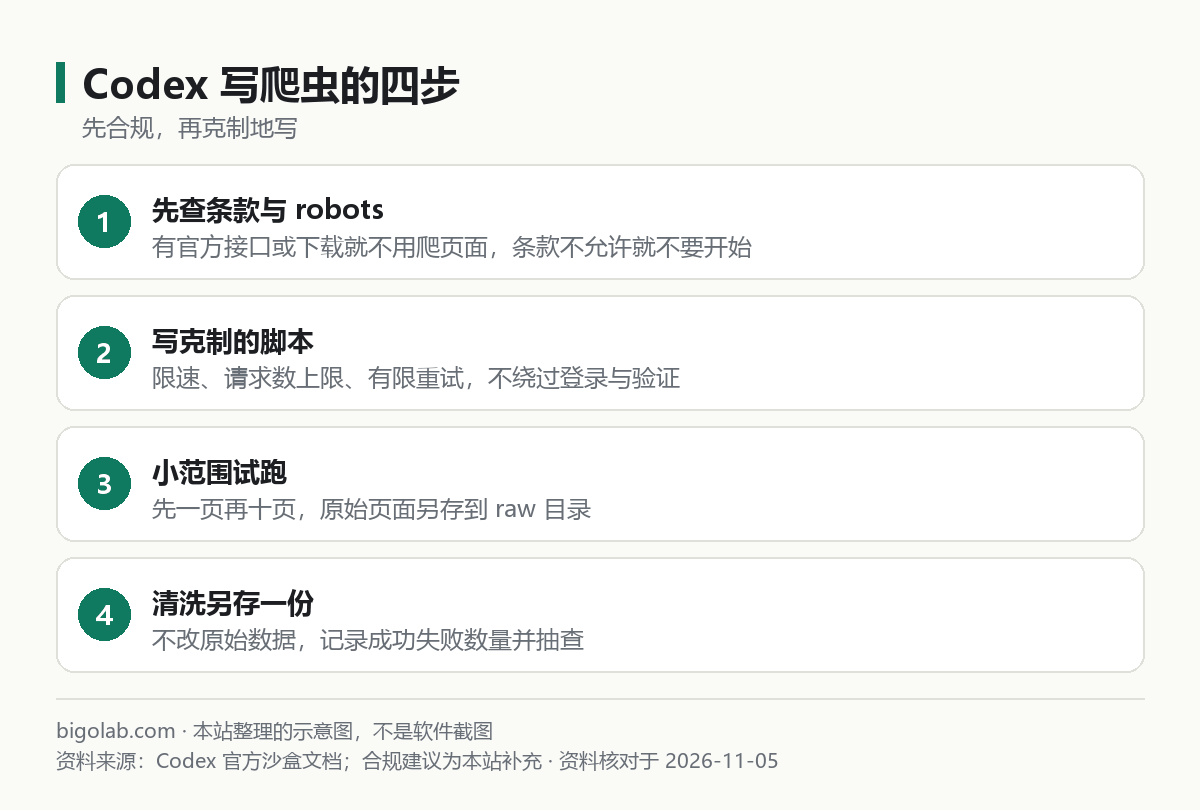
圖:本站根據 Codex 官方沙盒文檔和本站建議整理的示意圖
一、動手前的合規自查
下面是本站的一般性建議,不是 OpenAI 的規定,也不是法律意見:
- 服務條款:很多網站的條款裏寫明瞭是否允許自動化訪問和數據再利用,沒看過就不要開始;
- robots.txt:在網站域名後加
/robots.txt可以看到站點對爬蟲的訪問說明,應該遵守; - 有沒有官方接口:有 API 或數據下載就不要去抓頁面;
- 數據性質:個人資料、需要登入才能看的內容、有版權的內容,不要批量抓取和再發布;
- 訪問強度:別給對方伺服器造成壓力,限速、避開高峰;
- 用途:只用於自己的分析和學習,不要用來做對網站有害的事情。
用 AI 寫爬蟲不會改變這些責任,決定抓什麼、怎麼用的人是你。
二、Codex 的網絡限制,你要知道
- 本地:官方沙盒文檔說,預設的
workspace-write模式可以在工作區內讀寫、運行常規本地命令;需要越過沙盒邊界時(比如網絡訪問被攔截),按你的審批策略詢問。審批時官方建議選能讓任務繼續的最窄範圍。danger-full-access會去掉文件和網絡邊界,只在你確實想讓它完全自由時使用。詳見 /guides/codex-permissions-sandbox。 - 雲端:官方雲端聯網文檔(頁面標註為 Legacy 版)說,代理聯網按環境配置,可以完全關閉;開啟後可以用域名白名單和允許的 HTTP 方法來限制,甚至只允許
GET、HEAD、OPTIONS。 - 提示詞注入:官方在該頁提醒,開放聯網可能因提示詞注入導致敏感數據泄露或不安全的改動,所以只讓 Codex 訪問可信資源,並盡量限制聯網。
這對寫爬蟲的意義是:讓 Codex 寫腳本,和讓 Codex 自己去抓網頁,是兩件事。 前者只需要讀寫文件,風險小;後者要放開聯網,風險大。建議讓它寫好腳本,你檢查過之後自己在本機運行。
三、4 段可以直接複製的提示詞
方括號裏是要你自己填的內容。
1. 先評估,不寫代碼
我想從 [網站名稱 / 網址] 獲取 [具體數據,例如商品名稱和價格],用於 [個人分析]。
請先不要寫代碼,幫我評估:
1. 這個網站有沒有官方接口或可下載的數據,能不能不用爬頁面;
2. 我應該去哪裏查看它的服務條款和 robots.txt,要注意哪些條款;
3. 如果只能爬頁面,怎麼做才算剋制(限速、數量上限、只抓公開頁面)。
你不能替我判斷是否合法,只列出我需要自己核對的事項。
2. 寫一個剋制的抓取腳本
請用 [Python] 寫一個腳本,抓取 [目標頁面類型] 的 [字段列表],要求:
- 每次請求之間至少間隔 [2] 秒,總請求數上限 [50],失敗最多重試 [2] 次;
- 設定明確的 User-Agent,並寫上聯絡方式的佔位 [your-email];
- 遵守 robots.txt,不處理登入、驗證碼和反爬措施,遇到就停止並報告;
- 原始響應儲存到 raw/ 目錄,一頁一個文件,已下載過的不重複請求;
- 只寫腳本,先不要運行。寫完告訴我怎麼在本機運行、先用哪個參數小範圍試跑。
3. 清洗已有數據
raw/ 目錄裏是已經下載的網頁。請寫腳本把它們整理成 CSV:
- 字段:[字段列表],缺失值留空,不要補 0;
- 去掉重複記錄,保留來源網頁文件名作為一列,方便我回頭核對;
- 無法解析的文件單獨列出,不要悄悄跳過;
- 不修改 raw/ 裏的任何文件。
最後告訴我:處理了多少個文件、成功多少、失敗多少,以及抽查方法。
4. 網頁改版後修復
之前能用的腳本現在報錯了,網站可能改版。報錯如下:
[粘貼完整報錯]
請先對比 raw/ 裏新舊頁面的結構差異,說明哪些選擇器失效;再提出最小的修改。
不要增加請求頻率,也不要嘗試繞過任何訪問限制。
清洗數據時的核對方法,和 /guides/codex-clean-csv-excel-batch-data 一致:看行數帳、隨機抽查、確認空白沒有變成 0。
四、幾個容易出問題的地方
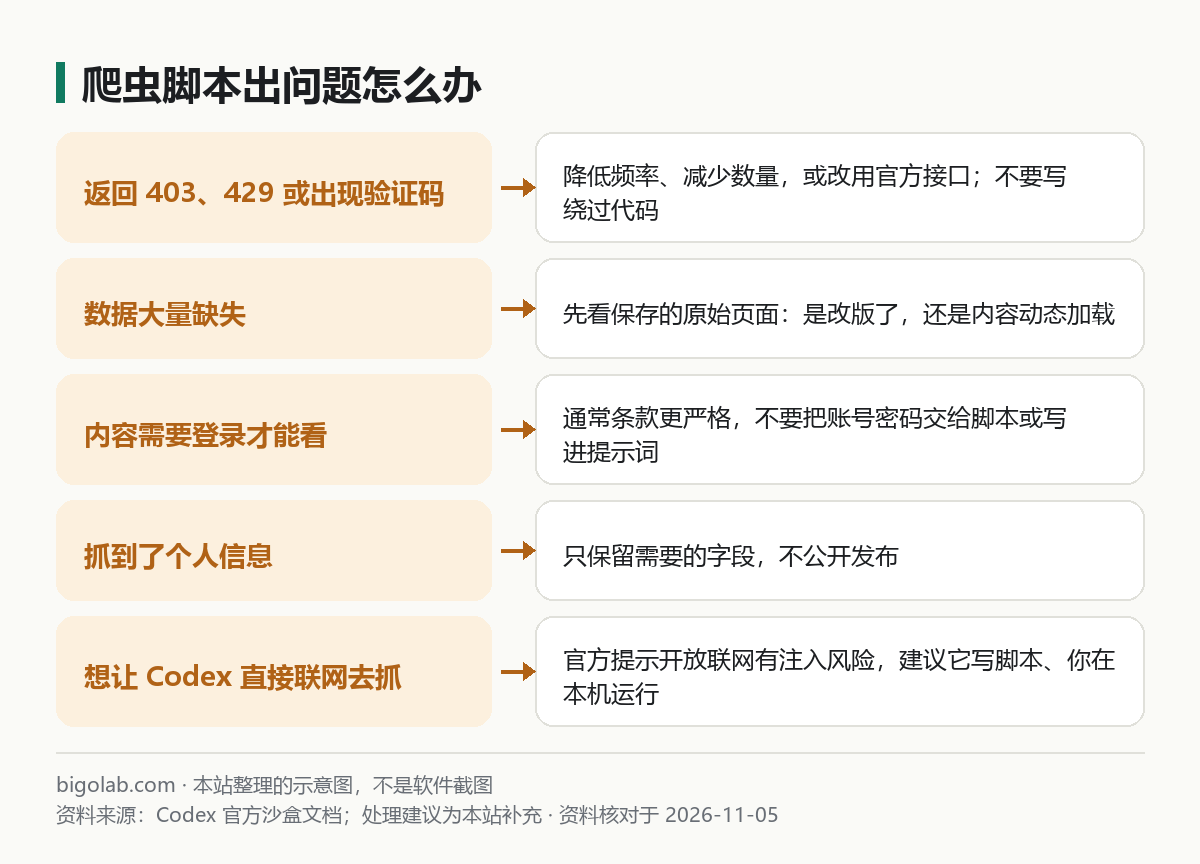
圖:本站根據 Codex 官方沙盒文檔和本站建議整理的示意圖
- 返回 403、429 或驗證碼:說明對方在限制自動訪問。降低頻率、減少數量,或者換用官方接口;不要讓 Codex 去寫繞過驗證的代碼;
- 數據大量缺失:先看儲存的原始頁面,是網頁改版了,還是內容是腳本動態加載出來的,再決定怎麼改;
- 內容需要登入:需要登入的內容通常有更嚴格的條款,別把帳號密碼交給腳本,也別寫進提示詞,見 /guides/ai-privacy-data-safety-checklist;
- 抓下來的數據裏有個人資訊:只保留你需要的字段,不要公開發布。
常見問題
Q:Codex 會拒絕寫爬蟲嗎?
官方文檔沒有說明這一點,是否拒絕取決於具體請求。無論它寫不寫,合規責任都在你。
Q:可以讓它直接聯網去抓嗎?
不建議。按官方提示,開放聯網存在提示詞注入的風險。讓它寫腳本,你檢查後在本機運行更穩妥。
Q:額度夠不夠?
寫腳本消耗不大,反覆調試會增加。Codex 隨 ChatGPT 套餐提供,額度以官方頁面為準,需要更多額度可以看看 /chongzhi/chatgpt-plus 裏的說明。
參考資料
- Codex 官方文檔:Sandbox — https://learn.chatgpt.com/docs/sandboxing
- Codex 官方文檔:Internet access(Legacy cloud)— https://learn.chatgpt.com/docs/cloud/internet-access
- Codex 官方文檔:Prompting — https://learn.chatgpt.com/docs/prompting
0 條評論
還沒有評論,來搶沙發~