
本文根據 OpenAI 官方《Image generation》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。代碼裏的模型名取自官方當天示例,請以官方模型頁為準。本站(bigolab.com)不是 OpenAI 官方網站。API 是按用量計費的獨立服務,與 ChatGPT 訂閱分開計算,Key 的獲取見 /guides/openai-api-key。
適用於誰
- 想在自己的程序裏“用文字生成圖片”或“改一張圖”的開發者;
- 在 Image API 和 Responses 的
image_generation工具之間拿不定主意的人; - 聽說 GPT Image 要組織驗證、不知道是不是影響自己的人。
結論先說
- 官方現在用兩個模型做圖像生成和編輯:
gpt-image-2.5-sunburst適合編輯精度最重要的流程,gpt-image-2.5-flare適合快速、高質素的日常生成。官方頁面還提到 GPT Image 2.6,但現有示例用的是 2.5,以官方模型頁為準。 - 有兩條路:Image API(
images.generate和images.edit),或者 Responses API 裏的內置image_generation工具。 - 選擇原則:只要從一個提示詞生成或編輯一張圖,用 Image API;要做對話式、可以反覆修改的圖片體驗,用 Responses API。
- 返回的是 Base64,需要自己解碼儲存成文件。
- 可能需要組織驗證:官方提示,使用 GPT Image 模型前,你可能需要在開發者控制檯完成 API Organization Verification,具體步驟看官方幫助文章。
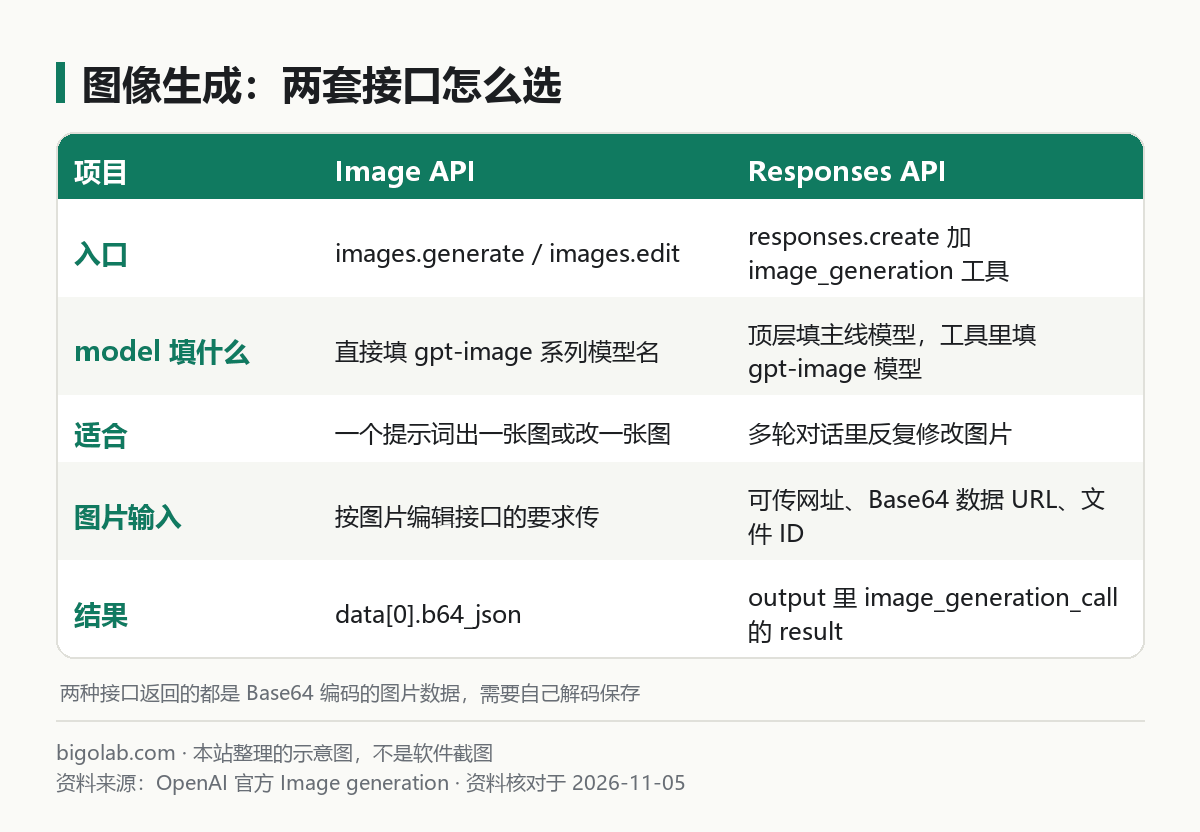
圖:本站根據 OpenAI 官方《Image generation》 整理的示意圖
一、用 Image API 生成一張圖
Python(先 pip install openai):
python
from openai import OpenAI
import base64

client = OpenAI()

prompt = "一幅兒童繪本風格的插畫:獸醫用聽診器給一隻小水獺聽心跳。"

result = client.images.generate(
    model="gpt-image-2.5-sunburst",  # 以官方模型頁當天為準
    prompt=prompt,
)

image_bytes = base64.b64decode(result.data[0].b64_json)
with open("otter.png", "wb") as f:
    f.write(image_bytes)
Node.js(儲存為 .mjs):
javascript
import OpenAI from "openai";
import fs from "fs";

const openai = new OpenAI();

const result = await openai.images.generate({
  model: "gpt-image-2.5-sunburst", // 以官方模型頁當天為準
  prompt: "一幅兒童繪本風格的插畫:獸醫用聽診器給一隻小水獺聽心跳。",
});

const imageBytes = Buffer.from(result.data[0].b64_json, "base64");
fs.writeFileSync("otter.png", imageBytes);
要一次出多張圖,用 n 參數;不寫預設返回一張。
二、用 Responses 的 image_generation 工具
在 Responses 裏,頂層 model 填一個支持該工具的主線模型,圖像模型寫在工具裏:
python
response = client.responses.create(
    model="gpt-6-astra",  # 主線模型,以官方模型頁當天為準
    input="生成一張圖:一隻灰色虎斑貓抱着一隻圍着橙色圍巾的水獺",
    tools=[{"type": "image_generation", "model": "gpt-image-2.5-sunburst"}],
)

image_data = [
    o.result for o in response.output if o.type == "image_generation_call"
]

if image_data:
    with open("cat_and_otter.png", "wb") as f:
f.write(base64.b64decode(image_data[0]))官方說,用這條路可以多輪編輯:把上一輪的 previous_response_id 帶上,再說“現在讓它更寫實一些”,就能在上一張的基礎上繼續改。工具裏有個可選參數 action:auto(讓模型自己決定是新生成還是編輯)、generate(總是新生成)、edit(強制編輯)。如果強制 edit 而上下文裏沒有圖片,會返回錯誤,所以一般保持 auto。
官方還說 Responses 請求的計費除了圖像生成,還包含主線模型本身的 token 用量。支持該工具的主線模型是 gpt-5 及更新的模型,具體到某個模型要看它的詳情頁。
三、尺寸、質素和格式
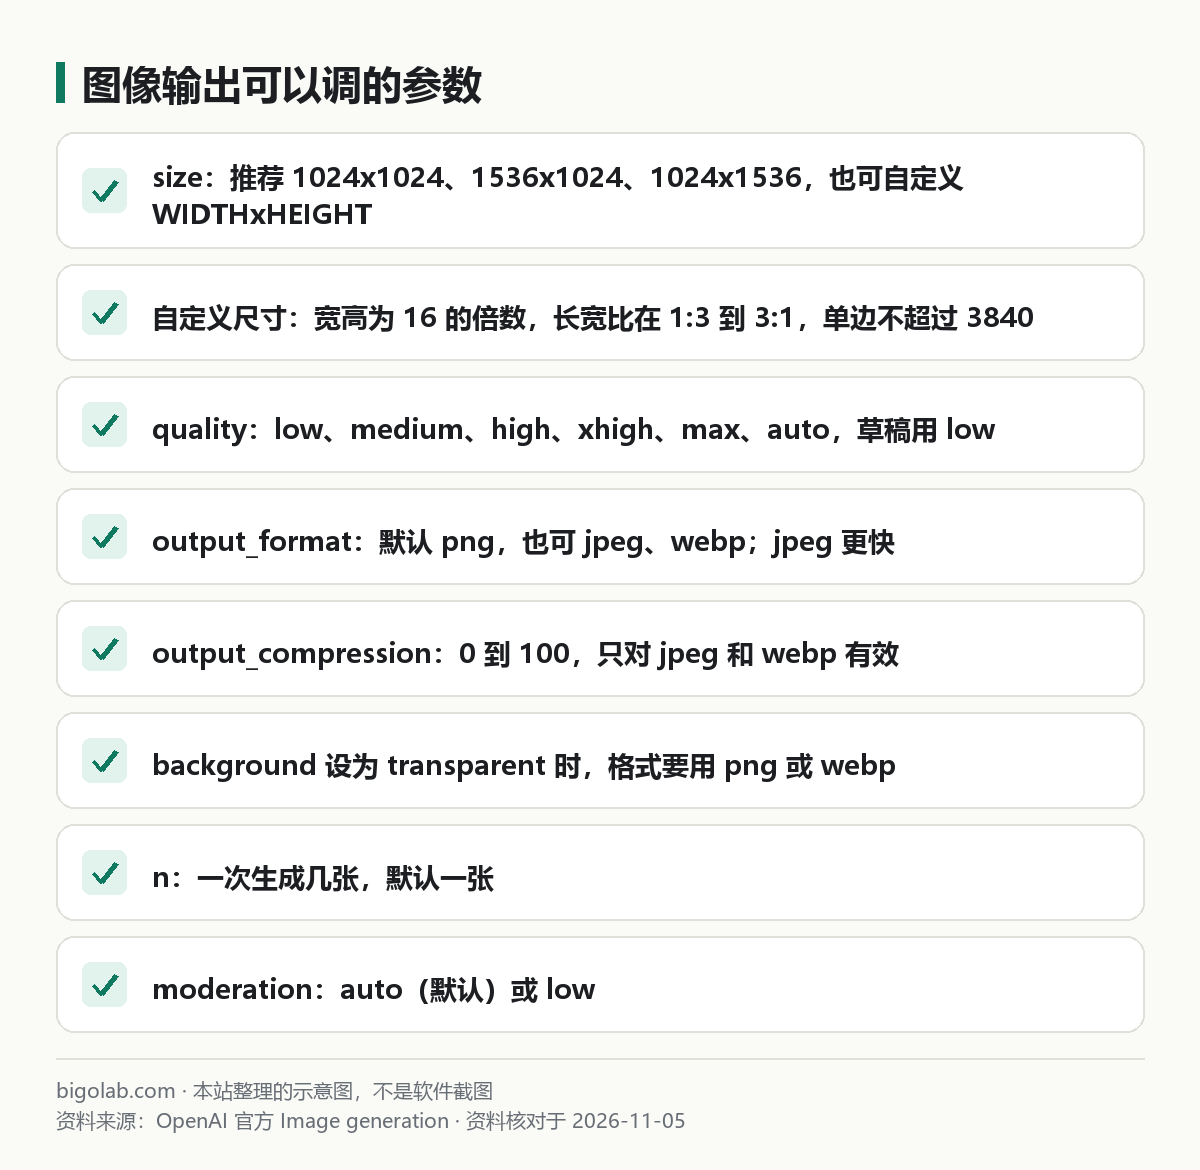
圖:本站根據 OpenAI 官方《Image generation》 整理的示意圖
官方列出的可配置項:
- size:推薦
1024x1024(方形)、1536x1024(橫)、1024x1536(豎)。兩個 2.5 模型也支持自定義WIDTHxHEIGHT,如1536x864,要求寬高是 16 的倍數、長寬比在 1:3 到 3:1 之間、單邊不超過 3840 像素,總像素在 655,360 到 8,294,400(4K)之間,超過2560x1440的解像度官方標為實驗性; - quality:
low、medium、high、xhigh、max、auto,預設auto。官方建議快速草稿用low,最終成品對比更高檔位,在細節、延遲和成本之間取平衡; - 格式:預設
png,也可以jpeg、webp。jpeg和webp可以用output_compression設 0 到 100 的壓縮率;官方說jpeg比png快,在意延遲時優先考慮; - 背景:要透明背景,設
background: "transparent",並用png或webp格式。
四、改圖與遮罩
Image API 的 images.edit 可以:編輯已有圖片;用其他圖片作參考生成新圖;上載圖片加遮罩,只替換遮罩標出的部分。官方遮罩示例(Python):
python
result = client.images.edit(
    model="gpt-image-2.5-sunburst",
    image=open("sunlit_lounge.png", "rb"),
    mask=open("mask.png", "rb"),
    prompt="陽光充足的室內休息區,泳池裏有一隻火烈鳥",
)

with open("composition.png", "wb") as f:
    f.write(base64.b64decode(result.data[0].b64_json))
遮罩的幾條規則:
- 原圖和遮罩格式、尺寸必須一致,且大小小於 50MB;
- 遮罩必須帶 alpha 通道,用圖片編輯工具做遮罩時要儲存 alpha 通道;官方還給了用 Pillow 給黑白遮罩補 alpha 通道的示例;
- 官方特別說明:GPT Image 的遮罩完全基於提示詞,模型把遮罩當作引導,不一定精確按遮罩的形狀來;
- 傳多張輸入圖時,遮罩作用在第一張上。
在 Responses 裏傳輸入圖,有三種方式:完整網址、Base64 數據 URL、文件 ID,寫法和視覺輸入一致,見 /guides/openai-api-image-input。
五、限制和被攔截時怎麼辦
官方列出的侷限:複雜提示詞可能要處理多達 2 分鐘;文字渲染雖然大幅改善,但仍可能在精確擺放和清晰度上出錯;同一角色或品牌元素在多次生成間可能不一致;對結構化、版面敏感的構圖控制有時不精確。
所有提示詞和生成的圖片都按官方內容政策過濾。moderation 參數可選 auto(預設,標準過濾)或 low(限制較少)。
出錯時的處理:
- 像對待其他 API 錯誤一樣,看 HTTP 狀態碼或 SDK 異常類型,記錄請求 ID;認證、配額、限速、伺服器錯誤見官方錯誤碼頁面,也可看 /guides/openai-api-error-codes;
- 有些失敗是用戶可以修正的,
error.type可能是image_generation_user_error,程序判斷請用error.code,例如moderation_blocked; - 不改提示詞或輸入圖,不要自動重試這類錯誤;配額錯誤同樣不要自動重試;臨時的限速和伺服器錯誤可以帶退避重試,限速的處理見 /guides/openai-api-429-error;
- 給最終用戶看的提示保持籠統,
moderation_details裏的階段(input、output、unknown)和粗粒度類別留給開發者日誌。
如果你的應用面向個人用戶,官方建議每個請求帶上一個穩定、保護私隱的 safety_identifier(對用戶名或電郵做哈希,不超過 128 個字符),推薦但非必需;舊的 user 參數已棄用。
六、費用
官方頁面寫有每百萬 token 的價格,並強調同樣的 token 價格不等於每張圖同價:不同模型和質素設定消耗的 token 不同,要看響應裏的 usage 來衡量。流式輸出局部圖(partial_images)每張局部圖額外增加 100 個圖像輸出 token。本文不抄價格,以官方價格頁當天為準,見 /guides/openai-api-price-official-table。
常見問題
Q:返回的怎麼沒有圖片連結?
GPT Image 返回的是 Base64 數據(b64_json),需要自己解碼儲存。
Q:提示 organization 需要驗證?
官方說使用 GPT Image 模型前可能需要完成 API Organization Verification,在開發者控制檯的組織設定裏辦理,具體看官方幫助文章,本站不代辦。
Q:想要矢量圖或動圖?
官方頁面提到 GPT Image 2.6 的 Image API 支持 SVG 和 GIF 輸出,對應 output_format 為 svg 或 gif。這些功能較新,本文沒有展開,寫法以官方當天頁面為準。
參考資料
- OpenAI 官方:Image generation — https://developers.openai.com/api/docs/guides/image-generation
0 條評論
還沒有評論,來搶沙發~