
本文根據 OpenAI 官方《Images and vision》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。代碼裏的模型名取自官方當天示例,請以官方模型頁為準。本站(bigolab.com)不是 OpenAI 官方網站。API 是按用量計費的獨立服務,與 ChatGPT 訂閱分開計算,Key 的獲取見 /guides/openai-api-key。
適用於誰
- 已經能用 Python 或 Node 發出第一個請求,想讓模型“看圖說話”、讀圖中文字的開發者;
- 做發票識別、截圖問答、商品圖描述等小工具的人;
- 想弄清楚“圖片到底怎麼塞進請求裏、會不會很貴”的人。
第一次調用的寫法見 /guides/openai-api-python-quickstart,本文預設你已經有可用的 Key 並能跑通文字請求。
結論先說
- 圖片放進
input裏某條用戶消息的content數組,一項文字(input_text)加一項或多項圖片(input_image)。 - 官方給了三種傳圖方式:完整網址、Base64 編碼的數據 URL、先用 Files API 上載再引用文件 ID。
detail控制圖片預處理,取值low、high、original、auto,不寫預設auto;具體哪個模型支持哪幾檔,要看官方當天的表。- 有硬限制:支持 PNG、JPEG、WEBP、非動畫 GIF;一次請求最多 1,500 張圖、負載總量最多 512 MB。
- 圖片按 token 計費,也佔速率限制裏的每分鐘 token 數。價格以官方價格頁當天為準,見 /guides/openai-api-price-official-table。
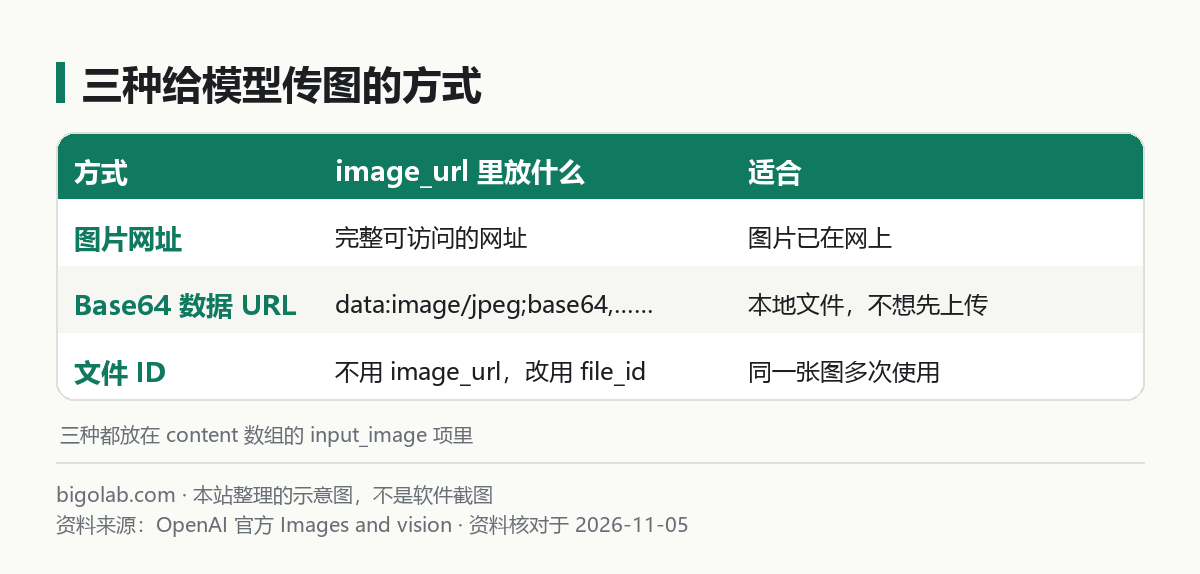
圖:本站根據 OpenAI 官方《Images and vision》 整理的示意圖
一、傳網址:最省事
如果圖片已經放在網上、而且能被公開訪問,直接給網址就行。官方示例的結構如下(Python):
python
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型頁當天為準
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "這張圖裏有什麼?"},
                {
                    "type": "input_image",
                    "image_url": "https://example.com/your-image.jpg",
                },
            ],
        }
    ],
)

print(response.output_text)
注意幾點:
content是個數組,文字和圖片是並列的兩項;- 網址必須是官方所說的“完整網址”(fully qualified URL),也就是帶
https://的; - 網址要能被 OpenAI 的服務訪問到,需要登入才能看的圖、只在公司內網能打開的圖,這種寫法不適用(這一條是本站根據“需要可訪問”做的推斷,請按自己的情況實測)。
二、傳 Base64:本地文件最常用
圖片在你自己的電腦上時,可以讀出來編碼成 Base64,再拼成數據 URL 放進 image_url。官方 Node 示例(儲存為 .mjs 文件運行):
javascript
import fs from "fs";
import OpenAI from "openai";

const openai = new OpenAI();

const base64Image = fs.readFileSync("example.jpg", "base64");

const response = await openai.responses.create({
  model: "gpt-6-astra", // 以官方模型頁當天為準
  input: [
    {
      role: "user",
      content: [
        { type: "input_text", text: "這張圖裏有什麼?" },
        {
          type: "input_image",
          image_url: `data:image/jpeg;base64,${base64Image}`,
          detail: "auto",
        },
      ],
    },
  ],
});

console.log(response.output_text);
Python 的寫法同理,官方示例用 base64.b64encode(...) 編碼後拼出 f"data:image/jpeg;base64,{base64_image}"。要點是數據 URL 開頭的類型要和實際文件格式一致:JPEG 寫 image/jpeg,PNG 寫 image/png。這一條是本站根據官方 PNG 示例(data:image/png;base64,)歸納的。
三、傳文件 ID:同一張圖多次用
官方說,也可以先用 Files API 上載文件,再在請求裏引用文件 ID。上載時 purpose 填 vision:
python
from openai import OpenAI

client = OpenAI()

with open("example.jpg", "rb") as f:
    uploaded = client.files.create(file=f, purpose="vision")

response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型頁當天為準
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "這張圖裏有什麼?"},
                {"type": "input_image", "file_id": uploaded.id},
            ],
        }
    ],
)

print(response.output_text)
這個寫法對應官方 Python 文件 ID 示例。上載一次、多次引用,比每次都重新編碼一大串 Base64 更省請求體積。
四、detail 怎麼選
官方的 detail 說明:
| 取值 | 官方說的適用場景 |
|---|---|
low | 粗略理解圖片。資源消耗隨模型而不同,官方特別說明 low 不一定比 high 用的 token 少 |
high | 標準的高保真理解,不需要原圖精確座標時用 |
original | 大圖、密集圖、對空間位置敏感的圖或 computer use,且模型支持時 |
auto | 用模型的預設處理方式 |
官方還提醒:做 OCR、找很小的物體、computer use 這類要看清細節或要精確座標的任務,在模型支持時用 "detail": "original"。需要精確座標時,建議先把圖片縮放到模型的限制內再發送,並把返回的座標映射回原圖。
不同模型支持的檔位不同。例如官方表裏,較老的 gpt-4o 系列只有 low、high、auto,沒有 original。所以模型名換了,detail 也要核對。
五、限制與費用
官方「Image input requirements」列出:
- 文件類型:PNG、JPEG、WEBP、非動畫 GIF;
- 請求大小:一次請求總負載最大 512 MB;
- 圖片數量:一次請求最多 1,500 張;
- 對按 patch 計 token 的模型,每張圖最多 30,000 個 patch;超過的圖會被拒絕,不會自動縮小,需要你自己先縮小尺寸再試。
費用方面,官方說圖片會轉換成可計費的輸入 token,並且也佔速率限制裏的每分鐘 token 數。想估算一張圖要多少 token,官方有「Image input cost calculator」,可以按模型、圖片尺寸和 detail 選擇估算。本文不寫單價,以官方價格頁當天為準。請求一旦觸發限流,處理方法見 /guides/openai-api-429-error。
六、官方列出的侷限
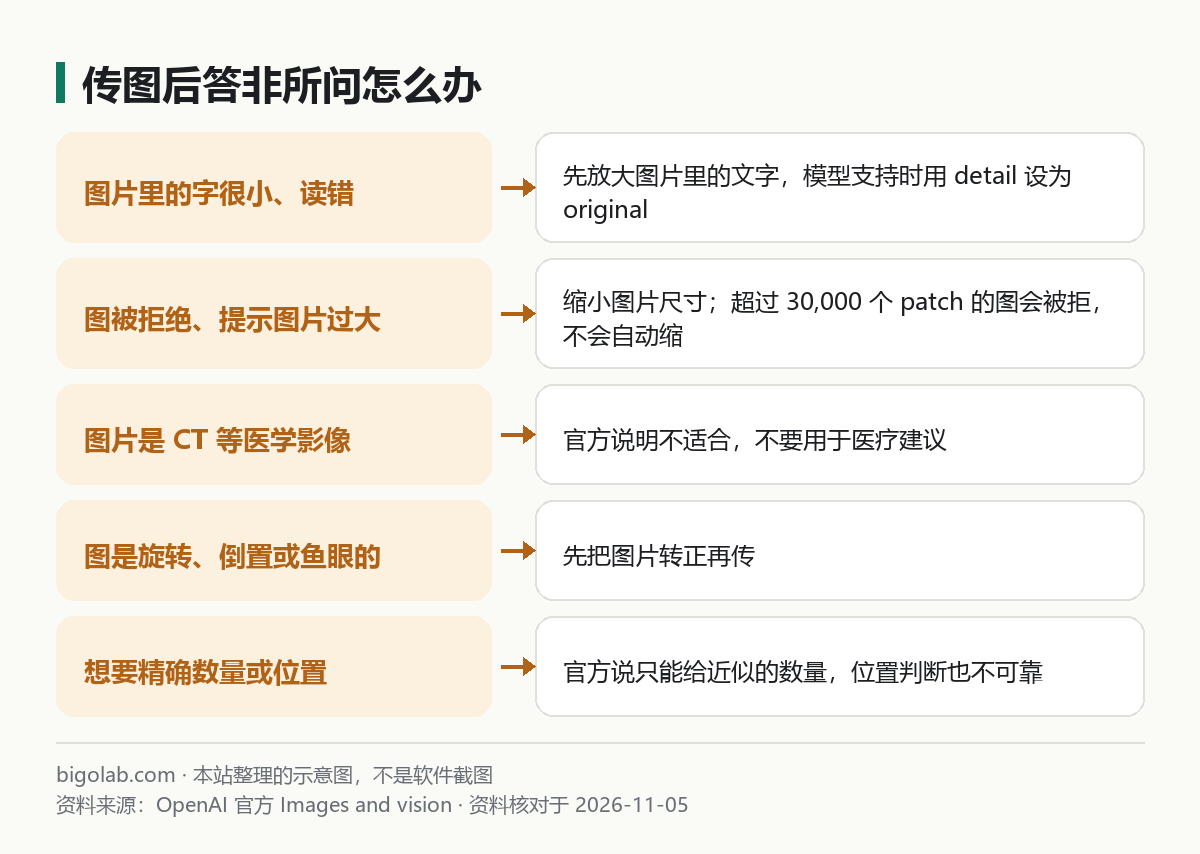
圖:本站根據 OpenAI 官方《Images and vision》 整理的示意圖,處理辦法為本站補充
官方在「Limitations」裏寫明視覺模型會犯錯,設計應用時要考慮:
- 醫學影像:不適合解讀 CT 等專業醫學影像,也不應當用來做醫療建議;
- 非拉丁文字:對日文、韓文等非拉丁字母的文字,效果可能不理想;
- 小字:把圖裏的文字放大;模型支持時也可用
original; - 旋轉:可能誤讀旋轉或倒置的文字和圖片;
- 圖表樣式:線條顏色、實線虛線點線混用時,可能看不懂;
- 空間推理:不擅長精確定位,官方舉的例子是識別棋盤局面;
- 準確性:生成的描述或標題可能不對;
- 圖片形狀:全景圖、魚眼圖效果不好;
- 元數據:模型不處理原始文件名和元數據,圖片分析前可能被縮放;
- 計數:給出的物體數量可能只是近似;
- 驗證碼:出於安全原因,系統會阻止提交 CAPTCHA。
所以別把模型的識別結果直接當最終結論。需要準確數字的場景(比如發票金額),建議讓程序再校驗一遍,這是本站的建議。
常見問題
Q:能一次傳多張圖嗎?
可以,在 content 數組裏放多項 input_image 即可。官方提醒每張圖都按 token 計費,數量越多越貴。
Q:和 Chat Completions 的傳圖寫法一樣嗎?
官方端點對照表裏 Chat Completions 也能分析圖片並返回文字,具體字段本文沒有核對,不展開。Responses 與它的區別見 /guides/openai-responses-api,本文只寫 Responses 寫法。
Q:想讓模型“畫圖”而不是“看圖”?
這是另一個能力,官方在同一頁的開頭區分了:生成圖片用 Images API 或 Responses 的圖像生成工具,不是 input_image。
Q:提示圖片格式不支持?
對照上面的格式表:動圖 GIF 不行,其他格式需先轉成 PNG、JPEG 或 WEBP。
參考資料
- OpenAI 官方:Images and vision — https://developers.openai.com/api/docs/guides/images-vision
0 條評論
還沒有評論,來搶沙發~