
本文根據 Google 搜尋中心《robots.txt 簡介》、RFC 9309、Python 官方《urllib.robotparser》、pandas 官方文檔和 Claude Code 官方《Best practices for Claude Code》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是介面截圖。本站(bigolab.com)不是 Anthropic 官方網站。
適用於誰
- 想抓一些公開網頁上的資訊(價格、文章列表、公開統計)做整理的人;
- 手裏有一堆亂七八糟的表格或抓來的數據,想讓 Claude Code 寫清洗腳本的人;
- 想知道「哪些能抓、哪些不該抓」的新手。
先說邊界:本文只寫遵守規則的做法。 網站明確禁止抓取、需要登入才能看的內容、含個人資料的頁面,不在本文範圍內;遇到驗證碼、攔截,就停下來,別去繞。
結論先說
- 先看規則再動手。 網站的
robots.txt(域名根目錄下)是網站對爬蟲的訪問說明。Google 官方說它主要用來避免請求過多壓垮網站,不是讓網頁不被收錄的機制;RFC 9309 則明確寫了:這些規則不是一種訪問授權,也不能代替真正的內容安全措施。 - robots.txt 不具備強制力。 Google 官方說,是否遵守取決於爬蟲自己。所以「robots.txt 沒寫禁止」不等於「可以隨便抓」,你還要看網站的使用條款,和這些數據本身是否涉及版權、個人資料。
- Python 標準庫就能檢查規則。
urllib.robotparser的RobotFileParser有can_fetch()判斷某個 User-Agent 標識能不能抓某網址,還有crawl_delay()、request_rate()讀取網站要求的抓取間隔。 - 禮貌抓取:限速、小樣本先試、標明身份、儲存原始頁面,這幾條是通用做法。
- 清洗和抓取分開。 先把原始數據存下來,清洗腳本只讀原始數據,不要邊抓邊洗。
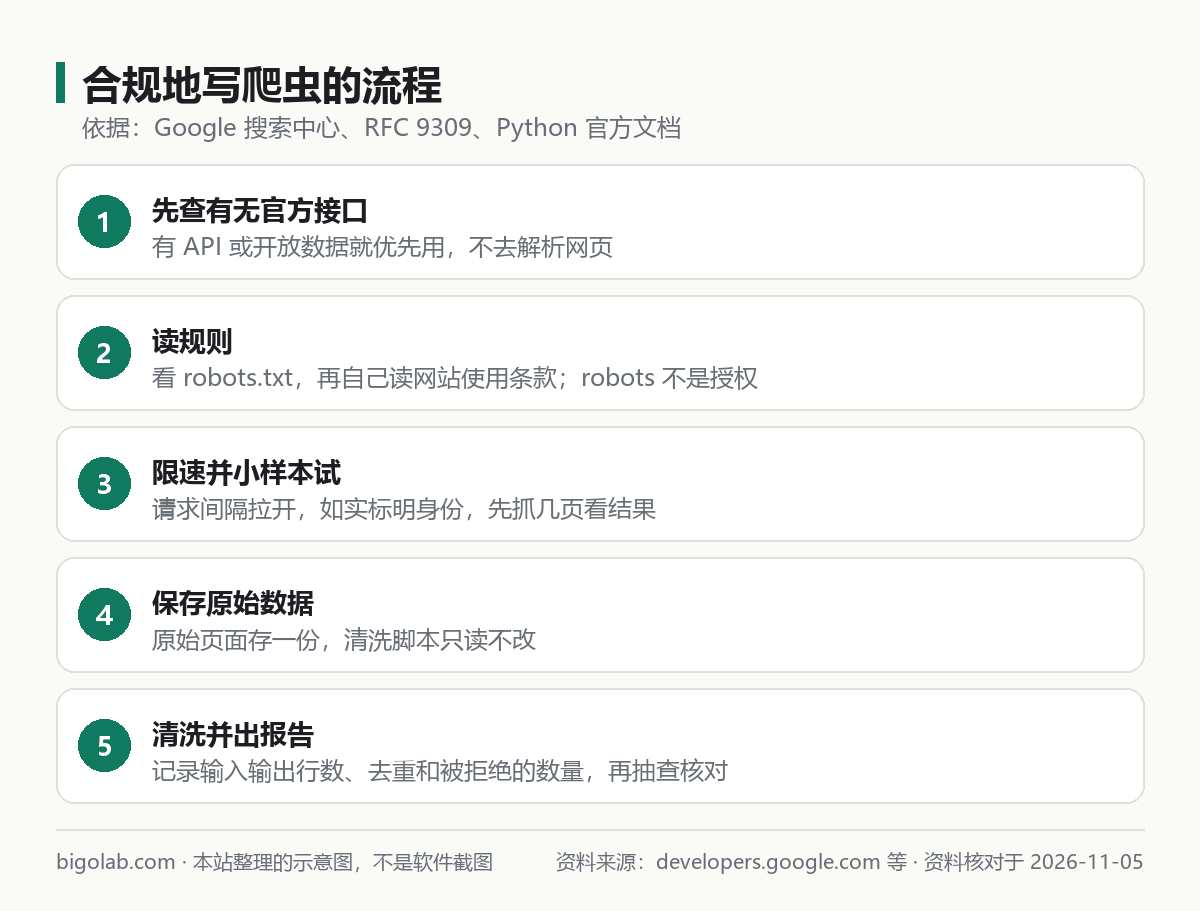
圖:本站根據 Google 搜尋中心:robots.txt 簡介 整理的示意圖
第一步:先查規則,不寫代碼
提示詞 1:合規檢查,只讀不抓
text
我想從【網站地址】抓取【公開的商品列表:名稱、價格、連結】,用於【個人比價,不公開發布】。
請先不要寫爬蟲。只做這些事:
1)讀取該網站的 robots.txt,說明針對通用爬蟲(*)的規則裏,我要抓的路徑是否被禁止,有沒有 Crawl-delay;
2)告訴我該網站的使用條款一般放在哪裏,我需要自己讀哪幾個關鍵點(是否禁止自動化訪問、是否限制商用、版權聲明);
3)這個網站有沒有官方 API 或數據下載,如果有,優先建議用它;
4)如果存在任何禁止的跡象,請明確建議我不要抓取。
很多網站有官方 API 或開放數據,用它比解析網頁穩定得多,也更合規,這條是通用建議。
第二步:用標準庫自檢規則
讓 Claude 寫一個小檢查腳本,用的是 Python 官方文檔裏的類:
python
import urllib.robotparser

rp = urllib.robotparser.RobotFileParser()
rp.set_url("https://example.com/robots.txt")
rp.read()
print(rp.can_fetch("MyResearchBot", "https://example.com/products"))
print(rp.crawl_delay("MyResearchBot"))這是按官方文檔裏的方法名(set_url、read、can_fetch、crawl_delay)拼的示例,把地址和名稱換成你自己的。can_fetch 返回 False 就說明按規則不該抓。注意:它只讀 robots.txt,不讀網站條款。
第三步:寫抓取腳本,限速、小樣本
提示詞 2:禮貌的抓取腳本
text
請用 Python 寫一個抓取腳本,抓取【商品列表頁】,要求:
1)開始前用 urllib.robotparser 檢查每個網址是否允許抓取,不允許就跳過並記錄;
2)請求之間至少間隔 【3】 秒;如果 robots.txt 裏有 Crawl-delay,以較大的為準;
3)User-Agent 如實寫明腳本用途和我的聯絡電郵【你的電郵】,不要偽裝成瀏覽器;
4)遇到 403、429 或任何攔截提示,立即停止並告訴我,不要重試繞過,不要換身份;
5)每個頁面的原始 HTML 儲存到 raw/ 目錄,文件名用網址的哈希;已儲存的不要重複抓;
6)先只抓 5 個頁面做試驗,給我看結果,我確認後才抓更多。
第 3 條和第 4 條是底線:不隱藏身份,被攔就停。先小範圍試、看結果、再擴大,是通用的穩妥做法。
第四步:數據清洗
清洗腳本只讀 raw/,輸出到 clean/,不改原始文件。常見的坑:價格裏帶貨幣符號和逗號、日期格式不統一、重複行、缺失值。
pandas 官方文檔裏有現成的方法:pandas.to_numeric(列, errors='coerce') 把無法解析的值變成空值(NaN),不會直接報錯;DataFrame.drop_duplicates(subset=..., keep='first') 按指定列去重並選擇保留哪一行;DataFrame.to_csv(..., index=False) 寫文件時不帶行號。
提示詞 3:清洗腳本,保留清洗日誌
text
請寫一個清洗腳本,讀取 raw/ 解析出的數據(或 data.csv),輸出 clean/products.csv:
1)價格列去掉貨幣符號和千位逗號,轉成數字;無法解析的值置為空,並把對應行寫入 clean/rejected.csv,附原因;
2)按【商品連結】去重,保留最早的一條;
3)日期統一成 YYYY-MM-DD;
4)不要覆蓋原始數據;
5)運行後輸出一段清洗報告:輸入多少行、輸出多少行、去重多少、被拒絕多少、每列的空值數量。
先用 20 行樣例測試,再跑全量。
最後一條「清洗報告」很重要:輸入行數、輸出行數對不上,說明有數據被悄悄丟了。
提示詞 4:數據質素抽查
text
請從 clean/products.csv 隨機抽取 20 行,與 raw/ 裏對應的原始頁面逐項核對(名稱、價格、連結),列出不一致的行和原因。
再檢查:價格有沒有明顯異常值(比同類高或低幾十倍),有沒有同一商品出現多次。只報告,不修改。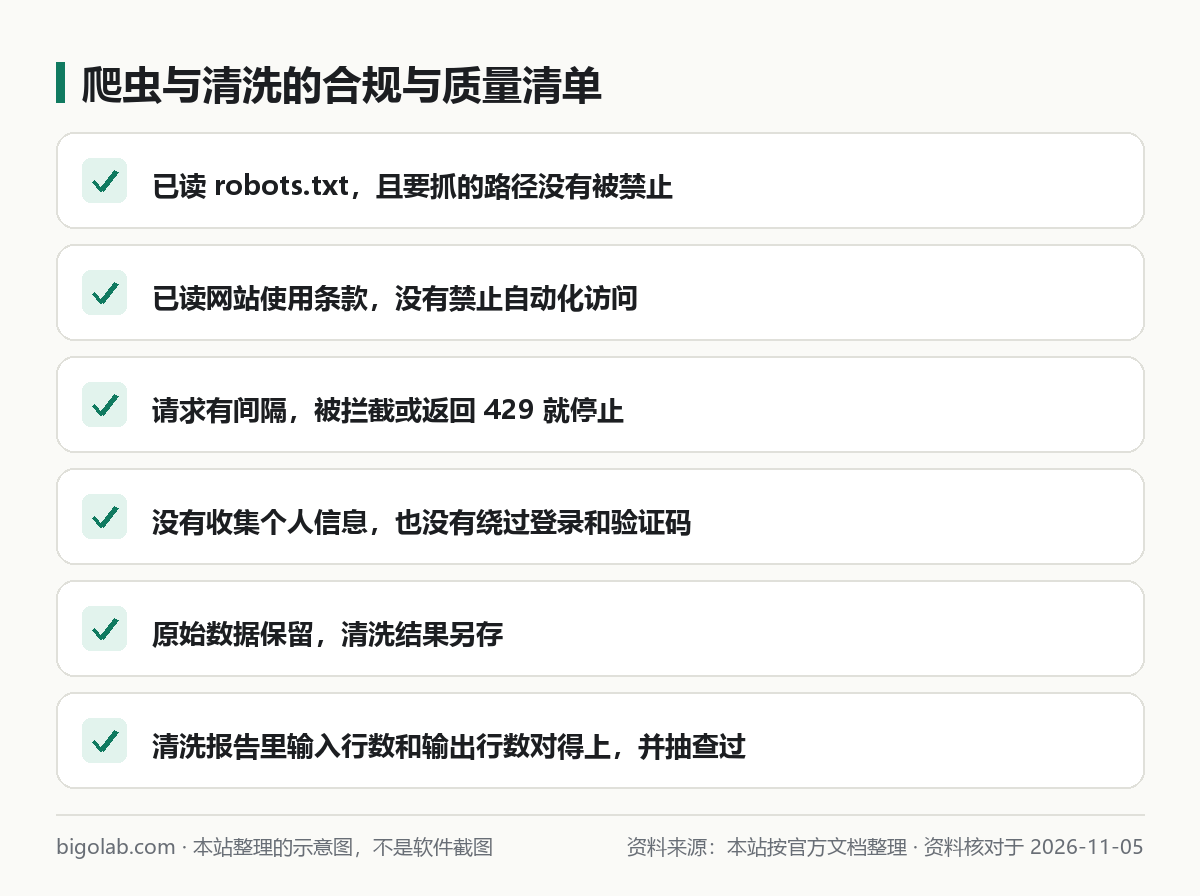
圖:本站根據官方文檔整理的示意圖
被攔住了怎麼辦
如果腳本收到 403、429,或者頁面出現驗證碼,說明網站不希望你這樣訪問。正確的反應是停下來:降低頻率、縮小範圍,或者換成官方的數據接口、聯絡網站方詢問授權,而不是讓 Claude 想辦法繞過去。讓 Claude 在腳本里把這個規則寫死,一旦遇到攔截就退出並把狀態碼寫進日誌,這樣即使你不盯着,腳本也不會一直敲門。把這條要求寫進項目的 CLAUDE.md 也可以,後續會話都會遵守。
不該碰的事
- 需要登入才能看的內容、付費內容,不要為了抓取而共享帳號或繞過限制;
- 個人資料(手機號、電郵、住址等),別大批量收集,涉及法律問題請諮詢專業人士;
- 抓到的內容,版權仍屬原作者;個人研究和公開發布、商用的要求不同;
- 看到網站明確寫「禁止自動化訪問」,就不要抓。
常見問題
Q:robots.txt 沒有禁止我就能抓嗎?
不一定。它不是授權,網站條款、版權、個人資料規定都要看。官方 RFC 也明說,這些規則不是訪問授權。
Q:網頁是 JavaScript 動態加載的,抓不到內容怎麼辦?
先看有沒有官方 API。需要真正渲染頁面時可以用瀏覽器自動化,見 /guides/claude-code-playwright-mcp-browser-testing,同樣要遵守上面的規則。
Q:想做給 AI 用的網頁抓取?
可以參考站內的 /guides/firecrawl-web-scraping-for-llm-quickstart,同樣要先確認合規。
訂閱和額度
寫腳本、跑清洗會話不長,但調試抓取常要來回多輪。訂閱選擇見 /chongzhi/claude-code,價格和額度以官方頁面當前顯示為準。
相關教學
- /guides/claude-code-python-automation-script-beginner:寫 Python 自動化腳本
- /guides/claude-code-organize-files-rename-spreadsheets:處理表格
- /guides/firecrawl-web-scraping-for-llm-quickstart:Firecrawl 快速上手
參考資料
- Google 搜尋中心:robots.txt 簡介 — https://developers.google.com/search/docs/crawling-indexing/robots/intro
- RFC 9309:Robots Exclusion Protocol — https://datatracker.ietf.org/doc/html/rfc9309
- Python 文檔:urllib.robotparser — https://docs.python.org/3/library/urllib.robotparser.html
- pandas 文檔:pandas.to_numeric — https://pandas.pydata.org/docs/reference/api/pandas.to_numeric.html
- Claude Code 文檔:Best practices for Claude Code — https://code.claude.com/docs/en/best-practices
0 條評論
還沒有評論,來搶沙發~