
本文根據 Codex / ChatGPT 官方用例《Clean and prepare messy data》《Consolidate spreadsheets》和《Prompting》整理,資料核對於 2026-11-05。配圖為本站整理的示意圖,不是軟件截圖。本站(bigolab.com)不是 OpenAI 官方網站。安裝與配置見 /guides/codex-getting-started,本文只講怎麼交代數據任務。
適用於誰
- 手裏有一份系統導出的 CSV 或表格,日期格式不統一、金額帶貨幣符號、有重複行,想整理成能直接用的版本的人;
- 每月要把幾份導出合成一份報表的人;
- 不想自己寫公式、寫腳本,但又擔心“一整理就把原始數據弄壞”的人。
結論先說
- 官方的核心做法:讓它清洗一份副本,原文件保持不變。 官方用例明確寫了“write a cleaned copy while keeping the original file unchanged”。
- 把你已經看到的問題逐條寫出來,再說清想要什麼結果(清洗後的 CSV、一個新的表格頁,還是可以直接上載的文件)。
- 讓它附一份簡短的數據質素說明:改了什麼、刪了什麼、哪些行拿不準。用之前先打開清洗後的文件和這份說明。
- 合併多份表格時,先說清連接鍵,並要求對不上的記錄單獨列出來複查,不要讓它猜、不要讓它悄悄合併有衝突的記錄。
- 清洗結果要自己抽樣核對,官方沒有保證結果一定正確。
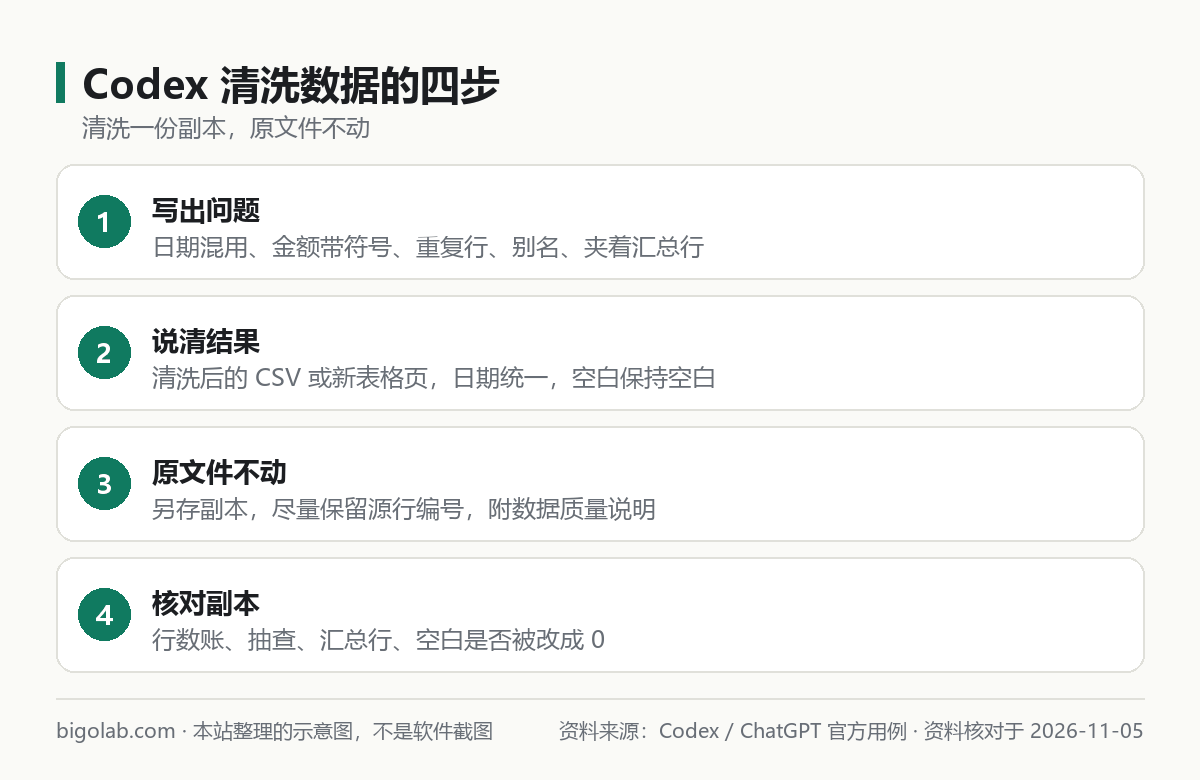
圖:本站根據 官方用例《Clean and prepare messy data》 整理的示意圖
一、先把文件和問題準備好
官方用例的用法很簡單:把文件拖進去,或者在提示詞裏用 @ 點名,例如 @customer-export.csv。然後做三件事:
- 描述你已經看到的問題。 官方示例列了幾類常見問題:日期在兩種寫法之間混用、金額裏有貨幣符號、逗號和空白單元格、重複導出造成的重複客戶行、同一個地區或類別有多種寫法、混進來的粘貼彙總行。
- 說清想要的結果:清洗後的 CSV、表格裏新增一頁,或可直接上載到別的系統的文件。
- 說明邊界:原文件不動、空白金額保持空白(不要補成 0)、盡量保留源行編號以便回頭對照。
官方《Prompting》也提到,大任務可以按“目標、背景、輸出、邊界”來組織提示詞,只寫有用的部分,不必每項都填。數據清洗正好適合這個結構:目標是乾淨的副本,背景是文件和問題清單,輸出是文件格式加質素說明,邊界是原文件不動。
如果你的 Codex 在命令行或 IDE 裏運行,文件要放在它能訪問的工作目錄裏。它能讀寫哪些目錄由沙盒和審批設定決定,見 /guides/codex-permissions-sandbox。
二、4 段可以直接複製的提示詞
方括號裏是要你自己填的內容。
1. 清洗一份導出文件
請清洗 @[文件名]。
我已經發現的問題:
- 日期混用了 [MM/DD/YYYY] 和 [YYYY-MM-DD] 兩種寫法
- 金額列裏有貨幣符號、千分位逗號和空白單元格
- 有幾行客戶記錄是重複導出造成的
- [地區 / 類別] 有多種叫法
- 數據中間夾着粘貼進來的彙總行
我要的結果:
- 另存為一份清洗後的 CSV,原文件保持不變
- 日期統一為 [YYYY-MM-DD]
- 空白金額保持空白,不要補 0
- 盡量保留原始行編號
- 再給我一份簡短的數據質素說明:改了什麼、刪了多少行、哪些行你不確定
2. 先只看、不改:摸清數據有什麼問題
我還不清楚 @[文件名] 裏有哪些問題。請先只讀不改:
1. 列出每一列的含義和你推測的數據類型;
2. 找出格式不一致、重複、缺失、明顯異常的值,各給 3 個例子和所在行號;
3. 告訴我清洗時有哪些地方需要我做決定(比如重複行保留哪一條)。
先不要生成任何文件。
3. 合併多份導出
請把 @[文件一]、@[文件二]、@[文件三] 合併成一個表格。
- 用 [客戶編號] 作為連接鍵,重複記錄的處理規則是:[保留最新一條]
- 計算 [每個客戶本月合計金額],並和 @[目標文件] 裏的目標對比
- 單獨做一頁“複查”:列出對不上的鍵和沒能合併的記錄
- 另外寫一頁“說明”:假設、口徑和下次刷新的步驟
不要編造連接鍵,不要悄悄合併有衝突的記錄,保留原始導出文件不動。
4. 模擬下次刷新
假設下個月我換上新的導出文件,請檢查這套流程:
- 哪些輸入可以直接替換而不用改流程;
- 哪些公式、連接和圖表會正確更新;
- 有沒有重複或對不上的鍵;
- 哪些假設沒有寫進說明;
- 哪些步驟還需要人工判斷。
不要覆蓋源文件,也不要改變業務口徑。
第 3、4 段的思路來自官方《Consolidate spreadsheets》用例:先把連接鍵、重複規則、口徑說清,再讓它把有問題的記錄隔離出來,最後測試一次下次刷新。
三、清洗完之後怎麼核對
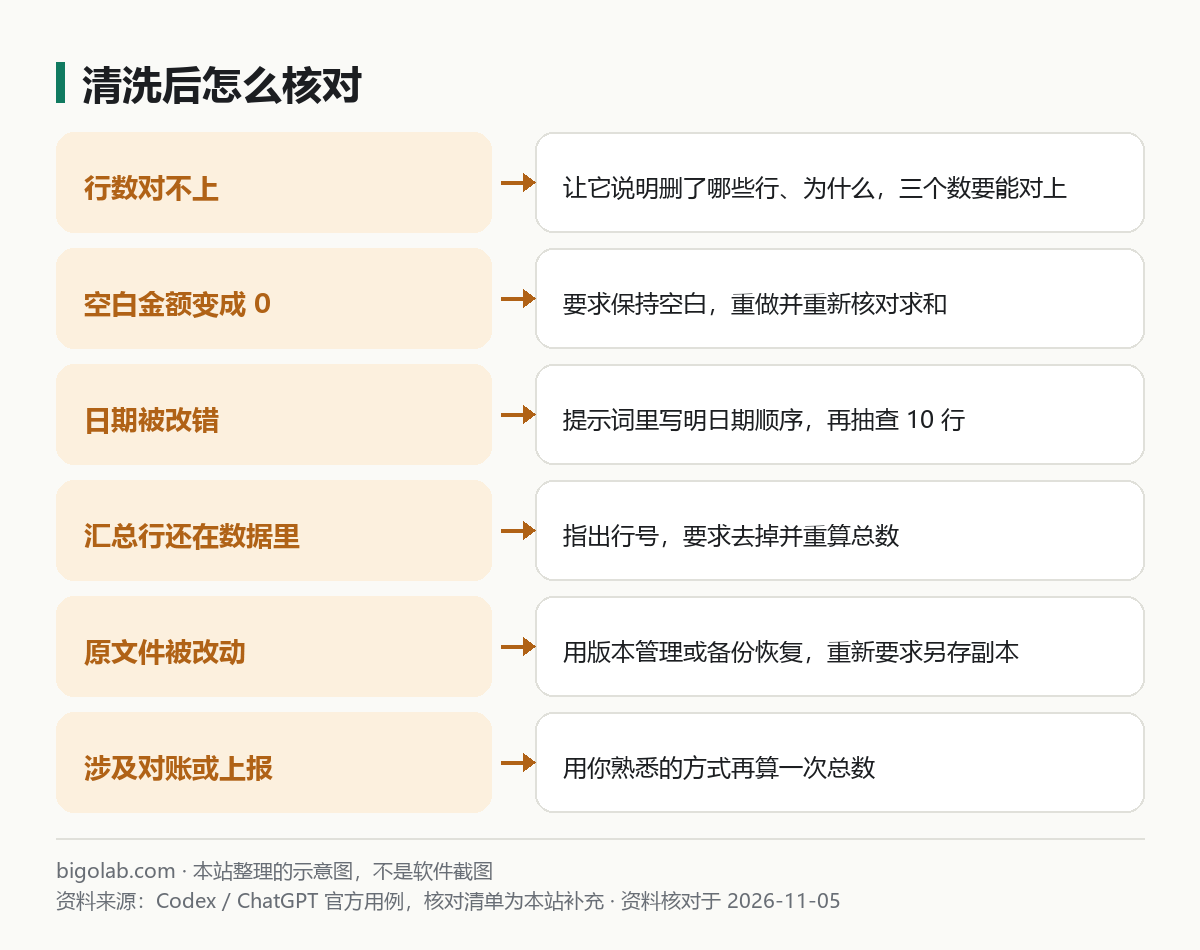
圖:本站根據 官方用例《Clean and prepare messy data》 整理的示意圖
官方建議是:先打開清洗後的文件和聊天裏的數據質素說明,再用於下游。下面是本站補充的核對清單,不是官方清單:
- 行數帳:原文件多少行、清洗後多少行、刪了多少行,三個數要對得上,說明裏要有解釋;
- 隨機抽查:隨便挑 10 行,和原文件逐項對比,尤其是日期和金額;
- 彙總行:混進數據裏的合計行是否都去掉了,沒有被當成普通數據算進總數;
- 空白與零:空白金額沒有被改成 0,否則求和、平均值都會變;
- 原文件:確認原文件的修改時間沒變,必要時對比一下文件大小;
- 重要數據:財務、對帳、要上報的數據,清洗後用你熟悉的方式再算一次總數。
發現問題就把具體的行號和現象發給它,讓它說明原因再改,不要只說“有錯”。
四、幾個容易踩的點
- 不要把含身份證號、手機號、銀行帳號的原始文件直接交出去。 先脫敏或只取需要的列,檢查清單見 /guides/ai-privacy-data-safety-checklist;
- 日期的歧義要你來裁決。
03/04/2026是 3 月 4 日還是 4 月 3 日,文件本身可能判斷不出來,提示詞裏要寫明; - 一次只處理一類問題,先去重、再統一格式、最後合併,每一步都核對,比一次性“全部搞定”更可靠;
- 把常用規則存起來。 同類文件每月都要清洗的話,可以把規則寫進 AGENTS.md,見 /guides/codex-agents-md-how-it-reads。
如果你更習慣在 ChatGPT 網頁裏直接傳表格分析,可參考 /guides/chatgpt-excel-data-analysis。
常見問題
Q:它說清洗好了,但數字和我手算的不一樣?
把兩邊的差異、涉及的行和你的算法告訴它,要求它先說明差異的來源,再改。不要在沒弄清口徑之前反覆讓它“再算一遍”。
Q:文件很大怎麼辦?
先讓它讀取表頭和前幾十行,確認結構,再分步處理。官方沒有給出文件大小上限,實際限制以當前版本為準。
Q:需要多少額度?
Codex 隨 ChatGPT 套餐提供,額度以官方頁面為準。數據任務如果來回修改次數多,消耗會更大,需要更多額度可以看看 /chongzhi/chatgpt-plus 裏的說明。
參考資料
- Codex / ChatGPT 官方用例:Clean and prepare messy data — https://learn.chatgpt.com/use-cases/clean-messy-data
- Codex / ChatGPT 官方用例:Consolidate spreadsheets — https://learn.chatgpt.com/use-cases/consolidate-spreadsheets
- Codex / ChatGPT 官方文檔:Prompting — https://learn.chatgpt.com/docs/prompting
0 條評論
還沒有評論,來搶沙發~