
结论先说
- 文件系统隐喻 + 客户端自有存储:启用
memory_20250818工具后,Claude 会把/memories当成它的专属长期笔记本进行读写,而底层到底存成本地文件、PostgreSQL 记录还是云端对象存储,完全由你的后端代码决定。 - 开局自动先查记忆,无需手写冗长提示词:只要挂载了该工具,服务端会自动向模型注入标准系统指引,让它在处理任务前先检查
/memories目录有没有历史记录,并在习得关键偏好或阶段性结论时主动更新文件。 - 内置六个标准子命令:客户端只需按约定实现
view、create、str_replace、insert、delete和rename六个分支,并通过tool_result返回文本反馈。 - 安全第一条是防目录穿越:客户端必须强制校验所有目标路径落在当前用户的隔离
/memories根目录内,拦截一切..或符号链接跳出行为。 - 国内免卡开通与账号服务入口:自有账号免上号自助开通可见本站 Claude Pro 充值页 与 Claude Max 充值页;缺可用账号或遇身份核验可查看 Claude 注册说明 与 Claude KYC 认证协助。
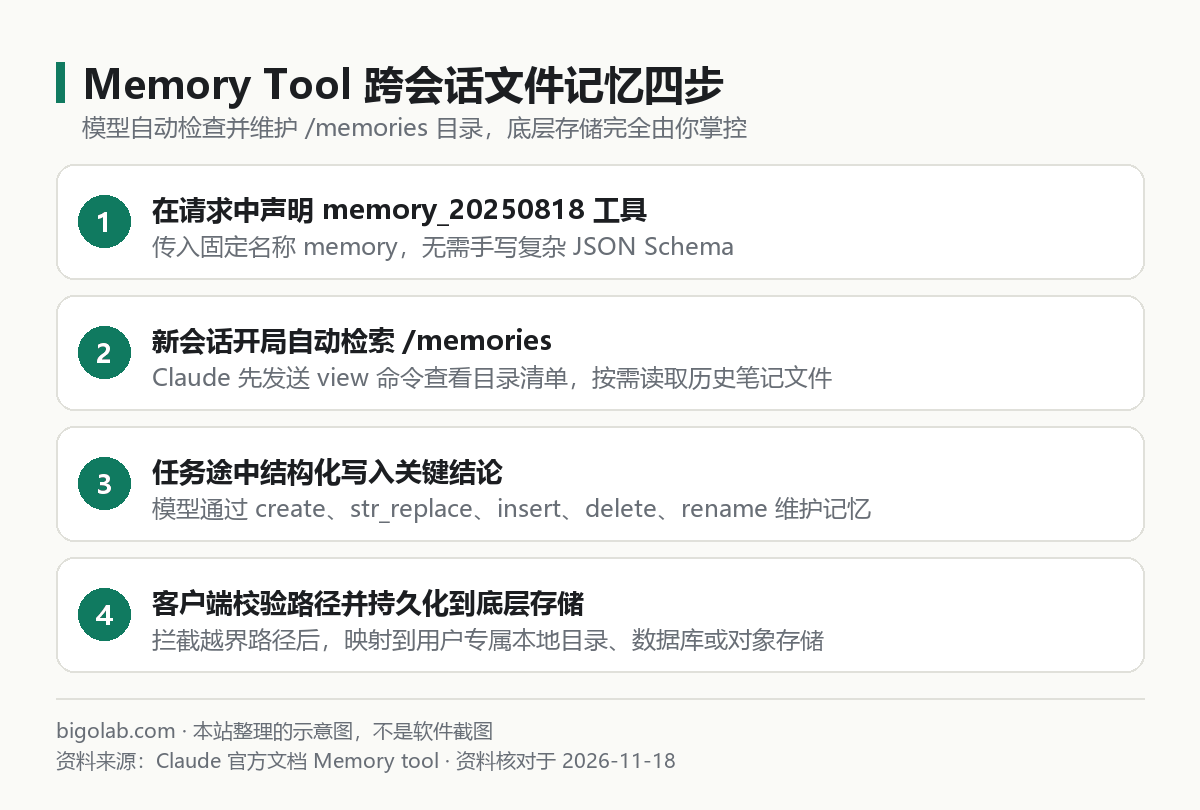
图:本站根据 Claude 官方文档:Memory tool 整理的示意图
本文根据 Claude 开发者平台官方文档《Memory tool》整理,资料核对于 2026-11-18。配图为本站整理的示意图,不是界面截图。本站(bigolab.com)不是 Anthropic 官方网站。
适用于谁
- 搜「claude api memory tool」「memory_20250818 怎么用」,想给自研客服、助理或研发智能体加上跨会话长期记忆的开发者;
- 不想一上来就搭一套笨重的向量检索(RAG)管线,希望让模型像记 Markdown 笔记一样自己增删改查结构化记忆的人;
- 需要把用户记忆完全留在自有数据库或内网存储里以满足数据合规要求的团队。
如果你只是在 claude.ai 网页版里使用官方现成的个人对话记忆功能,请直接看 /guides/claude-memory。
一、最小请求写法与 /memories 目录约定
在 Messages API 请求里挂载记忆工具非常简洁,type 填 memory_20250818,name 固定填 memory(若搭配服务端上下文管理策略使用,可在 SDK 的 betas 参数中一并带上 context-management-2025-06-27):
python
import anthropic

client = anthropic.Anthropic()

response = client.beta.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    tools=[
        {
            "type": "memory_20250818",
            "name": "memory",
        }
    ],
    messages=[
        {"role": "user", "content": "继续帮我跟进上周的接口重构方案,记得按我习惯的测试框架写。"}
    ],
    betas=["context-management-2025-06-27"],
)

for block in response.content:
    if block.type == "tool_use" and block.name == "memory":
        print(block.input)
发出这条请求后,模型第一反应通常是产出一个 tool_use 块:{"command": "view", "path": "/memories"}。
这里的 /memories 是模型视角下的逻辑虚拟根目录,绝不是让你真的去写宿主服务器操作系统的根分区 /memories。在多用户 Web 应用里,标准做法是在后端把它映射成 ./storage/users/{user_id}/memories/ 或数据库里的 (user_id, virtual_path, content) 行记录。对模型而言它始终在操作干净的 /memories/preferences.md,而不同租户的数据在物理层彻底隔离。
二、客户端六个子命令的实现规格
和普通工具调用一样(基础循环见 /guides/claude-tool-use-basics),收到 name == "memory" 的调用后,你的后端需要根据 input["command"] 分发处理并返回纯文本结果:
| 子命令 | 关键输入参数 | 客户端应执行的动作与返回格式 |
|---|---|---|
view | path、可选 view_range | 若是目录,列出其下文件名与子目录;若是文件,返回带行号的文件内容(支持按起止行号截取) |
create | path、file_text | 在指定虚拟路径新建或覆盖记忆文件,成功后返回创建确认提示 |
str_replace | path、old_str、new_str | 在目标记忆文件中查找唯一匹配的 old_str 并替换为 new_str;匹配不到或多处匹配时返回 is_error: True |
insert | path、insert_line、new_str | 在第 insert_line 行之后插入新段落(0 表示插在首行前) |
delete | path | 删除已过期的单个记忆文件或子目录,防止旧结论干扰后续任务 |
rename | old_path、new_path | 重命名或移动记忆文件,便于模型整理目录分类 |
如果你想让模型只记某几类特定信息(例如「只记客户的编码规范与数据库连接约定,不记闲聊」),可以在请求的 system 提示词里补充两句业务层面的记录准则,它会与内置的 /memories 操作习惯叠加生效。
三、路径安全校验与防污染清单
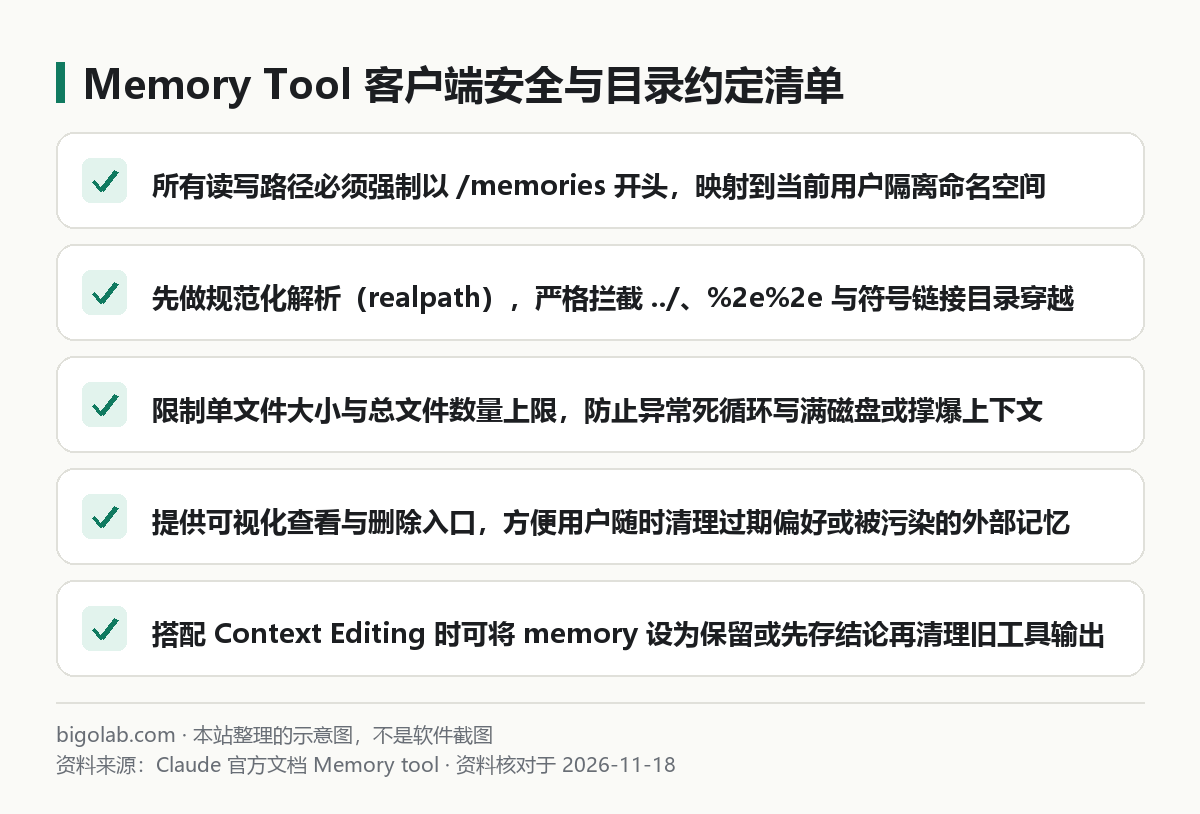
图:本站根据 Claude 官方文档:Memory tool 整理的示意图
因为记忆文件一旦写入就会在未来的新会话里被模型自动读回,官方文档特别提醒开发者在客户端做好四道防护:
- 严格校验虚拟前缀与真实路径:先检查传入的
path(以及rename里的old_path和new_path)是否以/memories开头;拼成宿主机物理路径后再调Path.resolve(),确认解析后的绝对路径确实位于该用户专属目录之下,直接拒绝../、URL 编码%2e%2e和软链接越界:
python
from pathlib import Path

def resolve_safe_memory_path(user_root: Path, virtual_path: str) -> Path:
    if not virtual_path.startswith("/memories"):
        raise ValueError("Path must start with /memories")
    rel = virtual_path[len("/memories"):].lstrip("/")
    target = (user_root / rel).resolve()
    root_resolved = user_root.resolve()
    if target != root_resolved and root_resolved not in target.parents:
        raise ValueError("Path traversal blocked")
return target- 设单文件体积与总配额上限:限制单个记忆文件不超过几十 KB、每个用户目录总大小受控,避免异常循环把大段原始日志原封不动塞进
/memories; - 防范跨会话提示词注入固化:如果智能体同时接入了联网抓取(见 /guides/claude-api-web-search-tool)或读取不受信任的外部邮件,恶意页面可能诱导模型把违规指令写进记忆文件长期潜伏。建议在前端给用户提供「查看并编辑记忆文件」的透明面板;
- 现成开发框架选型:如果你是围绕本地代码仓库做开发辅助,其实无需自己实现这套存储层——官方命令行工具已经内置了项目指令与自动记忆机制(详见 /guides/claude-code-getting-started),日常个人开发直接搭配 Claude Pro 订阅 或 Claude Code 充值方案 即可开箱使用。
常见问题
问:用了 Memory Tool 之后,当前会话的上下文窗口会自动变小吗?
答:不会直接缩小当前轮次的对话历史。记忆工具解决的是「把关键结论安全存到会话外部」以及「跨会话复用」;想把当前长对话里已经读完的旧工具输出清掉省 token,需要配合 Context Editing(上下文编辑)一起使用。
问:底层不想写磁盘文件,存在关系型数据库里可以吗?
答:完全可以。Claude 只关心发出的 view、create、str_replace 等命令能不能收到符合文件目录逻辑的文本响应,后端用数据库表模拟路径树反而更方便做多实例横向扩容与备份。
问:为什么有时新开对话模型没有读取某个子文件夹里的笔记?
答:模型开局通常先 view 顶层 /memories 目录列表,再挑文件名相关的打开细读。建议通过系统提示词引导模型起直观的文件名(如 api_conventions.md),或维护一份简短的 /memories/index.md 索引。
问:人在国内没有外币信用卡,怎么订阅或升级 Claude 付费套餐?
答:可在本站 AI 会员充值总览页 选择 Claude Pro 自助充值 或 Claude Max 充值,付款后即时发卡密、24 小时自助兑换且可开具增值税发票;实时价格与售后边界(含封号不质保)以商品页当天展示为准。
相关教程
- Claude 记忆功能怎么用:开启、查看、导入与导出记忆
- Claude Tool Use(工具调用 / Function Calling)入门:定义工具与返回 tool_result
- Claude API 联网搜索工具(web search tool)怎么用
- Claude Code 中文入门教程(2026):安装、登录、第一个任务、常用命令
参考资料
- Claude 开发者平台文档:Memory tool — https://platform.claude.com/docs/en/agents-and-tools/tool-use/memory-tool
0 条评论
还没有评论,来抢沙发~