
本文根据 OpenAI 官方《File inputs》整理,资料核对于 2026-11-05。配图为本站整理的示意图,不是界面截图。代码里的模型名取自官方当天示例,请以官方模型页为准。本站(bigolab.com)不是 OpenAI 官方网站。API 是按用量计费的独立服务,与 ChatGPT 订阅分开计算,Key 的获取见 /guides/openai-api-key。
适用于谁
- 想让模型总结合同、论文、报表、说明书等文件的开发者;
- 已经跑通第一个请求(见 /guides/openai-api-python-quickstart),但没传过文件的人;
- 只会传图片、不知道文件怎么传的人,图片的写法见 /guides/openai-api-image-input。
结论先说
- 文件用
input_file这种输入项传,放在content数组里,和input_text并排。 - 三种传法:已经上传到 Files API 的
file_id、公开网址file_url、base64 的file_data(要配filename)。 - 用于模型输入的上传,purpose 填
user_data。 - 单个文件须小于 50 MB,同一请求里所有文件合计不超过 50 MB。
- PDF 会同时送文字和页面图像,所以 token 用量会比纯文本高;文件很多、很大时,官方建议改用文件搜索,而不是整份塞进请求。
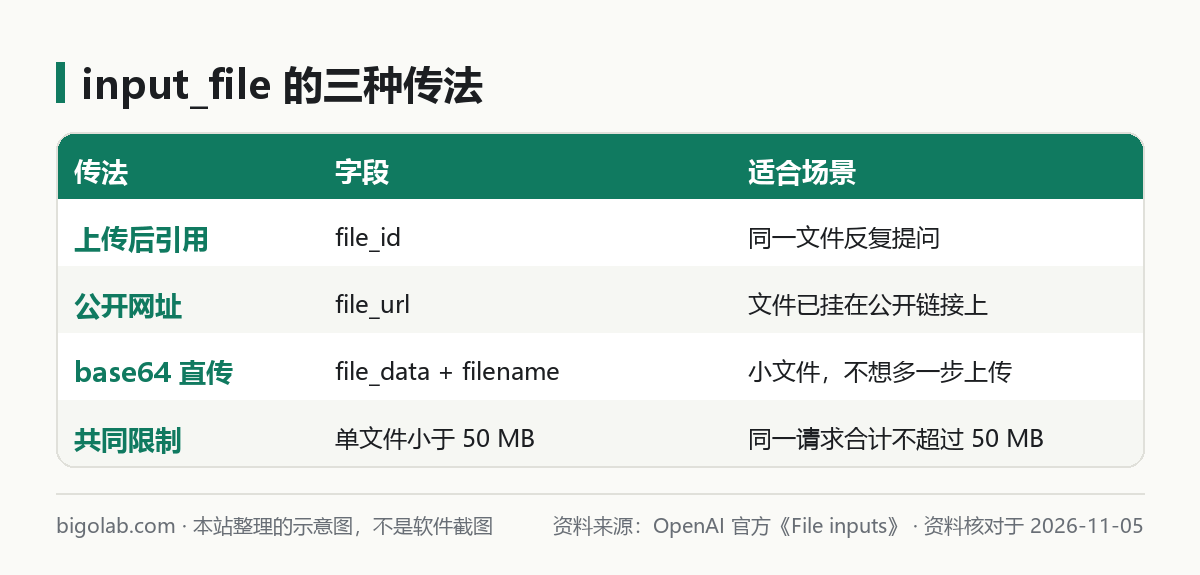
图:本站根据 OpenAI 官方《File inputs》 整理的示意图
一、三种传法对比
官方的对照表可以概括成这样:
| 传法 | 字段 | Responses API | Chat Completions |
|---|---|---|---|
| base64 数据 | file_data + filename | 支持各类文件 | 只支持 PDF |
| 已上传的文件 ID | file_id | 支持各类文件 | 只支持 PDF |
| 外部网址 | file_url | 支持各类文件 | 不支持 |
官方的原话意思是:非 PDF 文件的输入请用 Responses API。如果你一定要在 Chat Completions 里读非 PDF 文件的文字,办法是在自己的程序里先把内容读出来,作为 text 内容部件发过去。
三个字段的含义:
file_id:用 Files API 上传后拿到的文件编号;file_url:公开可访问的文件网址,服务器能直接拉取;file_data:base64 编码的文件内容,格式是 data URI,例如data:application/pdf;base64,...,同时要写filename,例如document.pdf。
二、方式一:先上传,再用 file_id
上传时 purpose 填 user_data。官方说其他受支持的 purpose 也能用,但这个是专门给“当作模型输入”的文件准备的。
python
from openai import OpenAI

client = OpenAI()

# 1. 上传
uploaded = client.files.create(
    file=open("report.pdf", "rb"),
    purpose="user_data",
)

# 2. 在请求里引用
response = client.responses.create(
    model="gpt-6-astra",  # 以官方模型页当天为准
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_file", "file_id": uploaded.id},
                {"type": "input_text", "text": "请用五句话总结这份文件。"},
            ],
        }
    ],
)
print(response.output_text)
同一份文件要问很多次时,先上传再用 file_id 最省事:不用每次都把整个文件编码、传输一遍。
三、方式二:base64 直接带上
文件很小、不想多一次上传,可以直接把内容编码放进请求。别忘了 filename。
python
import base64
from openai import OpenAI

client = OpenAI()

with open("report.pdf", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

response = client.responses.create(
    model="gpt-6-astra",
    input=[
        {
            "role": "user",
            "content": [
                {
                    "type": "input_file",
                    "filename": "report.pdf",
                    "file_data": f"data:application/pdf;base64,{b64}",
                },
                {"type": "input_text", "text": "这份报告的三个主要结论是什么?"},
            ],
        }
    ],
)
print(response.output_text)
base64 会让请求体变大,所以要留意前面说的 50 MB 总量限制。
四、方式三:给公开网址 file_url
文件本来就挂在公开网址上,最简单。下面是 Node.js 写法,保存为 .mjs 运行:
javascript
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6-astra", // 以官方模型页当天为准
  input: [
    {
      role: "user",
      content: [
        { type: "input_file", file_url: "https://example.com/report.pdf" },
        { type: "input_text", text: "请列出这份文件里的所有日期和金额。" },
      ],
    },
  ],
});
console.log(response.output_text);
网址必须是服务器能访问到的公开地址。需要登录才能打开的链接,模型拉不到,这种情况请改用上传。Node 里上传文件的写法是 openai.files.create({ file: fs.createReadStream("report.pdf"), purpose: "user_data" }),Node SDK 的基础用法见 /guides/openai-api-nodejs-quickstart。
五、不同文件,模型实际“看到”什么
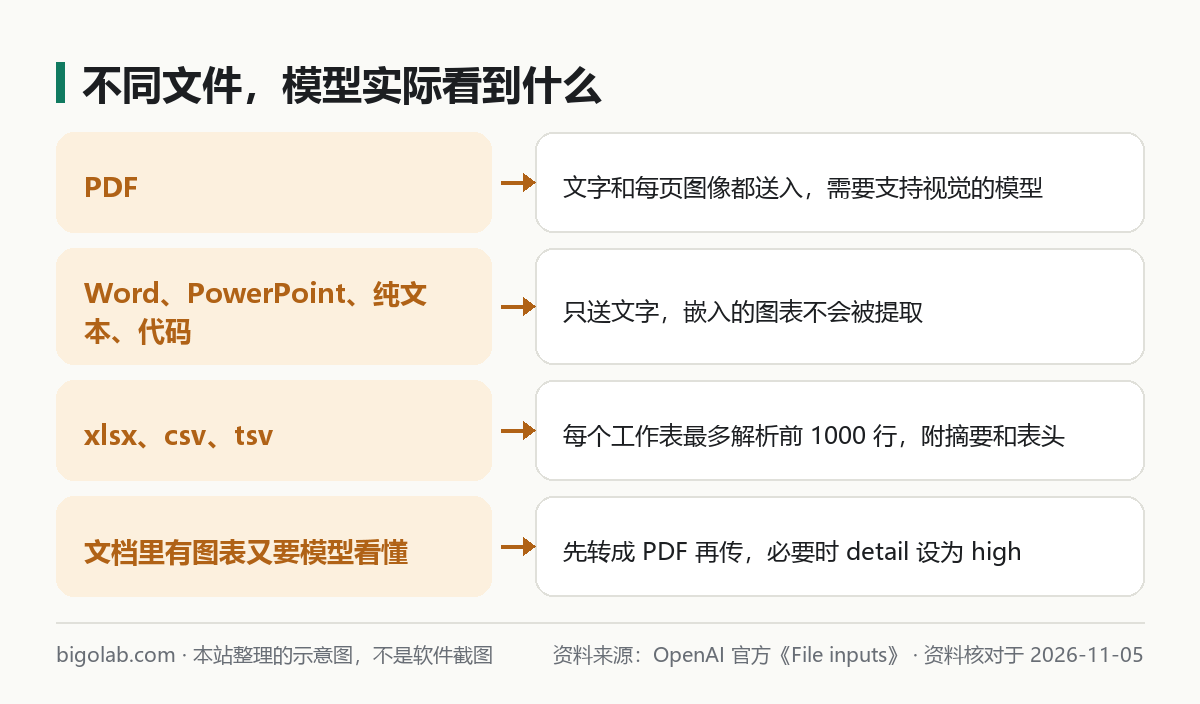
图:本站根据 OpenAI 官方《File inputs》 整理的示意图
官方按类型说明了处理方式:
- PDF:文字和每页的图像都会送给模型,所以需要支持视觉的模型(官方举例
gpt-4o及之后的模型); - Word、PowerPoint、纯文本、代码文件等:只送文字,文件里嵌入的图片和图表不会被提取;
- 表格(xlsx、csv、tsv):每个工作表最多解析前 1000 行,并附上模型生成的摘要和表头信息。
两个实用推论:
- 文档里有图表、示意图而你需要模型看懂,先转成 PDF 再传;
- 表格行数很多、要做关联、汇总、画图,官方的建议是用托管 shell 做复杂处理,而不是靠这种输入方式。
六、detail 参数:控制 PDF 页面图像的精细程度
detail 是可选的,只影响 PDF 页面图像,取值 auto、low、high,默认 auto:
low:用更少的输入 token;high:给密集图表、小字、示意图更多细节;auto:官方写的是在 GPT-5.6 及更新模型上按high,更早的模型按low。
detail 不改变提取出来的文字,文字总是会送入。Chat Completions 不支持这个参数。
七、费用和选择
PDF 的文字和页面图像都进上下文,token 用量会上升。官方的提醒是上线前先看价格和 token 影响。价格以官方价格页当天为准,参见 /guides/openai-api-price-official-table,粗估办法见 /guides/openai-api-token-count-estimate。
如果你有一大堆文档要反复查询,整份塞进每个请求既贵又慢。官方在这里的建议是改用文件搜索(File Search):先把文档放进向量库,由检索挑出相关片段。这个工具本文不展开。
常见问题
Q:为什么提示文件太大?
单个文件须小于 50 MB,同一请求内合计不超过 50 MB。拆成几个请求,或者拆分文件。具体报错信息官方页面没有逐条列出,错误码的整体排查见 /guides/openai-api-error-codes。
Q:Chat Completions 能传 Word 文件吗?
官方表格里它只支持 PDF。其他类型请用 Responses API,或者自己读出文字再发。
Q:模型没看到文档里的图表?
非 PDF 文档只送文字。先转成 PDF 再传,并考虑把 detail 设为 high。
Q:想让模型边读边流式输出?
文件输入和流式可以搭配,流式的写法见 /guides/openai-api-streaming。
参考资料
- OpenAI 官方:File inputs — https://developers.openai.com/api/docs/guides/file-inputs
0 条评论
还没有评论,来抢沙发~