
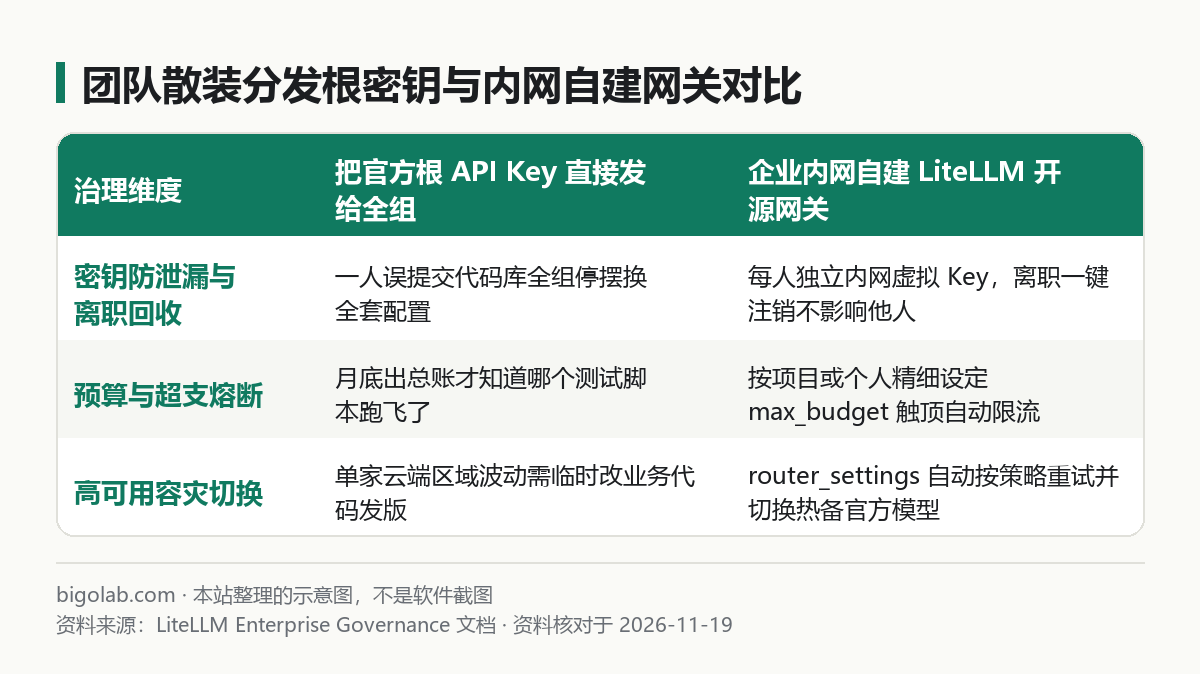
當一家公司的研發團隊從兩三個人試水 AI 擴展到二三十人日常在後端服務、Continue 插件 或 OpenCode 終端 裏調用大模型時,工程主管往往會陷入兩難:如果直接把公司財務綁卡申請的 Anthropic、OpenAI、Google 官方根密鑰(Root API Key)群發給全員,一旦有人手滑把 .env 提交到外部代碼倉,全公司所有線上服務都得跟着停機換鑰;而且月底拿到一張混在一起的總帳單,根本查不清到底是哪個自動化腳本死循環燒超了預算。
GitHub 高星開源網關 LiteLLM(Proxy Server) 正是解決企業內網多模型治理的工業級標準組件:你把它私有化部署在公司自己的內網伺服器上,向上對接企業合規持有的各家官方 API 與內網自建的 vLLM 開源推理集群,向下用統一的兼容格式給每位員工簽發帶獨立配額上限的內部虛擬密鑰(Virtual Keys)。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
一、編寫 litellm_config.yaml:統一模型別名與自動故障切換
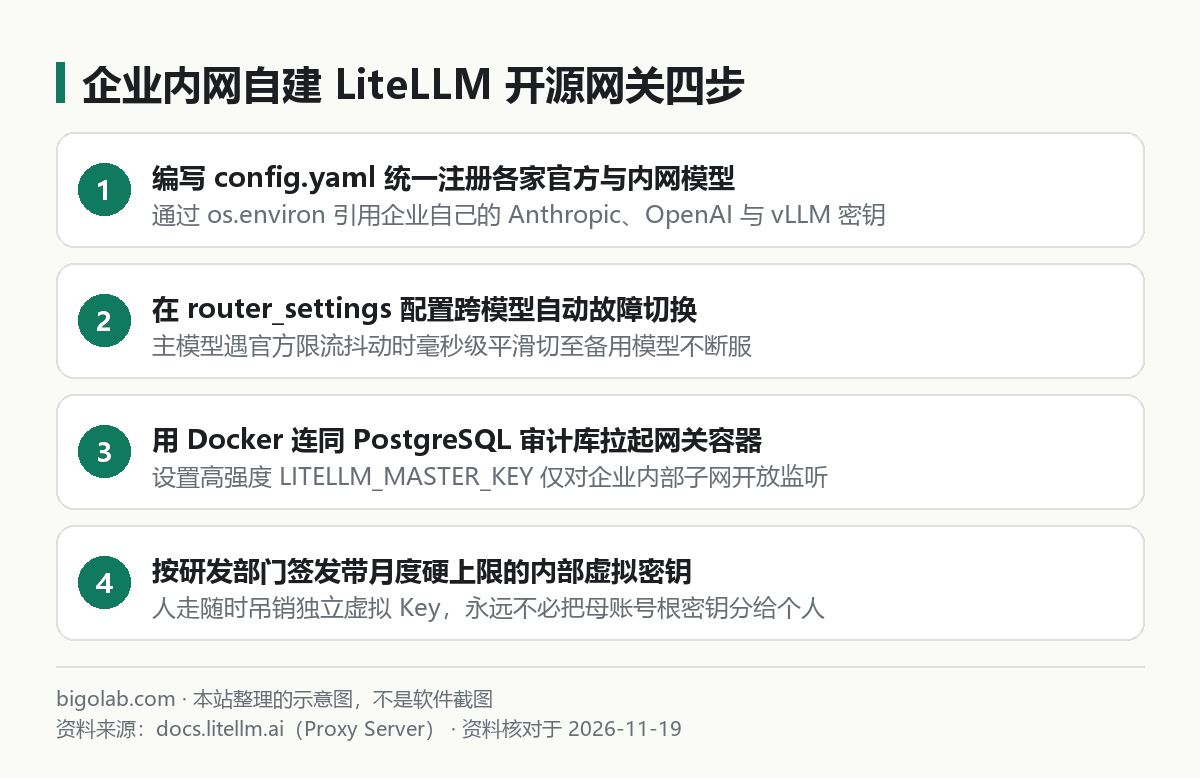
在企業內網伺服器上新建一個部署目錄,創建核心路由配置文件 litellm_config.yaml。所有真實的官方母帳號密鑰一律通過 os.environ/變量名 從服務端受保護的環境變量讀取,絕不落明文:
yaml
model_list:
  # 1. 主力雲端代碼與推理通道:連接企業官方 Anthropic 帳號
  - model_name: team-coder-main
    litellm_params:
      model: anthropic/claude-sonnet-4-5
      api_key: os.environ/ANTHROPIC_API_KEY

  # 2. 跨廠商熱備通道:連接企業官方 OpenAI / Azure 帳號
  - model_name: team-coder-backup
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY

  # 3. 內網零外發敏感數據通道:連接公司機房自建的 vLLM 服務
  - model_name: internal-local-qwen
    litellm_params:
      model: openai/Qwen/Qwen2.5-Coder-32B-Instruct
      api_base: http://10.0.12.88:8000/v1
      api_key: os.environ/INTERNAL_VLLM_TOKEN

router_settings:
  num_retries: 2
  timeout: 60
  # 當主通道偶發 429 速率觸頂或網絡超時,自動無感切換至熱備官方模型
  fallbacks:
    - {"team-coder-main": ["team-coder-backup"]}

general_settings:
master_key: os.environ/LITELLM_MASTER_KEY這套配置最受運維歡迎的設計在於邏輯模型名解耦:全公司業務代碼和編輯器配置裏寫的模型名永遠是固定的 team-coder-main。下個季度官方發佈了新一代主力模型,管理員只需在網關後台改一行映射重啟,全公司幾十個微服務一行代碼不用動就能平滑完成模型升級。
二、用 Docker Compose 連同審計數據庫一鍵拉起
為了持久化儲存每個部門的消耗明細與虛擬密鑰表,生產內網部署必須掛載一個 PostgreSQL 數據庫實例。在同目錄創建 docker-compose.yml:
yaml
services:
  litellm-proxy:
    image: ghcr.io/berriai/litellm:main-stable
    ports:
      - "127.0.0.1:4000:4000" # 建議通過內網反向代理或僅綁定內部子網網卡暴露
    volumes:
      - ./litellm_config.yaml:/app/config.yaml:ro
    environment:
      DATABASE_URL: "postgresql://llmadmin:StrongDbPass@litellm-db:5432/litellm"
      LITELLM_MASTER_KEY: "sk-internal-master-請替換為高強度隨機長串"
      ANTHROPIC_API_KEY: "${ANTHROPIC_API_KEY}"
      OPENAI_API_KEY: "${OPENAI_API_KEY}"
      INTERNAL_VLLM_TOKEN: "${INTERNAL_VLLM_TOKEN}"
    command: ["--config", "/app/config.yaml", "--port", "4000"]
    depends_on:
      - litellm-db

  litellm-db:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: llmadmin
      POSTGRES_PASSWORD: StrongDbPass
      POSTGRES_DB: litellm
    volumes:
      - pgdata:/var/lib/postgresql/data

volumes:
  pgdata:
運行 docker compose up -d 啟動後,訪問內網管理面板 http://內網地址:4000/ui 輸入管理員主密鑰即可看到可視化監控儀表盤。
研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、簽發帶月度預算硬頂的內部虛擬密鑰(Virtual Keys)
管理員主密鑰(LITELLM_MASTER_KEY)只留給運維後台自己用,絕對不發給任何開發者或業務容器。給前端組或實習生分配權限時,通過管理後台 UI 或調用 /key/generate 管理接口簽發受控子密鑰:
bash
curl -X POST "http://127.0.0.1:4000/key/generate" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "key_alias": "frontend-team-ci",
    "models": ["team-coder-main", "internal-local-qwen"],
    "max_budget": 50.0,
    "budget_duration": "30d",
    "rpm_limit": 60
  }'
拿到返回的內網專屬 sk-... 虛擬密鑰後,該團隊只能訪問白名單裏指定的兩個模型,每分鐘並發不得超過 60 次,且 30 天週期內一旦累計消耗觸及設定的預算上限網關就會自動攔截熔斷,徹底杜絕測試腳本寫錯死循環把公司母帳號刷爆的驚魂時刻;人員調崗或離職時一鍵吊銷該虛擬 Key 即可。
對於不想自己維護內網網關數據庫、只想給核心工程師配備獨立固定包月額度的中小研發團隊,直接按人頭開通官方原生開發訂閱往往比管 API 池更省運維人力。需要正規開通海外開發者訂閱的團隊與個人,可前往查看貝果研究社 Claude Code 訂閱與配置方案或全站 AI 訂閱自助導航。
常見問題
LiteLLM 自建網關絕對不能踩的安全與合規紅線是什麼?
第一,嚴禁將網關端口裸露在無鑑權公網或把虛擬密鑰對外違規轉售分租——各家海外大模型廠商的服務條款均嚴格規定企業 API 僅供本組織內部業務系統與員工合規調用;第二,LITELLM_MASTER_KEY 必須使用密碼生成器生成 32 位以上高熵隨機字符串,切勿沿用文檔示例裏的預設弱口令(曾有多起公網裸奔網關因使用預設 sk-1234 主密鑰在幾分鐘內被掃描盜刷的真實教訓)。
開啟代理層轉發後,會給流式出字速度增加明顯延遲嗎?
在內網千兆局域網環境下,LiteLLM 本身的路由鑑權與協議轉換開銷通常只有幾毫秒,相較於大模型首字推理動輒幾百毫秒的耗時幾乎無感;如果你在高並發生產場景追求極致吞吐,可在啟動參數中調增 --num_workers 進程數並掛載內網 Redis 緩存鑑權狀態。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 企業多人協作切忌群發官方根 API Key,在內網自建 LiteLLM 開源網關可統一收攏官方雲端接口與本地 vLLM 服務。
- 利用
router_settings.fallbacks與邏輯模型別名,實現單點限流自動切熱備模型以及業務零改碼平滑升級底座。 - 嚴守內網隔離與高強度主密鑰安全紅線,按項目組與個人簽發限定
models、rpm_limit與max_budget的獨立虛擬密鑰。
0 條評論
還沒有評論,來搶沙發~