
在 Java 後端扎堆的 IntelliJ IDEA 或前端常用的 VS Code 裏,開源擴展 Continue 之所以一直是“自帶密鑰(BYOK)”開發者的心頭好,核心在於它允許你像拼積木一樣拆解模型分工:側邊欄深度重構調用最聰明的旗艦雲端模型,而每秒都在觸發的打字行內補全則交給零成本、毫秒級響應的輕量 FIM(Fill-in-the-Middle)專用模型。
之前在介紹如何把 DeepSeek API 接入 VS Code 時簡單提到了 Continue,但新版 Continue 已經全面從早期的 config.json 升級到了結構更清晰的 config.yaml。這篇教學把它的角色拆分、密鑰保護與跨 IDE 同步一次講透。
本站開發者訂閱直達入口:高頻跑多文件重構與工具鏈調用時,搭配固定月費的主力訂閱往往比純燒按量 API 更省錢。國內無境外信用卡可通過支付寶、微信支付或 AlipayHK 在本站免密自助開通 Claude Code 訂閱(Pro / Max)、ChatGPT Plus 或瀏覽 AI 會員充值總覽。
一、搞懂 roles 角色分工:別拿旗艦推理模型硬跑自動補全
很多新手裝上 Continue 後只填了一個旗艦大模型,結果打字時等兩三秒才蹦出一行灰色續寫,月底一看帳單還被高頻觸發的補全請求吃掉一大截。在 config.yaml 裏,每個模型條目都必須通過 roles 數組明確劃定職責邊界:
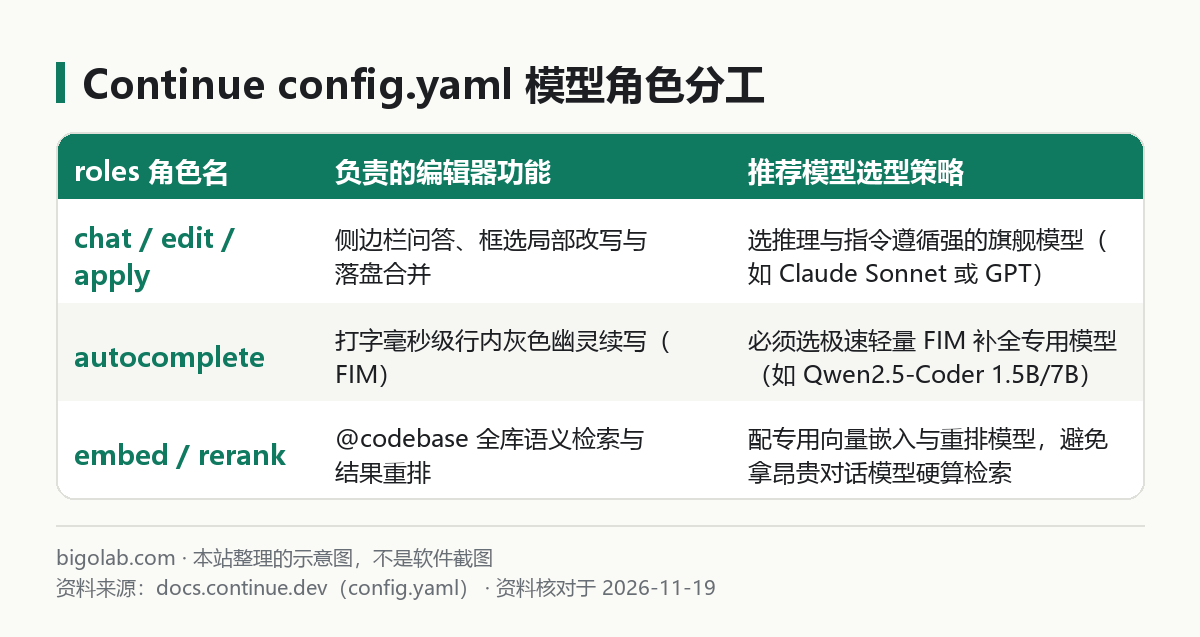
黃金搭配公式非常明確:
chat+edit+apply:交給指令遵循與跨文件邏輯最強的官方旗艦模型(例如 Anthropic Claude Sonnet 或 OpenAI 主力模型),只在你主動提問或按Ctrl+I(IDEA 為Ctrl+J)框選改代碼時計費。autocomplete:單獨配給專門訓練過“中間填空(FIM)”能力的小尺寸代碼模型(例如本機 Ollama 跑qwen2.5-coder:1.5b/7b,或雲端極速 Codestral 模型)。如果省略不寫roles,Continue 預設不會把模型用於autocomplete,這也是很多人配完發現打字沒灰色提示的原因。embed:驅動@codebase與@docs本地向量檢索,掛一個輕量本地嵌入模型(如nomic-embed-text)即可免去雲端檢索開銷。
二、~/.continue/config.yaml 完整實戰模板
無論你在 VS Code 還是 JetBrains 系列 IDE(IntelliJ IDEA、PyCharm、GoLand)裏安裝了 Continue 擴展,它們預設都讀取用戶主目錄下的同一份全局配置文件:
- macOS / Linux:
~/.continue/config.yaml - Windows:
%USERPROFILE%\.continue\config.yaml
點擊 Continue 側邊欄右上角的小齒輪圖標即可直接打開該文件。下面是一份可以直接複用的“雲端強腦對話 + 本地極速免費補全 + MCP 掛載”標準配置:
yaml
name: Fullstack Mix Config
version: 1.0.0
schema: v1

models:
  # 1. 主力對話與改寫模型:使用官方雲端旗艦 API
  - name: Claude Sonnet (Chat & Edit)
    provider: anthropic
    model: claude-sonnet-4-5
    apiKey: ${{ secrets.ANTHROPIC_API_KEY }}
    roles:
      - chat
      - edit
      - apply

  # 2. 毫秒級行內補全模型:調用本機 Ollama 跑輕量 FIM 模型
  - name: Local Qwen Coder Autocomplete
    provider: ollama
    model: qwen2.5-coder:1.5b
    apiBase: http://localhost:11434
    roles:
      - autocomplete

  # 3. 本地代碼庫語義檢索向量模型
  - name: Local Nomic Embed
    provider: ollama
    model: nomic-embed-text:latest
    roles:
      - embed

rules:
  - 生成代碼優先遵循當前文件已有的命名風格與錯誤處理約定,不要輸出多餘的寒暄解釋。
  - 修改 TypeScript 文件時嚴禁引入顯式 any 類型。

mcpServers:
  - name: filesystem-docs
    command: npx
    args:
      - -y
      - "@modelcontextprotocol/server-filesystem"
      - ./docs
配置裏的 ${{ secrets.ANTHROPIC_API_KEY }} 會從同目錄下的本地環境變量文件(~/.continue/.env)或系統密鑰庫讀取真實鍵值,防止你截屏分享配置或備份倉庫時泄露明文 Key。如果你還沒在本機裝好本地推理服務,可以先照着 Ollama 安裝與常用命令指南跑一句 ollama pull qwen2.5-coder:1.5b 和 ollama pull nomic-embed-text。
重度編碼配額與雙引擎互補建議:在開源插件或終端智能體裏處理大型單體倉庫時,不少工程師會同時備好一套包月封頂的官方訂閱兜底複雜架構攻堅。可按需前往查看 Claude Max 5x / 20x 充值說明、Claude Pro iOS 自助卡密 或 ChatGPT Pro 充值頁。
三、在 VS Code 與 IDEA 之間無縫協同的四步要點
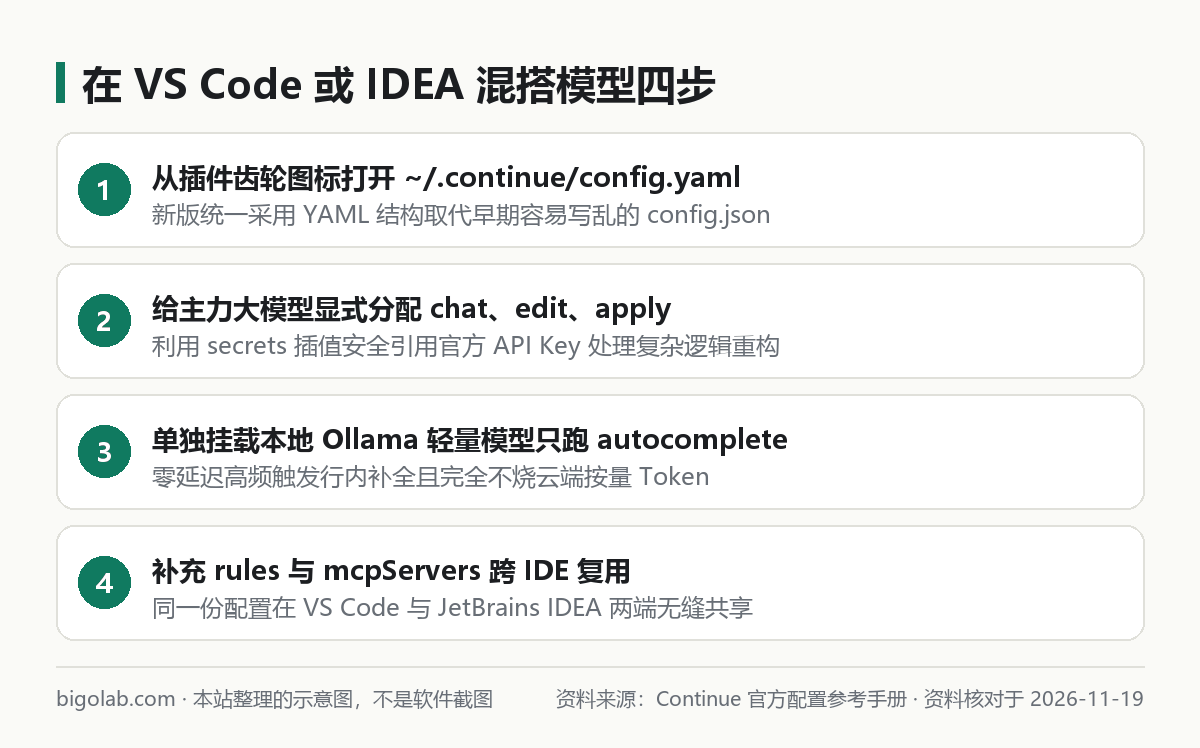
對於前後端雙開的工程師(前端開 VS Code 寫 React,後端開 IntelliJ IDEA 寫 Spring Boot),Continue 最大的省心之處在於改一次全局 config.yaml,兩個 IDE 同時生效。日常使用再留意三個細節:
- JetBrains IDEA 快捷鍵衝突微調:在 IDEA 裏經常碰到插件行內改寫快捷鍵與系統自帶智能提示打架(正如配置 IDEA 版 GitHub Copilot 插件 時常見的鍵位衝突)。建議進入 IDEA 的
Settings -> Keymap,搜尋Continue,把展開側邊欄與內聯編輯綁到不衝突的組合鍵上。 - 項目級
.continue/rules/覆蓋團隊規範:全局config.yaml裏的rules只管你個人習慣;對於具體業務倉庫的框架約束,可以在項目根目錄下創建.continue/rules/*.md提交到 Git,團隊成員打開倉庫自動疊加生效。 - 調優深度思考模型的補全延遲:如果你把帶有長鏈思考(Thinking)的混合模型拿來做快速局部編輯,覺得等待前奏太久,可以在該模型的
requestOptions下通過額外請求體參數關閉非必要的冗長思考過程,專心用於複雜架構問答。
當然,自己折騰多套按量 API 密鑰加本地顯卡模型適合喜歡高度定製的極客;如果你希望在主力生產環境省掉維護本地服務和盯 Token 帳單的精力,直接開通官方一站式固定訂閱會省心很多。需要正規直連訂閱服務的開發者,可前往查看貝果研究社 Claude Code 訂閱與配置方案或 ChatGPT Plus 自助充值專頁。
常見問題
我以前寫的舊版 config.json 升級插件後還能用嗎?
Continue 仍保留了對存量 config.json 的向後兼容讀取,但官方所有新特性(如模組化 rules、mcpServers 與 Hub 配置塊組合)均圍繞 config.yaml 構建。當同一目錄下同時存在 .yaml 與 .json 時,系統會優先以 config.yaml 為準,建議趁早遷移過去避免兩邊改亂。
為什麼我的筆記本一開本地 Ollama 跑 7b 補全風扇就狂轉且出字慢?
行內自動補全對首字延遲(TTFT,最好低於 300 毫秒)極其敏感。如果你的輕薄本沒有獨立顯卡或統一內存小於 16GB,跑 7b 模型的實時補全確實會吃力。把 autocomplete 角色換成體量極小的 qwen2.5-coder:1.5b,內存佔用僅 1GB 出頭,敲代碼時的流暢度反而遠勝跑不動的大參數模型。
國內沒有海外信用卡,怎麼開通 Claude Code 或 ChatGPT 編程訂閱?
可直接在 本站充值中心 使用支付寶、微信支付或 AlipayHK 下單獲取自助卡密,支持免上號兌換 Claude Pro、Claude Max 與 ChatGPT Plus / Pro,可開具增值稅發票;實時價格、兌換前提與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 新版 Continue 統一在
~/.continue/config.yaml中管理配置,一份文件即可同時驅動 VS Code 與 JetBrains IDEA。 - 務必通過
roles把重度對話重構(chat/edit/apply)與高頻行內填空(autocomplete)拆給不同量級的模型,兼顧代碼質素與零延遲省錢。 - 善用
${{ secrets.變量名 }}隔離敏感 API Key,並把團隊業務約束放進項目級.continue/rules/目錄隨倉庫共享。
0 條評論
還沒有評論,來搶沙發~