
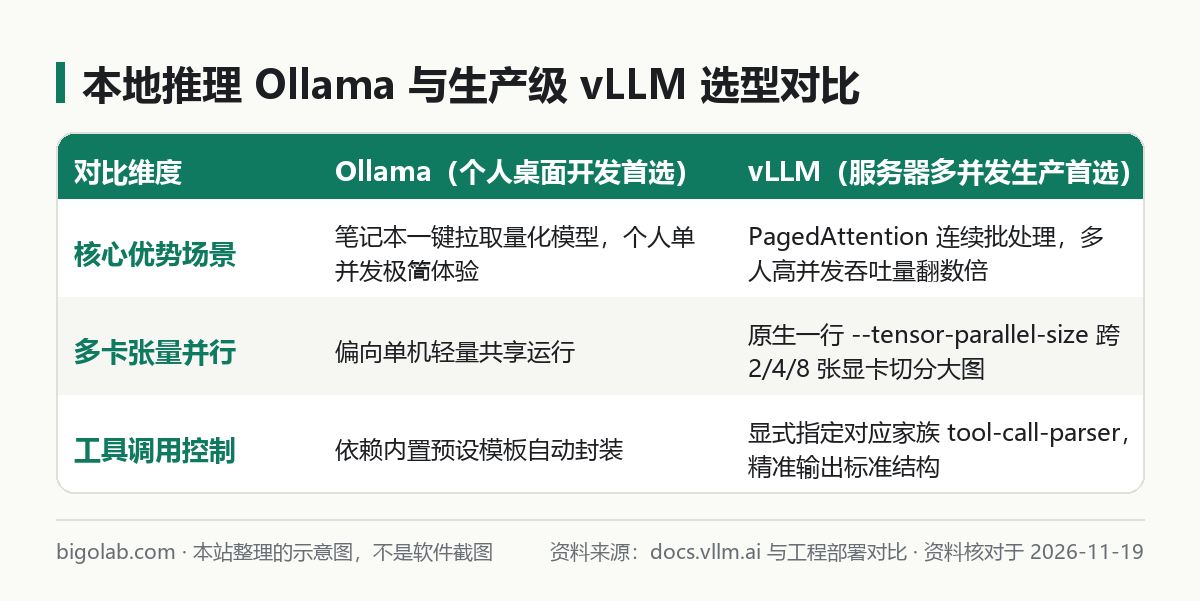
在自己筆記本上嚐鮮跑開源模型,用一鍵安裝的 Ollama 本地工具 最省事;但一旦你要在團隊 GPU 伺服器上給十幾名同事同時提供內網代碼補全、或者用本地模型支撐高並發智能體工作流(如 LangGraph 本地模型編排),單並發導向的輕量工具很快就會出現排隊卡死。
生產級開源推理引擎 vLLM 憑藉核心的 PagedAttention(分頁注意力顯存管理) 與連續批處理(Continuous Batching)技術,能在同等顯卡硬件上把多並發吞吐量翻好幾倍,並原生暴露 100% 兼容 OpenAI 規範的 HTTP 接口。下面帶你算清顯存帳、跑通多卡服務並開啟智能體必備的原生工具調用(Tool Calling)。
AI 全棧開發訂閱配套入口:在本地部署與聯調開源 AI 框架時,搭配固定月費的終端編程智能體與旗艦推理訂閱能大幅縮短排錯時間。國內無境外信用卡可在本站通過支付寶、微信支付或 AlipayHK 免密自助開通 Claude Code 訂閱、ChatGPT Plus / Pro 或查看 AI 會員充值總覽。
一、拉鏡像動手前:三秒算清你的顯卡夠不夠裝
很多新手看了一眼模型參數量(比如 14B 或 32B),覺得半精度權重剛好塞進 24GB 顯存就硬拉服務,結果一啟動直接報 CUDA out of memory。用 vLLM 部署前,請按這條實戰口訣留足餘量:
- 半精度(BF16 / FP16)原版權重:
約等於 參數量(B) × 2 GB(例如 14B 模型光靜態權重就要佔掉約28 GB顯存;32B 模型約佔64 GB)。 - 4-bit 量化權重(AWQ / GPTQ):
約等於 參數量(B) × 0.6~0.7 GB(例如 32B AWQ 量化版靜態權重約佔19~21 GB,單張 24GB 的 RTX 4090 就能裝下)。 - 必須額外留出 20%~30% 給 KV Cache(上下文激活顯存):並發人數越多、
--max-model-len設得越長,動態吃掉的緩存就越大。切忌把權重卡在顯存上限的 98%。
二、用 vllm serve 一鍵啟動 OpenAI 兼容服務端
在裝好 NVIDIA 驅動與 CUDA 的 Linux 伺服器(或 Windows WSL2)上,推薦使用 uv 創建乾淨的 Python 虛擬環境安裝,或直接拉取官方 Docker 鏡像 vllm/vllm-openai:latest:
bash
uv venv vllm-env --python 3.11
source vllm-env/bin/activate
uv pip install vllm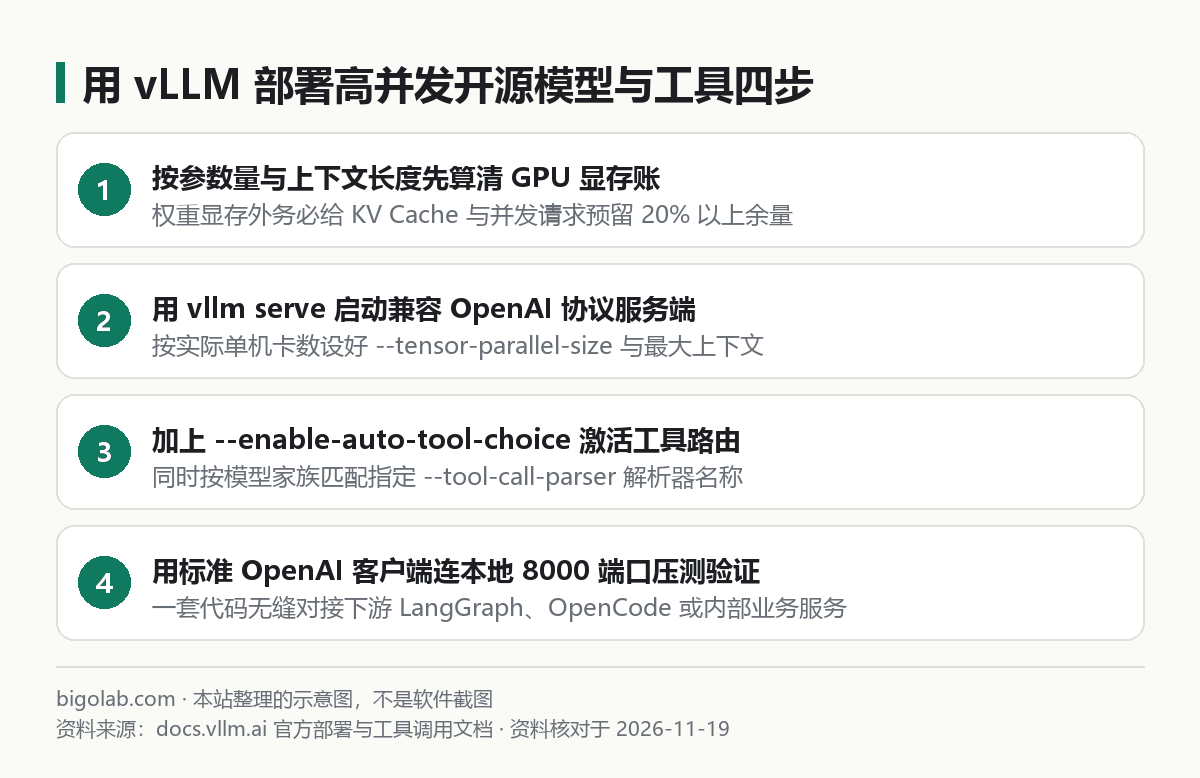
下面是一條生產內網最穩健的 vllm serve 啟動命令模板(以部署 Qwen2.5-Coder 或同級別主流指令模型、雙卡並行且開啟 API 鑑權為例):
bash
vllm serve Qwen/Qwen2.5-Coder-32B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --api-key "internal-team-secret-token" \
  --tensor-parallel-size 2 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.90 \
  --enable-auto-tool-choice \
  --tool-call-parser hermes
把這幾個決定生死的核心參數徹底看懂,能少踩無數坑:
--tensor-parallel-size 2:單張顯卡裝不下時,設為機器上的實際 GPU 數量(通常為 2、4 或 8),vLLM 會自動把模型矩陣跨卡切分並行計算。--max-model-len 32768:很多開源模型出廠配置文件預設寫了 128K 上下文,如果你只有單卡 24G 顯存不限制這個值,啟動自檢時就會直接提示 KV Cache 空間不足退出。按業務實際需求壓到16384或32768立馬就能順利跑起來。--gpu-memory-utilization 0.90:預設預分配當前顯卡 90% 的總顯存用於權重和分頁緩存池;如果同一張卡上還跑着輕量 Embedding 模型,務必調低到0.70左右防搶顯存崩潰。
研發團隊訂閱與高配額省心方案:調試複雜多步智能體循環、RAG 切片策略與 CI 評測流水線非常消耗單日 Token。個人主力開發推薦免上號兌換 Claude Pro iOS 自助卡密 或 5 倍額度的 Claude Max 5x,多人研發團隊協同亦可聯絡客服定製 ChatGPT Business 團隊版。
三、關鍵一步:開啟原生函數工具調用(Tool Calling)
如果你用 vLLM 對接智能體框架或終端編程插件,明明客戶端傳了 tools 數組,服務端卻直接報錯 400 Bad Request 或者把函數 JSON 當普通純文本吐在 content 裏,百分之百是因為啟動命令漏配了工具解析開關:
- 必須加
--enable-auto-tool-choice:允許服務端接收tool_choice="auto"請求,由模型自主判斷當前這輪是直接聊天還是觸發外部函數。 - 必須按模型家族配對
--tool-call-parser:不同開源家族訓練時輸出的特殊標記不同,常見配對關係如下:
- Qwen2.5 / Hermes 風格模型:傳
hermes(新一代 Qwen3 系列按版本傳對應qwen3_xml等官方解析器名)。 - Llama 3.1 / 3.3 系列模型:傳
llama3_json。 - Mistral 系列模型:傳
mistral。
服務跑起來後,任何原本調用雲端接口或調用本地兼容接口的代碼一行邏輯都不用改,直接連上 http://伺服器IP:8000/v1 即可驗證工具調用:
python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="internal-team-secret-token",
)

resp = client.chat.completions.create(
    model="Qwen/Qwen2.5-Coder-32B-Instruct",
    messages=[{"role": "user", "content": "幫我查一下訂單號 ORD-8821 的當前物流節點"}],
    tools=[{
        "type": "function",
        "function": {
            "name": "get_order_status",
            "description": "根據訂單編號查詢實時物流狀態",
            "parameters": {
                "type": "object",
                "properties": {"order_id": {"type": "string"}},
                "required": ["order_id"]
            }
        }
    }],
)
print(resp.choices[0].message.tool_calls)
在企業混合架構裏,常規高頻數據批處理與內網敏感文本用自建 vLLM 兜底最省成本,而複雜系統架構設計與疑難代碼攻堅則搭配雲端最頂級的閉源旗艦訂閱互補提效。需要開通海外官方開發訂閱的團隊與個人,可前往查看貝果研究社 Claude Code 訂閱與配置方案或 ChatGPT Plus 自助充值專頁。
常見問題
在國內伺服器執行 vllm serve 拉取 Hugging Face 權重速度極慢或連接超時怎麼辦?
切忌在 vllm serve 啟動瞬間邊下幾十 GB 權重邊初始化引擎。更穩妥的工程習慣是先使用命令行下載工具將完整的模型文件夾穩穩下載到伺服器高速固態硬碟目錄(例如 /data/models/Qwen2.5-Coder-32B),隨後直接運行 vllm serve /data/models/Qwen2.5-Coder-32B --served-model-name qwen-coder,離線秒啟動且模型別名乾淨整潔。
為什麼我用 Windows 原生系統直接 pip install vllm 裝不上?
vLLM 底層重度依賴針對 Linux 編譯的高性能 CUDA 算子與分佈式通信庫(NCCL),官方原生不支持直接在純 Windows 命令提示符下運行。如果你手頭是裝了 RTX 4090 的 Windows 工作站,只需開啟 WSL2(Ubuntu 22.04/24.04) 或使用支持 GPU 直通的 Docker Desktop,就能在子系統內滿血運行 vLLM。
搭好開源框架後,國內沒有外幣信用卡怎麼開通主力編程與大模型訂閱?
可在 本站 AI 會員充值中心 使用支付寶、微信支付或 AlipayHK 自助選購卡密,支持免交密碼兌換 Claude Code(Pro / Max)、ChatGPT Plus 與 ChatGPT Pro,並支持開具增值稅發票;實時價格與售後邊界(封號不在質保範圍)以對應商品頁說明為準。
小結
- 部署前按“參數量乘係數 + 至少兩成 KV Cache 餘量”估算顯存,顯存吃緊時優先選用 AWQ 4-bit 量化權重並收斂
--max-model-len。 - 使用
vllm serve配合--tensor-parallel-size即可快速拉起高吞吐多卡 OpenAI 兼容 API 服務並綁定內網鑑權密鑰。 - 跑智能體業務務必同時加上
--enable-auto-tool-choice與對應模型家族的--tool-call-parser,才能輸出標準結構化tool_calls。
0 條評論
還沒有評論,來搶沙發~